
NoSQL 与搜索 / 系统课时
估算 Heap 与 Page Cache 预算
估算 Heap 与 Page Cache 预算
数据节点的内存不能简单地“越多给 JVM 越好”。本课把总内存拆成 Heap、JVM/本地内存、操作系统 Page Cache 与安全余量,并用节点观测数据校正预算,最终得到可用于选型和扩容的单节点内存模型。
学习目标
- 区分 JVM Heap 与操作系统 Page Cache 各自承载的 Elasticsearch 工作负载
- 根据节点总内存、热数据工作集和运行余量估算可用缓存空间
- 用节点统计与操作系统指标验证预算是否合理
从总内存拆出四个预算池
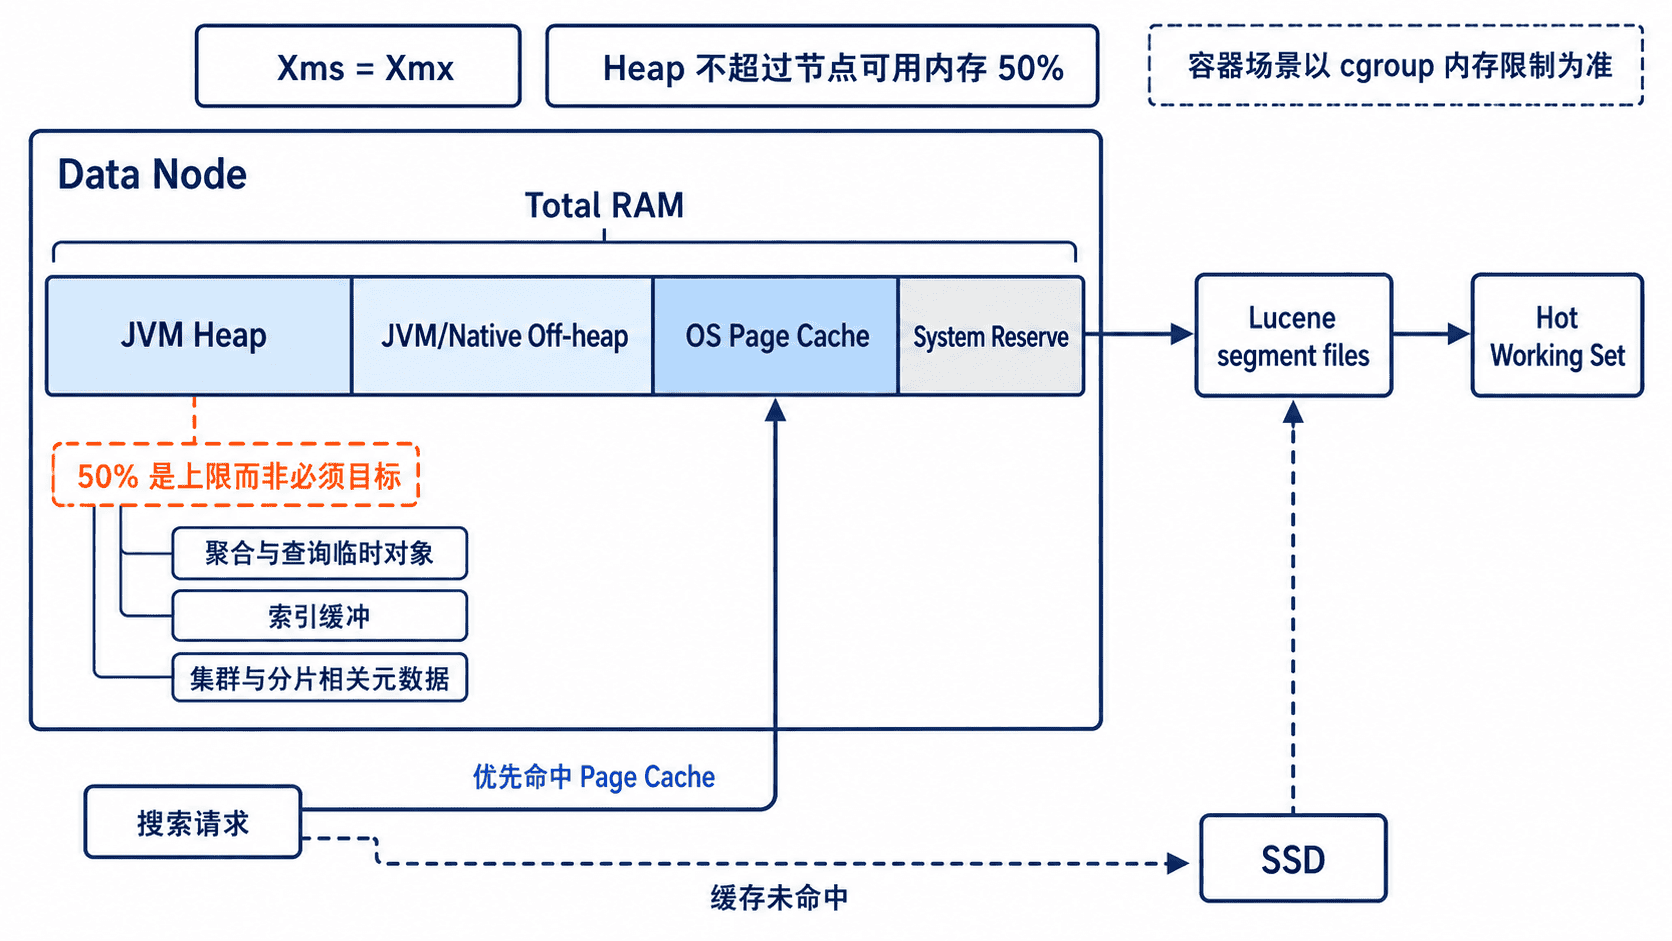
Elasticsearch 默认会根据节点角色和可用内存自动设置 JVM Heap,生产环境通常应先保留这一机制。确需手工设置时,Xms 与 Xmx 应保持相等,Heap 不应超过 Elasticsearch 实际可用内存的 50%;容器部署时这里的“可用内存”指容器限制,而不是宿主机物理内存。
剩余内存并不是浪费。Lucene 的段文件主要依赖操作系统 filesystem cache,搜索命中热段时可以避免实际磁盘读取;网络缓冲、JVM 自身和其他本地结构也会消耗 Heap 之外的内存。因此更实用的预算关系是:
其中 M_reserve 用于操作系统、监控代理以及突发本地内存需求。不要用索引总大小直接推导 Heap:索引文件是否能高效读取,主要取决于热工作集能否进入 Page Cache,而不是 JVM 能否容纳全部数据。
用热工作集而不是索引总量估算 Page Cache
先确定“峰值时真正会被频繁读取的 Lucene 数据”有多大。时间序列检索通常由最近若干小时或若干天的数据主导;商品检索则可能长期访问较稳定的热门分片。把这些活跃分片的频繁访问区域视为热工作集,再按分片分布换算到单节点。
例如一台 64 GiB 数据节点,经压测后计划使用 24 GiB Heap,并为本地内存与系统进程预留 8 GiB,则理论上约有 32 GiB 可由操作系统用于文件缓存。若单节点峰值热工作集明显大于这个数,继续增大 Heap 只会进一步挤压缓存;更合理的动作通常是增加节点、降低单节点热分片量,或调整冷热数据布局。
这个估算不是“缓存必须装下 100% 热数据”的硬规则。最终目标是让目标查询延迟在稳定负载下满足 SLO,并且不会出现持续磁盘随机读、交换或 GC 压力。
用节点统计校正 Heap 预算
下面的只读请求同时查看 Heap、机器内存、交换区和文件系统剩余空间。示例需要设置 Elasticsearch 地址与 API Key,调用账号至少应具备集群监控权限。
export ES_URL="https://<HOST>:<PORT>"
export ELASTIC_API_KEY="<API_KEY>"

curl -sS \
  -H "Authorization: ApiKey ${ELASTIC_API_KEY}" \
  "${ES_URL}/_nodes/stats/jvm,os,fs?filter_path=nodes.*.name,nodes.*.jvm.mem.heap_used_percent,nodes.*.jvm.mem.heap_max_in_bytes,nodes.*.os.mem.total_in_bytes,nodes.*.os.swap.used_in_bytes,nodes.*.fs.total.available_in_bytes"
预期输出中每个节点都会出现对应字段,实际节点 ID 与数值不同:
{
  "nodes": {
    "<ID>": {
      "name": "<NODE>",
      "jvm": {"mem": {"heap_used_percent": <VALUE>, "heap_max_in_bytes": <VALUE>}},
      "os": {"mem": {"total_in_bytes": <VALUE>}, "swap": {"used_in_bytes": <VALUE>}},
      "fs": {"total": {"available_in_bytes": <VALUE>}}
    }
  }
}
单次 heap_used_percent 不能决定是否扩 Heap。应观察业务峰值下的长期 Heap 曲线、GC 停顿、breaker 触发与索引/搜索延迟;同时在宿主机或容器监控中查看 filesystem cache、major page fault、磁盘读取延迟和 swap。容器环境还要以实际 memory limit 为预算基准,不要把宿主机总内存当成 Elasticsearch 可用内存。若 Heap 长期有余量而磁盘读持续偏高,优先考虑给 Page Cache 更多空间,而不是把剩余 RAM 继续划给 JVM。
用验收条件决定是否扩容
内存预算通过验收至少要同时满足三件事:峰值业务下 Heap 不持续顶满且 GC 可恢复到健康水位;系统没有持续 swap;目标查询在热身后不会因为 Page Cache 抖动产生明显尾延迟。任何一项失败,都说明“总内存够用”这个结论还不成立。
当 Heap 压力主要来自高基数字段聚合、过多分片或高并发请求时,应先治理工作负载;当 Heap 健康但热查询仍频繁落盘时,应增加文件缓存或降低每节点热数据量。把 Heap 和 Page Cache 分开预算,才能避免用一种内存去解决另一种内存的问题。