
NoSQL 与搜索 / 系统课时
设计 RPO/RTO 与恢复演练
设计 RPO/RTO 与恢复演练
RPO/RTO 只有被换算成快照频率、可恢复数据点、恢复吞吐和可计时的演练步骤,才是可执行的灾备目标。本课用一组容量预算把“多久丢多少数据、多久恢复服务”落到 Elasticsearch 快照策略和恢复验收上。
学习目标
- 把业务 RPO/RTO 转换为快照频率与恢复容量预算
- 区分“主分片可服务”和“集群完全 green”两个恢复里程碑
- 设计可重复计时、可验证并能持续修正参数的恢复演练
把 RPO 和 RTO 写成可测量指标
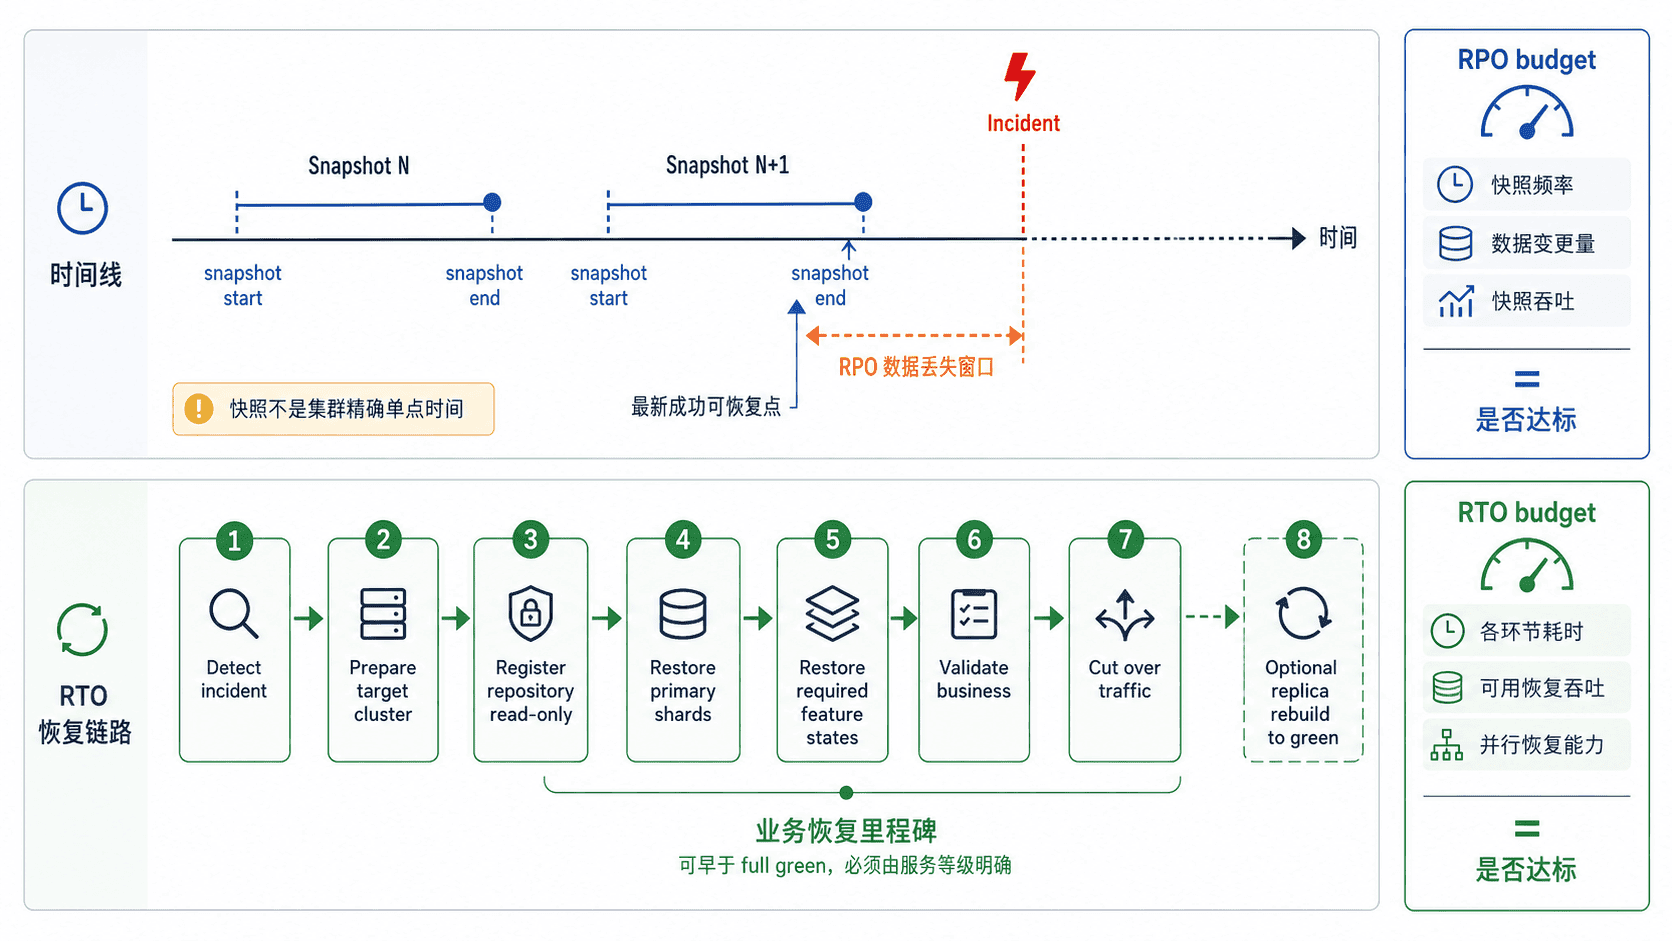
RPO 衡量事故发生时最多允许回退多少数据,实际值可理解为“事故时刻减去最终采用的可恢复数据点”。RTO 衡量从事故发生到业务恢复到约定服务水平所需的时间。两者都必须绑定具体业务,例如订单索引 RPO 15 分钟、搜索 API RTO 60 分钟。
Elasticsearch 快照并不是整个集群某一个精确瞬间的副本;一个快照有开始和结束时间,各 shard 的数据视图落在这个时间窗口内。因此不能简单把“快照结束时间”当成全局一致恢复点。容量设计可用“快照启动间隔 + 快照完成延迟 + 安全余量”做保守估算,最终仍以实际快照时间和恢复演练验证。
用频率和吞吐做一次容量验算
假设订单数据要求 RPO 不超过 15 分钟、业务恢复 RTO 不超过 60 分钟。若快照每 10 分钟启动一次,P95 完成延迟约 3 分钟,再预留 2 分钟安全余量,设计预算约为 15 分钟。这个数字不是协议保证,而是用来发现策略是否明显不达标的容量上限。
RTO 还要看恢复数据量和目标集群能持续达到的有效恢复吞吐。若需要恢复 300 GiB 主分片数据,演练观测到整体有效吞吐约 200 MiB/s,则仅数据传输的粗略时间约为 25.6 分钟。再加事故确认 5 分钟、目标集群准备 8 分钟、必要 Feature State 恢复 3 分钟、业务校验 8 分钟和流量切换 5 分钟,总预算约 55 分钟,才有机会落在 60 分钟内。
| 预算项 | 示例值 | 需要实测的变量 |
|---|---|---|
| 快照启动间隔 | 10 分钟 | SLM 实际触发时间 |
| 快照完成延迟 | P95 3 分钟 | 仓库、网络、shard 数量 |
| 主分片恢复 | 约 25.6 分钟 | 恢复数据量、有效吞吐 |
| 检测与准备 | 13 分钟 | 告警、目标集群可用性 |
| Feature State 恢复 | 3 分钟 | 功能状态大小、依赖范围 |
| 校验与切换 | 13 分钟 | 验收脚本、DNS 或网关切换 |
如果业务要求“所有副本恢复并达到 green 才算恢复”,还必须把副本重建时间加入 RTO;如果业务允许在主分片恢复后先恢复服务,则可把 yellow 作为中间里程碑,但要明确容量和风险边界。
用 API 找到真正可用的恢复点
演练开始时先记录事故时刻,再从仓库中选择事故前最新的成功快照。不要只看“策略应该每十分钟执行一次”,因为失败、延迟或仓库异常都可能让最近一次实际成功时间更早。
GET /_cat/snapshots/prod-repo?format=json&s=end_epoch:desc&h=id,status,start_epoch,end_epoch,duration,successful_shards,failed_shards预期输出:
[
  {
    "id": "snap-<ID>",
    "status": "SUCCESS",
    "start_epoch": "<TIME>",
    "end_epoch": "<TIME>",
    "duration": "<VALUE>",
    "successful_shards": "<VALUE>",
    "failed_shards": "0"
  }
]<ID>、<TIME> 和 <VALUE> 都是动态值。RPO 复盘时应把最终采用快照的实际时间窗口与事故时刻一起记录,而不是只记录 SLM 配置中的理论频率。
把恢复演练拆成固定 Runbook
一次有价值的演练必须覆盖“恢复数据”之外的所有阻塞点:目标资源能否及时创建、仓库是否能从灾备集群读取、版本是否兼容、必要 Feature State 是否齐全、应用能否切换,以及验收脚本能否在限定时间内给出结论。
- 记录事故开始时间,冻结或重定向仍在写入的流量,明确本次恢复范围。
- 选择事故前最新且状态为
SUCCESS的快照,记录其 start/end 时间。 - 准备兼容版本的目标集群,并把原生产仍可能写入的仓库注册为只读。
- 优先恢复业务必需的索引和数据流,再按依赖恢复最小 Feature State。
- 主分片恢复后执行文档数、关键查询、写入和应用健康检查。
- 达到业务恢复标准后切换流量;副本重建与非关键功能可按既定里程碑继续。
- 记录每一步开始/结束时间、失败原因、人工等待时间和实际数据量。
演练不要在生产事故当天第一次执行这些步骤。至少要覆盖“单索引误删”“整个生产集群不可用”“目标区域重建”三类不同故障边界,因为它们的恢复范围和耗时瓶颈并不相同。
用主分片恢复时间校准 RTO
Restore API 使用 shard recovery 恢复主分片。设置 wait_for_completion=true 后,请求会等到主分片恢复尝试完成再返回,因此它适合测量“主分片恢复阶段”的耗时,但仍不等于副本全部恢复或业务已经通过验收。
POST /_snapshot/prod-repo/snap-<ID>/_restore?wait_for_completion=true
{
  "indices": "orders-*",
  "include_global_state": false,
  "feature_states": [
    "none"
  ]
}
预期输出:
{
  "snapshot": {
    "snapshot": "snap-<ID>",
    "indices": ["orders-<VALUE>"],
    "shards": {
      "total": <VALUE>,
      "failed": 0,
      "successful": <VALUE>
    }
  }
}
这里的 <ID> 和 <VALUE> 取决于实际快照与 shard 数量。若 failed 不为 0,不能把该阶段记为成功;即使全部主分片成功,也要继续执行业务查询、Feature State 功能和流量切换验证。
用演练数据反推策略
每次演练至少沉淀四个数字:最新可用快照距事故的时间、主分片恢复耗时、业务校验耗时、完整切换耗时。连续几次演练如果都接近 RPO/RTO 上限,就应提前调整快照频率、仓库带宽、恢复集群容量或恢复范围,而不是继续依赖纸面余量。
真正可交付的灾备方案不是“有快照”,而是能证明某类事故发生后,哪一个快照可用、恢复多少数据、以什么吞吐恢复、何时达到业务服务标准,并且这些时间长期低于承诺的 RPO/RTO。