
NoSQL 与搜索 / 系统课时
用 CCR 构建跨集群灾备
用 CCR 构建跨集群灾备
CCR 适合把持续写入的业务索引复制到另一集群,并在主集群不可用时接管查询与写入。本篇重点不在“把复制打开”,而在划清复制边界、验证跟随状态,并把故障切换与回切设计成不会双写、可演练的流程。
学习目标
- 说明 leader、follower 与 CCR 的复制边界
- 创建并验证 follower index,理解复制延迟对 RPO 的影响
- 设计可控的故障切换、角色反转与回切步骤
先划清 CCR 的灾备边界
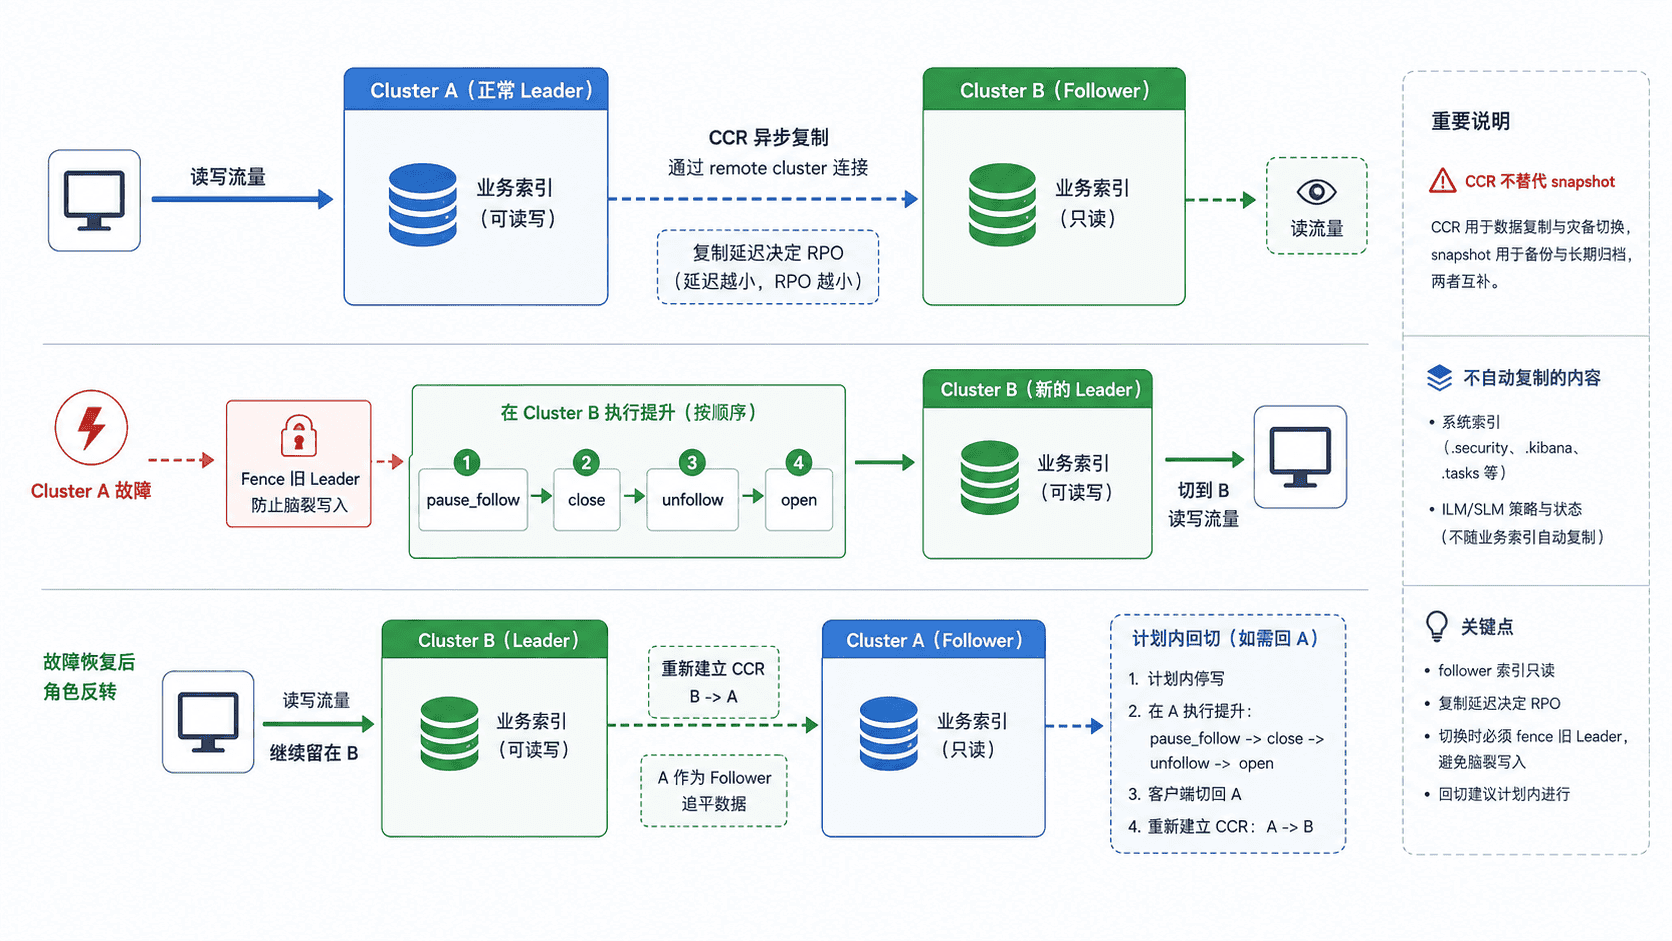
CCR 以索引为复制单元:leader index 接受写入,follower index 从远端 leader 拉取操作并保持同步。正常跟随期间 follower 是只读的,因此“跨集群复制”不等于两个集群同时可写,更不能把两边都开放给写流量。
CCR 主要保护持续变化的用户业务索引。系统生成索引、ILM/SLM 策略、快照仓库配置等并不会因为业务索引在跟随就自动拥有等价副本,所以灾备方案仍要单独备份安全配置、策略与集群级配置。逻辑误删或错误写入也可能被继续复制,因此 CCR 不能替代快照。
建立并验证复制
假设灾备集群已经把生产集群配置为远程集群别名 prod-a,并准备好具有 CCR 所需权限的凭据。在灾备集群创建 customer-orders-dr,让它跟随生产端 customer-orders:
curl -sS -X PUT "$DR_ES/customer-orders-dr/_ccr/follow?wait_for_active_shards=1" -H "Authorization: ApiKey $DR_API_KEY" -H "Content-Type: application/json" -d '{"remote_cluster":"prod-a","leader_index":"customer-orders"}'预期输出:
{"follow_index_created":true,"follow_index_shards_acked":true,"index_following_started":true}这只说明 follower 已建立并开始跟随,不代表复制延迟已经满足灾备目标。持续查看 GET /customer-orders-dr/_ccr/stats,重点观察 leader 与 follower 的全局 checkpoint 是否收敛、最后一次成功读取距今多久,并把“可接受的最大落后量”写成 RPO 门槛。
执行故障切换
单向灾备的核心是先阻止旧 leader 再次接收写入,再提升 follower。网络分区时尤其不能仅凭“主站点不可访问”就假设它已经停止服务,否则两个站点可能各自接受写入,形成无法由 CCR 自动合并的分叉数据。
在灾备集群将 follower 转成普通索引,顺序不能颠倒:
curl -sS -o /dev/null -w 'pause=%{http_code}\n' -X POST "$DR_ES/customer-orders-dr/_ccr/pause_follow" -H "Authorization: ApiKey $DR_API_KEY"
curl -sS -o /dev/null -w 'close=%{http_code}\n' -X POST "$DR_ES/customer-orders-dr/_close" -H "Authorization: ApiKey $DR_API_KEY"
curl -sS -o /dev/null -w 'unfollow=%{http_code}\n' -X POST "$DR_ES/customer-orders-dr/_ccr/unfollow" -H "Authorization: ApiKey $DR_API_KEY"
curl -sS -o /dev/null -w 'open=%{http_code}\n' -X POST "$DR_ES/customer-orders-dr/_open" -H "Authorization: ApiKey $DR_API_KEY"
预期输出:
pause=200
close=200
unfollow=200
open=200
unfollow 是不可逆转换:该索引不再是 follower。随后再把写入端、查询端和消费端统一切到 Cluster B;不要先切写流量再做 unfollow。如果旧 leader 当时不可达,恢复后还应检查并清理遗留的 follower retention lease,避免无意义地保留额外历史。
设计回切而不是“切回去”
Cluster A 恢复后,最稳妥的做法不是立即恢复原拓扑,而是让当前承载写入的 Cluster B 继续做 leader,在 A 删除或换名处理过期副本后重新创建 follower,让 A 从 B 追平。普通索引不能直接原地变成 follower,因此“保留 A 上旧数据并直接继续跟随”不是可用回切方案。
如果业务必须让 A 重新成为主站点,应把它当作一次计划内切换:停止或围住 B 的新写入,确认 A 已追平,提升 A,切换客户端,然后在 B 重建反向 follower。任意时刻只允许一个写入 leader,这条约束比“两个集群都在线”更重要。
用 RPO 与 RTO 验收演练
一次 CCR 灾备演练至少记录三件事:故障发生到入口完成切换的时间作为 RTO;切换时 leader 与 follower 的复制差距作为 RPO;恢复后是否能完成反向跟随且没有双写。再配合定期快照,才能同时覆盖站点故障与逻辑损坏两类风险。