
NoSQL 与搜索 / 系统课时
排查 Yellow 与 Red 集群状态
排查 Yellow 与 Red 集群状态
本课给出一条可直接执行的 Yellow/Red 排障路径:先判断是否有主分片不可用,再锁定受影响索引和 UNASSIGNED 分片,最后用 Allocation Explain 读取真正的分配阻塞原因。这样可以避免一上来改副本数或强制 reroute,把症状隐藏成更大的可用性风险。
学习目标
- 根据
unassigned_primary_shards区分 Yellow 降级与 Red 数据不可用。 - 从索引、分片逐级缩小范围,并使用 Allocation Explain 定位 decider。
- 针对磁盘、分配规则、节点丢失和无有效副本等根因安全修复。
先判断影响级别
Yellow 表示所有 primary 都已分配,但至少一个 replica 未分配;数据通常仍可访问,不过冗余能力下降。Red 表示至少一个 primary 未分配,受影响索引的部分数据不可用,搜索或写入可能失败。排障时先确认 primary 是否缺失,不要只盯着颜色。
先采集集群健康和红黄索引。将连接信息中的占位符替换为实际值。
ES_URL="https://localhost:9200"
CACERT="<PATH>/http_ca.crt"
ES_USER="elastic"
ES_PASSWORD="<PASSWORD>"
AUTH=(-u "$ES_USER:$ES_PASSWORD" --cacert "$CACERT")

curl -sS "${AUTH[@]}" "$ES_URL/_cluster/health?filter_path=status,unassigned_shards,unassigned_primary_shards,delayed_unassigned_shards"
curl -sS "${AUTH[@]}" "$ES_URL/_cat/indices?health=red&format=json&h=health,index,status,pri,rep&s=index"
curl -sS "${AUTH[@]}" "$ES_URL/_cat/indices?health=yellow&format=json&h=health,index,status,pri,rep&s=index"
预期输出结构如下;没有对应颜色的索引时,CAT API 会返回空数组:
{"status":"<VALUE>","unassigned_shards":<VALUE>,"unassigned_primary_shards":<VALUE>,"delayed_unassigned_shards":<VALUE>}
[{"health":"red","index":"<INDEX>","status":"open","pri":"<VALUE>","rep":"<VALUE>"}]
[{"health":"yellow","index":"<INDEX>","status":"open","pri":"<VALUE>","rep":"<VALUE>"}]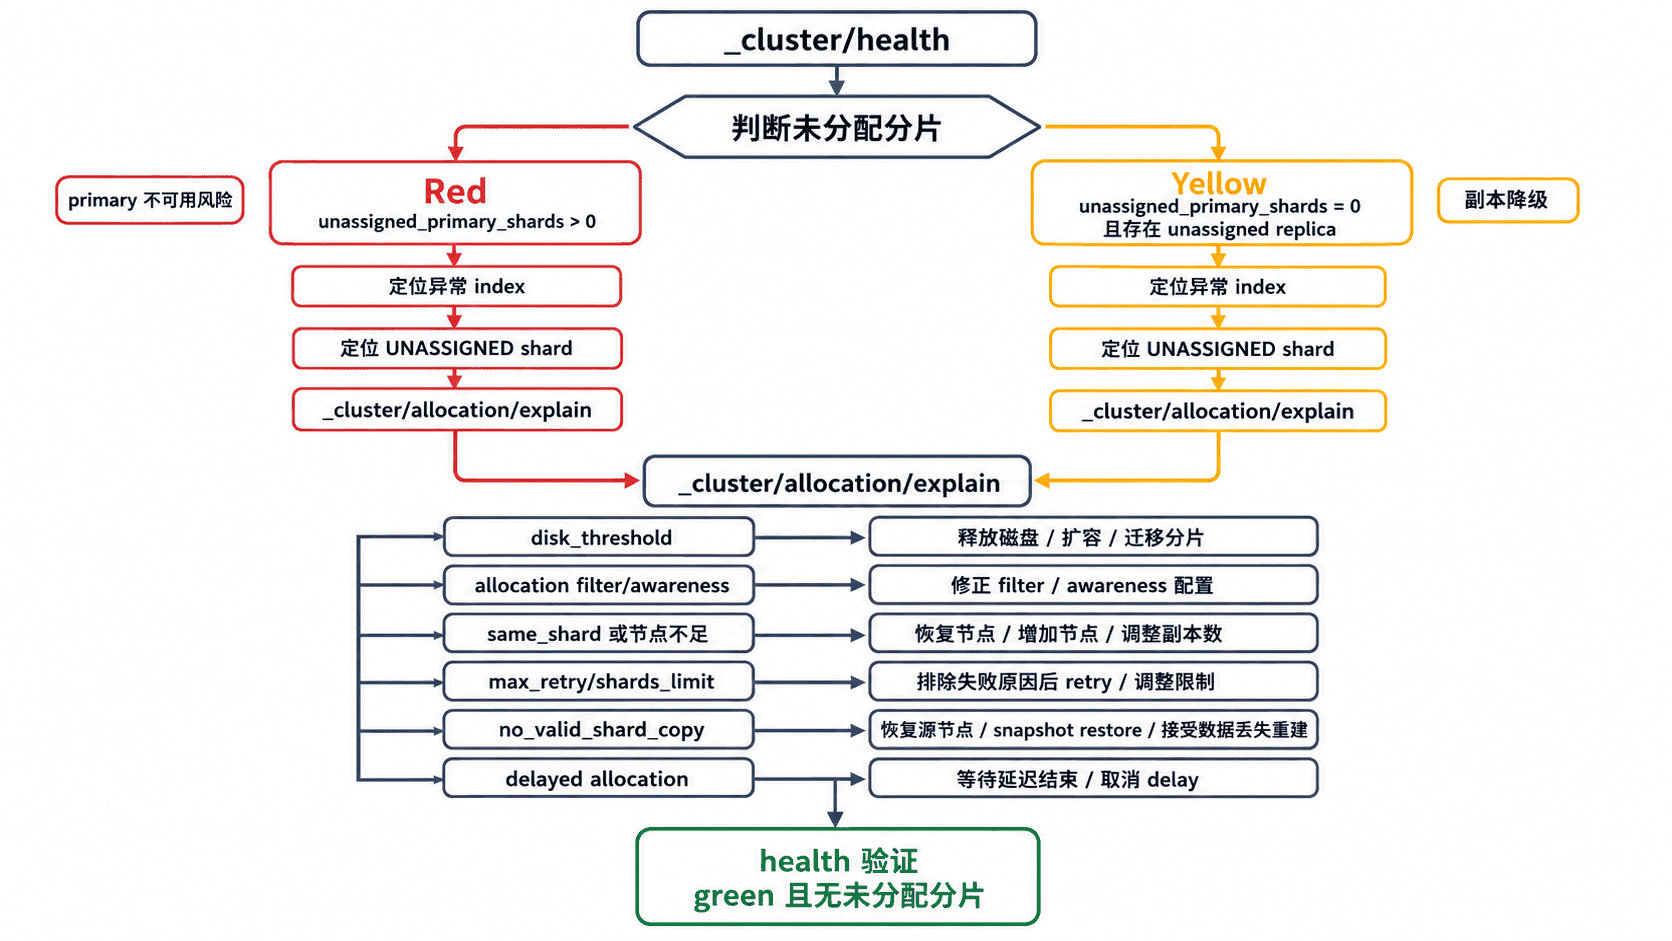
从索引缩到具体分片
从上一步选一个受影响索引,把 <INDEX> 替换为实际名称。prirep 为 p 表示 primary,为 r 表示 replica;真正需要继续解释的是 state=UNASSIGNED 的行。
INDEX="<INDEX>"
curl -sS "${AUTH[@]}" "$ES_URL/_cat/shards/$INDEX?format=json&h=index,shard,prirep,state,node,unassigned.reason&s=state,shard"
预期输出中会看到类似结构:
[
  {
    "index": "<INDEX>",
    "shard": "<ID>",
    "prirep": "p",
    "state": "UNASSIGNED",
    "node": null,
    "unassigned.reason": "<VALUE>"
  }
]
unassigned.reason 说明“为什么进入未分配状态”,例如节点离开或索引创建,但它不一定说明“为什么现在仍然不能分配”。后者要交给 Allocation Explain。
用 Allocation Explain 读取阻塞原因
选中一个 UNASSIGNED shard,把 <INDEX>、<ID> 替换为上一步真实值,并根据 prirep 设置 PRIMARY:primary 用 true,replica 用 false。
INDEX="<INDEX>"
SHARD_ID="<ID>"
PRIMARY=true

curl -sS "${AUTH[@]}" -H "Content-Type: application/json" -X POST "$ES_URL/_cluster/allocation/explain?include_yes_decisions=false&filter_path=index,shard,primary,current_state,unassigned_info.reason,unassigned_info.last_allocation_status,can_allocate,allocate_explanation,node_allocation_decisions.node_name,node_allocation_decisions.node_decision,node_allocation_decisions.deciders.*" -d "$(printf '{"index":"%s","shard":%s,"primary":%s}' "$INDEX" "$SHARD_ID" "$PRIMARY")"
预期响应结构如下,具体 decider 和 explanation 取决于根因:
{
  "index": "<INDEX>",
  "shard": <ID>,
  "primary": true,
  "current_state": "unassigned",
  "unassigned_info": {
    "reason": "<VALUE>",
    "last_allocation_status": "<VALUE>"
  },
  "can_allocate": "<VALUE>",
  "allocate_explanation": "<VALUE>",
  "node_allocation_decisions": [
    {
      "node_name": "<VALUE>",
      "node_decision": "no",
      "deciders": [
        {
          "decider": "<VALUE>",
          "decision": "NO",
          "explanation": "<VALUE>"
        }
      ]
    }
  ]
}
不要猜根因,优先读 can_allocate、last_allocation_status 和每个节点的 deciders。它们会告诉你是“没有合格节点”,还是“节点有资格但某项硬条件阻止了分配”。
按根因修复而不是改颜色
Yellow 的常见根因是副本无处可放:单节点集群配置了 replica、目标 data tier 节点不足、allocation awareness/filter 不满足,或磁盘/分片限制阻止分配。生产高可用集群通常应补足可承载副本的节点或修正规则,而不是为了变绿直接把副本数降为 0。
Red 要先判断 primary 的有效副本还在不在。如果只是原节点暂时离线,恢复节点后 Elasticsearch 通常会继续分配;如果 Allocation Explain 给出 no_valid_shard_copy,应优先恢复包含有效副本的节点、从 snapshot 恢复,或从原始数据源重新构建。强制分配 stale/empty primary 可能造成数据丢失,只有明确接受损失时才应进入这类操作。
| Explain 线索 | 常见根因 | 修复方向 |
|---|---|---|
disk_threshold |
合格节点磁盘水位过高 | 释放空间、扩容或迁移数据 |
| allocation filter / awareness | 节点属性或 tier 不满足 | 修正规则或增加符合条件的节点 |
same_shard |
primary 与 replica 不能同节点 | 增加可用数据节点 |
shards_limit |
节点或索引分片上限阻止分配 | 先减少分片或增加容量,再评估限制 |
max_retry |
同一分片多次恢复失败 | 修复底层错误后再重试失败分配 |
no_valid_shard_copy |
没有可恢复的 in-sync copy | 恢复原节点、snapshot 或原始数据 |
验证恢复到稳定状态
修复后可以让健康 API 等待 Green,并同时要求没有 initializing 或 relocating shard。若 60 秒仍超时,不要反复 reroute,回到 Allocation Explain 查看剩余 UNASSIGNED shard。
curl -sS "${AUTH[@]}" "$ES_URL/_cluster/health?wait_for_status=green&wait_for_no_initializing_shards=true&wait_for_no_relocating_shards=true&timeout=60s&filter_path=timed_out,status,initializing_shards,relocating_shards,unassigned_shards,unassigned_primary_shards"稳定恢复后的预期结果为:
{
  "timed_out": false,
  "status": "green",
  "relocating_shards": 0,
  "initializing_shards": 0,
  "unassigned_shards": 0,
  "unassigned_primary_shards": 0
}
真正的验收标准不是颜色被“改绿”,而是所有主副分片都有合理去处、导致未分配的根因已经消失,并且节点再次故障时仍保留预期的冗余能力。