
NoSQL 与搜索 / 系统课时
定义生产集群 SLI 与故障边界
定义生产集群 SLI 与故障边界
生产运维不能只盯着 /_cluster/health 是否为 green。本课把用户可感知的可用性、搜索延迟、写入成功率和恢复能力拆成可计算的 SLI,并划清用户体验、集群内部健康与数据恢复三层边界,让告警和故障升级都有统一口径。
学习目标
- 为可用性、延迟、写入和恢复能力定义可计算的 SLI。
- 区分用户侧 SLI 与 cluster health、节点资源、分片状态等诊断指标。
- 用 Elasticsearch 监控 API 验证集群风险,并把风险映射到故障等级。
先把 SLI 写成可计算口径
SLI 是“实际测到了什么”,SLO 才是“希望它达到多少”。生产环境先固定统计窗口、流量范围和成功条件,再设置目标值;否则同一个“99.9% 可用性”可能因排除规则不同而得到完全不同的结果。
| SLI | 推荐测量点 | 计算口径 | 关键边界 |
|---|---|---|---|
| 搜索可用性 | 客户端或入口网关 | 成功搜索请求数 / 有效搜索请求总数 | 429、5xx 通常应计为服务失败;是否接受部分分片结果必须提前约定 |
| 搜索延迟 | 客户端或入口网关 | 端到端耗时的 P95/P99 | 不要只用 Elasticsearch 内部 took 代替用户端延迟 |
| 写入成功率 | 写入客户端或采集层 | 成功写入条目数 / 有效写入条目数 | Bulk API 即使 HTTP 返回 200,也要按 item 的 status 和 error 判断 |
| 恢复能力 | 恢复演练记录 | 满足 RPO 且满足 RTO 的演练次数 / 总演练次数 | 只有“快照成功”不能证明数据真的可恢复 |
对“有效请求”的排除规则要足够窄,例如可以排除明确属于调用方语法错误的请求,但不能为了让数字好看而排除 429、超时或集群过载造成的失败。延迟也应固定统计口径,例如成功请求与失败请求分开观察,避免大量快速失败把 P95 人为拉低。
把故障边界落到三层
第一层是用户边界:只看请求是否成功、是否足够快、写入是否得到符合业务契约的确认。第二层是集群边界:分片未分配、节点离线、队列堆积、GC、磁盘水位等指标用于说明风险和根因。第三层是恢复边界:当在线副本已经无法兜底时,快照与恢复演练决定数据能否在目标时间内重新提供服务。
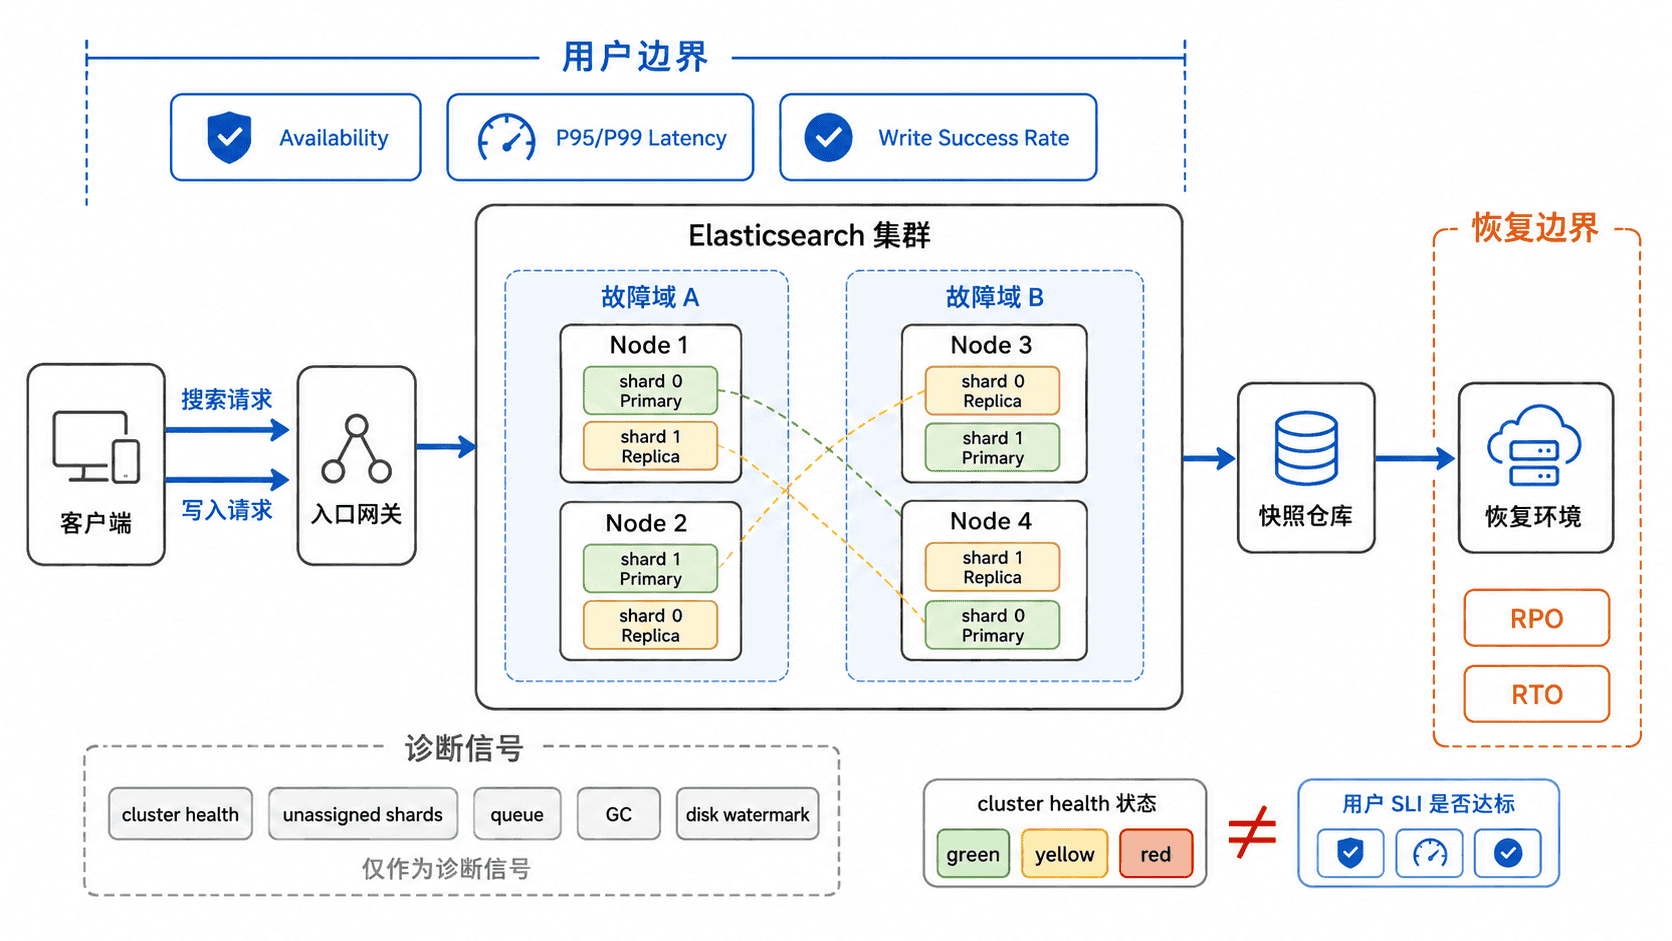
green 表示所有分片已分配,yellow 表示主分片已分配但至少一个副本未分配,red 表示至少一个主分片未分配。它们描述的是分片分配状态,不是端到端服务质量:yellow 时业务可能仍能读写,但容错余量已经下降;red 时也可能只是部分索引受影响。:contentReference[oaicite:0]{index=0}
用集群 API 采集诊断信号
下面的只读探针适合接入巡检脚本或监控采集器。API Key 至少需要集群 monitor 权限;把 <ES_URL> 和 <API_KEY> 替换为实际值,返回中的节点数等动态字段会随环境变化。
export ELASTICSEARCH_URL="<ES_URL>"
export ELASTIC_API_KEY="<API_KEY>"

curl -sS \
  -H "Authorization: ApiKey ${ELASTIC_API_KEY}" \
  "${ELASTICSEARCH_URL}/_cluster/health?pretty&filter_path=status,timed_out,number_of_nodes,unassigned_primary_shards,unassigned_shards,number_of_pending_tasks"
预期输出
{
  "status" : "green",
  "timed_out" : false,
  "number_of_nodes" : <VALUE>,
  "unassigned_shards" : 0,
  "number_of_pending_tasks" : 0,
  "unassigned_primary_shards" : 0
}
这个结果只能证明采样时刻的分片分配与集群任务状态。真正的 SLI 仍应从请求入口统计;当可用性或延迟越过 SLO 时,再用 /_cluster/health、节点统计、线程池、磁盘和分片分配信息缩小根因范围,而不是反过来用 green 作为“业务正常”的充分条件。
把恢复能力变成可验证目标
恢复能力至少要记录两个实际值:RPO_actual = 故障时刻 - 最新成功恢复的数据时刻,以及 RTO_actual = 服务重新可用时刻 - 服务中断时刻。实际落表时建议直接保存故障开始、最新恢复数据、恢复完成和应用验收通过四个时间点,再由监控系统计算结果,避免人工填写“达标/不达标”。
恢复 SLO 不应只检查快照任务状态。定期在隔离环境执行恢复,验证索引能打开、关键文档可查询、写入链路可恢复,并把 RPO_actual <= RPO_target 与 RTO_actual <= RTO_target 同时作为通过条件。这样在线 SLI、内部故障信号和灾备能力才形成闭环:用户指标决定是否发生服务事件,内部指标帮助定位,恢复指标决定最坏情况下能否回到可接受状态。