
NoSQL 与搜索 / 系统课时
控制 Shard Fan-out
控制 Shard Fan-out
Shard fan-out 决定一次搜索要在多少个分片上执行 query phase,再由协调节点归并结果。控制它的关键不是盲目降低并发,而是先量化目标 shard,再用索引范围、routing 与分片设计减少真正参与搜索的 shard 数。
学习目标
- 能用
_search_shards量化搜索会命中的 shard group 数量。 - 能区分“减少目标 shard”“预过滤跳过 shard”和“限制并发 shard 请求”。
- 能选择 routing、索引范围和集群护栏,避免小分片放大搜索成本。
先量化实际 fan-out
下面建立一个 8 primary shard 的演示索引,并用自定义 routing 写入两个租户。_search_shards 可以直接查看某个索引和 routing 值会路由到哪些 shard group。执行前替换 <PATH> 与 <API_KEY>,API Key 需要具备演示索引的管理、写入和读取权限,并确保已安装 curl 与 jq。
export ES_URL="https://localhost:9200"
export ES_CA="<PATH>"
export ES_API_KEY="<API_KEY>"

curl -sS --cacert "$ES_CA" -H "Authorization: ApiKey $ES_API_KEY" -X DELETE "$ES_URL/fanout-demo" >/dev/null
curl -sS --cacert "$ES_CA" -H "Authorization: ApiKey $ES_API_KEY" -H "Content-Type: application/json" -X PUT "$ES_URL/fanout-demo" -d '{"settings":{"number_of_shards":8,"number_of_replicas":0},"mappings":{"properties":{"tenant":{"type":"keyword"},"message":{"type":"text"}}}}' >/dev/null
curl -sS --cacert "$ES_CA" -H "Authorization: ApiKey $ES_API_KEY" -H "Content-Type: application/x-ndjson" -X POST "$ES_URL/fanout-demo/_bulk?refresh=true&filter_path=errors" --data-binary $'{"index":{"_id":"1","routing":"tenant-a"}}\n{"tenant":"tenant-a","message":"checkout ok"}\n{"index":{"_id":"2","routing":"tenant-b"}}\n{"tenant":"tenant-b","message":"payment ok"}\n'

ALL=$(curl -sS --cacert "$ES_CA" -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/fanout-demo/_search_shards" | jq '.shards | length')
ROUTED=$(curl -sS --cacert "$ES_CA" -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/fanout-demo/_search_shards?routing=tenant-a" | jq '.shards | length')
printf 'all_shard_groups=%s\ntenant_a_shard_groups=%s\n' "$ALL" "$ROUTED"

curl -sS --cacert "$ES_CA" -H "Authorization: ApiKey $ES_API_KEY" -H "Content-Type: application/json" -X POST "$ES_URL/fanout-demo/_search?routing=tenant-a&max_concurrent_shard_requests=2&filter_path=_shards.total,hits.total" -d '{"query":{"term":{"tenant":"tenant-a"}}}'
预期输出:
{"errors":false}
all_shard_groups=8
tenant_a_shard_groups=1
{"_shards":{"total":1},"hits":{"total":{"value":1,"relation":"eq"}}}
没有 routing 时,这个索引的搜索候选范围覆盖 8 个 primary shard group;使用与写入一致的 routing=tenant-a 后,只需搜索由该 routing 值选中的 shard group。副本会增加可选择的 shard copy,但不会让同一 shard group 的所有副本都同时执行这次普通搜索。
区分减少目标与限制并发
一次分布式搜索可以从三个层次控制成本:先减少目标,再让明显不可能命中的 shard 被预过滤跳过,最后才限制同时在途的 shard 请求。三者解决的问题不同。
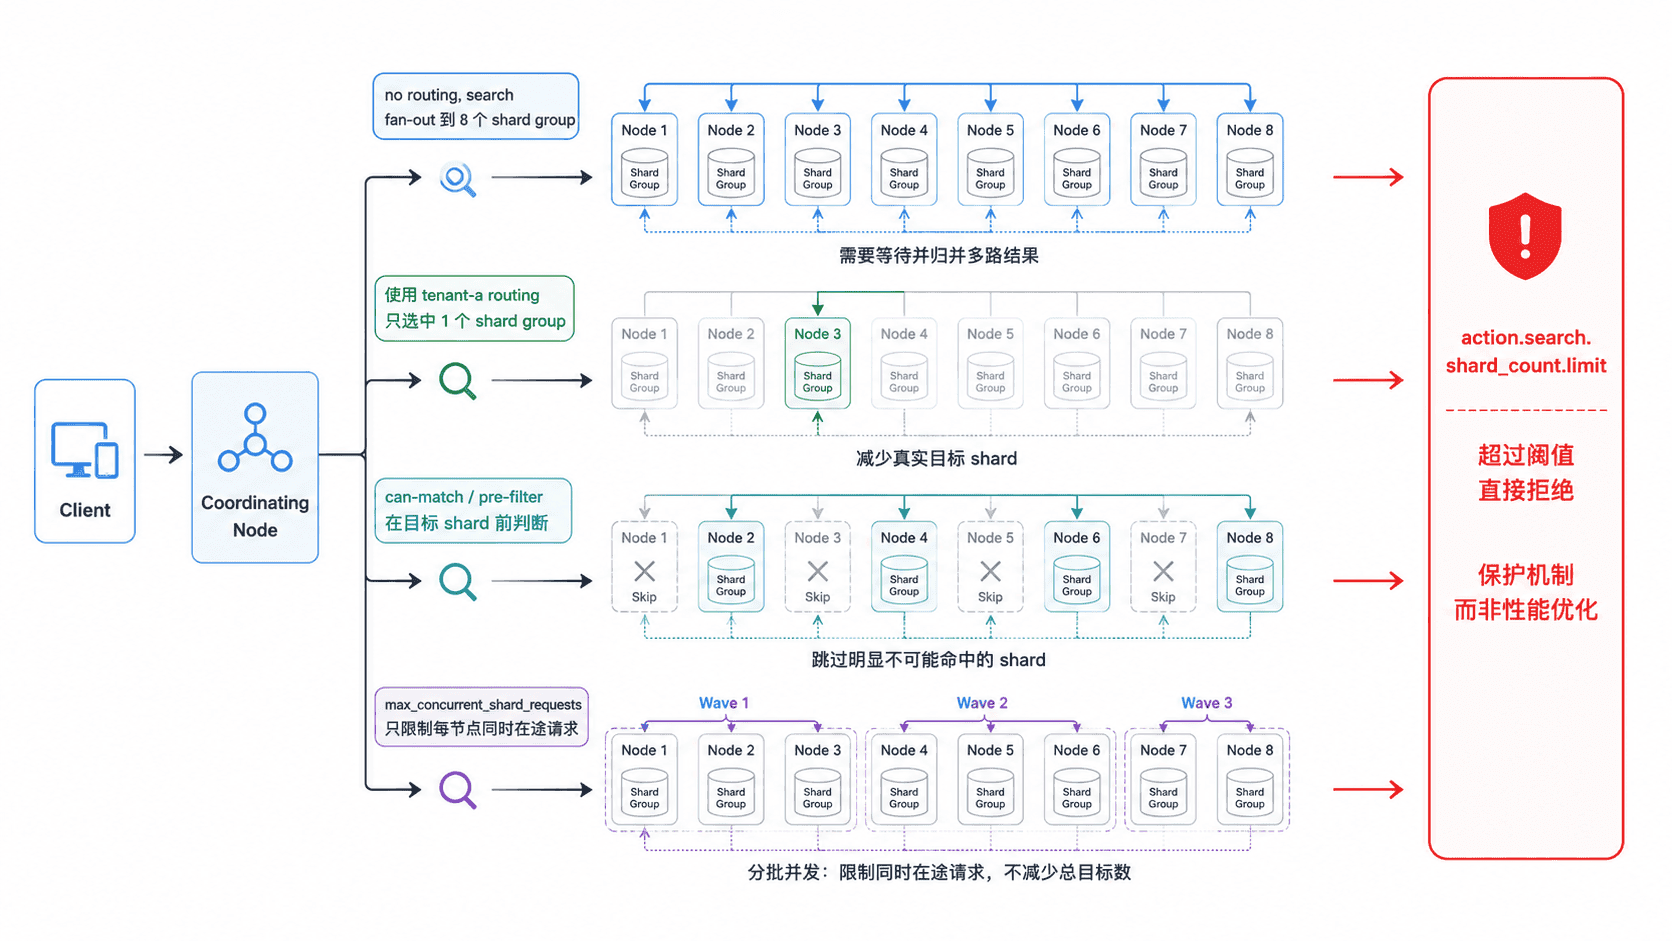
routing 能真正减少目标 shard,但前提是写入和查询使用同一业务键,并且该查询只需要访问这些 routing 值对应的数据。只在 query body 里加 tenant = tenant-a 过滤条件,并不会自动把请求路由到 tenant-a 的 shard;若写入时使用了自定义 routing,查询时也必须传相同 routing 才能获得这个收益。
pre_filter_shard_size 控制 can-match 预过滤轮次的触发阈值。它适合时间范围等能够通过 query rewrite 判断“不可能命中”的场景,可以让部分 shard 不进入完整 query phase,但它不等价于从索引拓扑上减少 shard。
max_concurrent_shard_requests 则只限制单次搜索在每个节点上并发执行多少 shard 请求。把它调小能抑制一次大查询瞬间占满搜索资源,却可能拉长该请求自身延迟;目标 shard 总数并没有因此减少。
选择减少 fan-out 的手段
最优先的手段是缩小搜索目标。日志和指标类数据应尽量只查询需要的 data stream、alias 或时间范围,不要让一个短时间窗口的请求无条件展开到大量历史索引。若业务天然按租户、用户或账户隔离,可以评估自定义 routing,让同一业务键的数据集中到确定 shard。
如果 shard 数已经失控,应从索引生命周期和 shard sizing 修复根因。很多小 shard 会让一次搜索产生大量独立任务,每个 shard 都有调度、段访问和结果归并开销;简单地提高并发只会更快地把这些任务推向 CPU、搜索线程池和协调节点。
用护栏阻止失控查询
action.search.shard_count.limit 可以作为集群级护栏:当一次搜索命中的 shard 数超过设定阈值时直接拒绝请求。它适合防止通配符索引、错误时间范围或客户端 bug 把整个集群拖入高 fan-out,但不会让同一条查询变快。
同样,preference 主要影响选择哪个 shard copy 以及请求顺序,可用于提高缓存局部性;它通常不是减少逻辑 shard 数的工具。判断优化是否有效时,应同时观察 _shards.total、搜索线程池排队、协调节点 CPU 与 P95/P99 延迟,而不是只看单次请求有没有成功返回。
真正有效的 fan-out 治理顺序是:先减少搜索目标 shard,再利用可跳过机制,最后用并发限制和 shard-count limit 做资源保护。这样才能同时改善单请求延迟和集群吞吐。