
NoSQL 与搜索 / 系统课时
控制 Merge 与 Segment 压力
控制 Merge 与 Segment 压力
持续写入时,Lucene 会不断产生不可变 segment,并在后台合并。真正需要控制的不是“merge 越少越好”,而是让 segment 产生速度、合并吞吐和磁盘能力保持平衡。本课用节点统计把 merge backlog、磁盘 I/O 与 segment 增长串起来,判断写入放大是否已经失控。
学习目标
- 能从 segment、merge 与文件系统指标判断合并是否追不上写入
- 能区分正常后台合并与会拖慢写入的持续性 merge 压力
- 能通过刷新频率、写入批次和磁盘能力降低不必要的写入放大
看懂 Segment 到 Merge 的压力链路
文档先进入索引缓冲区,refresh 后形成可搜索的新 segment。segment 不可原地修改,更新和删除通常会留下旧数据,之后再由后台 merge 把多个较小 segment 重写成更大的 segment,并清理可回收内容。因此高写入、高更新率、频繁 refresh 都可能增加磁盘读写量。
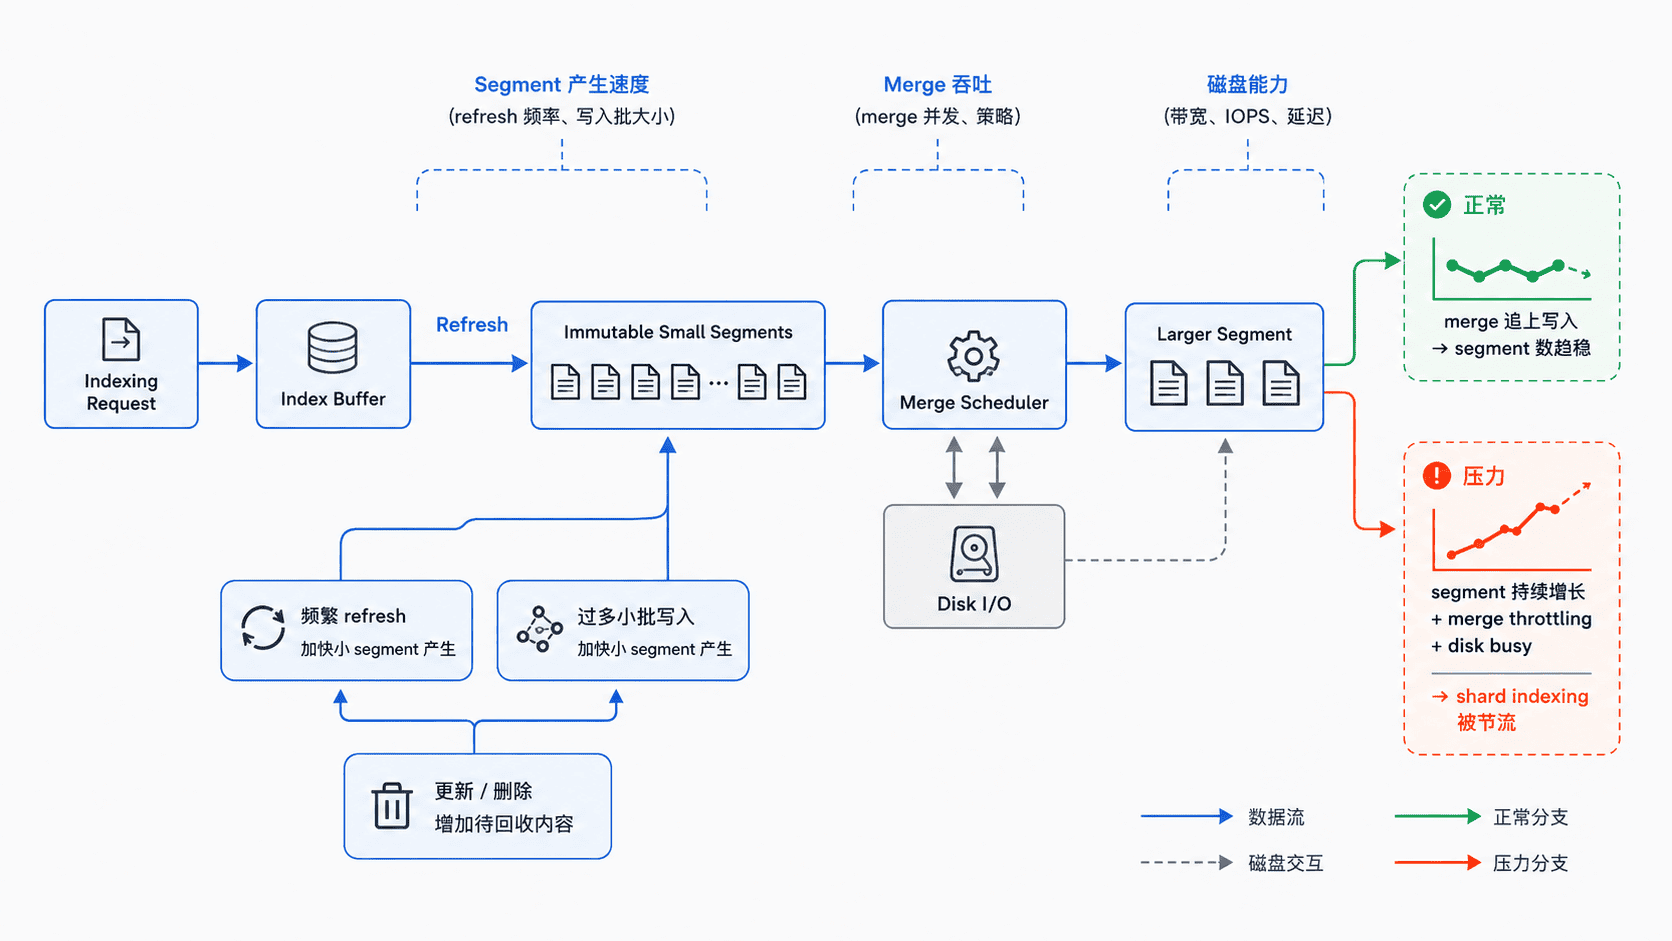
这里没有一个单独指标能完整表示“merge backlog”。merges.current 只表示当前执行中的 merge,真正的积压要看一段时间内 segment 是否持续净增长、merge 是否长期繁忙或被节流,以及磁盘是否同时接近吞吐上限。
采集同一时间窗的三类信号
下面命令需要把 ES_URL 和 ES_API_KEY 设置为有集群监控权限的连接信息。它一次采集每个节点的 merge、segment 与 Linux 文件系统 I/O;非 Linux 环境可能没有 fs.io_stats。
curl -sS \
  -H "Authorization: ApiKey $ES_API_KEY" \
  "$ES_URL/_nodes/stats/indices,fs?filter_path=nodes.*.name,nodes.*.indices.merges.current,nodes.*.indices.merges.current_size_in_bytes,nodes.*.indices.merges.total_throttled_time_in_millis,nodes.*.indices.merges.total_size_in_bytes,nodes.*.indices.segments.count,nodes.*.fs.io_stats.total.write_kilobytes,nodes.*.fs.io_stats.total.io_time_in_millis"
预期结果
HTTP 层返回 200,响应中每个 nodes.<ID> 至少可见:
name
indices.merges.current
indices.merges.current_size_in_bytes
indices.merges.total_throttled_time_in_millis
indices.merges.total_size_in_bytes
indices.segments.count
fs.io_stats.total.write_kilobytes        # Linux 节点
fs.io_stats.total.io_time_in_millis      # Linux 节点
实际数值随节点负载变化。segments.count、merges.current 属于观察时点;merges.total_size_in_bytes、total_throttled_time_in_millis 与磁盘累计写入量更适合取两次采样后比较增量。fs.io_stats 是设备级统计,共享磁盘时还要与主机 I/O 指标交叉验证。不要拿一次快照就判断“失控”,至少覆盖一个典型写入高峰和随后一段回落窗口。
用组合信号定位根因
如果写入停止或明显回落后,segment 数仍持续上升,merge 长时间活跃且 throttled time 增量很快,同时磁盘 I/O 居高不下,说明 merge 消化速度落后于 segment 产生速度。此时写入吞吐下降往往是结果,不应先去放大写入并发。
如果 segment 数短时上升、随后回落,而 merge 在高峰后逐渐归零,这通常是正常吸收突发写入。绝对 segment 数没有通用“危险阈值”,应按同一索引、同一 shard 规模和同一硬件建立基线。
常见放大源包括:大量小 bulk、显式使用 refresh=true、过短的 index.refresh_interval、更新或删除比例高、单节点承载过多活跃 shard,以及存储吞吐不足。磁盘可用空间过低也会影响新的 merge 调度,因此要把容量与 I/O 一起看。
控制写入放大而不是强行压 Merge
优先从 segment 的产生端减压。批量导入且能容忍更长可见性延迟时,可以临时增大刷新间隔;生产在线索引必须先确认搜索新鲜度要求,再做小步调整。
curl -sS -X PUT \
  -H "Authorization: ApiKey $ES_API_KEY" \
  -H "Content-Type: application/json" \
  "$ES_URL/logs-write/_settings" \
  -d '{"index":{"refresh_interval":"30s"}}'
预期输出
{"acknowledged":true}这个调整会减少 refresh 频率,从源头减少短时间内形成的小 segment,但会延长新写入对搜索可见的等待时间。批量任务结束后,应恢复业务要求的刷新策略,而不是长期保留一个为了导入吞吐设置的值。
同时把 bulk 大小和客户端并发作为成对参数压测:过小会增加请求与 refresh 周边开销,过大或并发过高则会把内存、CPU 和磁盘压力一起推高。只有确认使用机械硬盘等特殊存储时,才考虑降低 index.merge.scheduler.max_thread_count;SSD 场景通常先保留默认的自适应 merge 行为。
验证 Merge 已经追上写入
修复后重新采样同一组指标,并对比相同负载窗口。健康方向不是要求 merge 变成零,而是写入高峰后 segments.count 能趋稳或回落,merge 节流时间的增长速度下降,磁盘 I/O 不再长期顶住,同时业务写入吞吐和延迟恢复到基线。
如果 segment 仍持续净增长,继续查热点 shard、更新/删除比例、存储吞吐与 refresh 触发方式;不要只靠增加 merge 线程掩盖底层 I/O 不足。控制 merge 的核心是让“segment 产生速率 ≤ 可持续合并能力”,这样后台整理才不会反过来吞噬前台写入资源。