
NoSQL 与搜索 / 系统课时
规划分片大小与分片数量
规划分片大小与分片数量
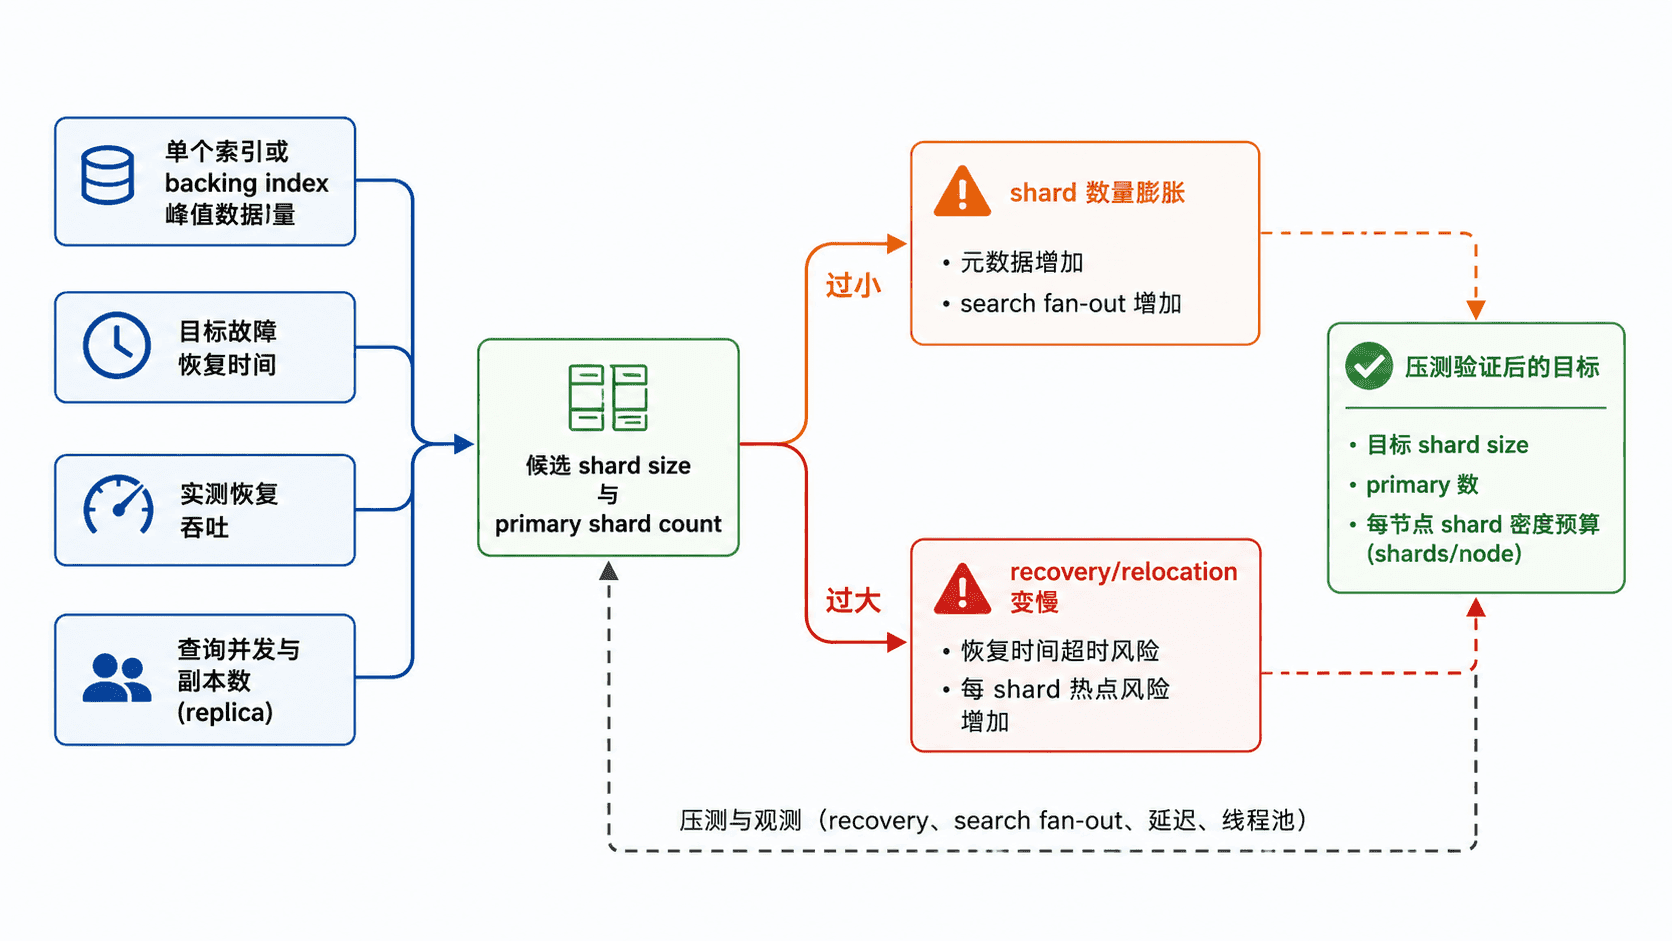
分片规划要同时回答两个问题:一个分片应该多大,以及一个索引应该有多少个主分片。正确做法不是套固定口诀,而是从数据量出发,再用恢复时间、查询扇出和节点承载能力反向校正。
学习目标
- 根据单个索引或 backing index 的峰值数据量估算主分片数量
- 用恢复时间与查询并发修正目标分片大小
- 通过集群 API 核对真实分片大小和每节点分片密度
先把数据规模换算成分片预算
先选一个“目标主分片大小” ,再用单个索引预计最大数据量 计算主分片数 :
如果副本数为 ,该索引最终产生的 shard copy 总数为:
例如一个 backing index 峰值约 960 GB,压测后决定先以 30 GB 作为目标主分片大小,则可从 32 个 primary 起步;若配置 1 个 replica,总 shard copy 为 64 个。这里的 30 GB 是容量模型输入,不是 Elasticsearch 强制配额,真实值仍要用生产工作负载验证。
用恢复时间和查询扇出校正
过大的 shard 会延长 relocation、replica recovery 和节点故障后的恢复时间。可以把可接受的单 shard 恢复时间记为 ,实测有效恢复吞吐记为 ,先得到理论上限 ,再为并发恢复、磁盘抖动和业务流量留出余量。
另一侧是查询扇出。一次搜索命中多少 shard,就会产生多少 shard 级工作;盲目增加 primary 可能让单次查询同时占用更多搜索线程并增加归并开销。只有当节点、CPU 和搜索线程资源能承接这些并行任务时,更多 shard 才可能带来收益。
用集群数据验证假设
下面的命令分别读取每个 shard 的实际存储量,以及全集群 primary 和总 shard copy 数。需要一个只读 API Key;<HOST>、<PORT>、<API_KEY> 等按环境替换。
export ES_URL="https://<HOST>:<PORT>"
export ES_API_KEY="<API_KEY>"
# 先看真实 shard 大小,避免只依据写入量估算压缩后的存储。
curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_cat/shards?format=json&bytes=gb&h=index,shard,prirep,state,store,node"
# 再核对 primary 与总 shard copy,副本同样占用节点资源。
curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_cluster/stats?filter_path=indices.shards.total,indices.shards.primaries,indices.store.size_in_bytes"
预期输出
[{"index":"logs-<DATE>","shard":"0","prirep":"p","state":"STARTED","store":"<VALUE>","node":"<NODE>"}, ...]
{"indices":{"shards":{"total":<VALUE>,"primaries":<VALUE>},"store":{"size_in_bytes":<VALUE>}}}
实际索引名、节点名和数值会不同。重点不是得到某个固定数字,而是检查 shard 大小分布:如果同一类索引长期出现大量极小 shard,应让后续索引减少 primary、调整 rollover,存量索引则通过 reindex 等方式重整;如果单 shard 已大到恢复时间无法满足目标,应让新索引增加 primary 或更早 rollover。
把分片数量落到节点拓扑
总 shard copy 还要除以对应 data tier 的节点数,得到平均密度,但规划不能停在平均值。至少要同时检查正常状态和丢失一个节点后的最坏状态,并确认 primary 与 replica 仍有足够节点和磁盘完成重新分配。
最终验收应同时满足三件事:目标 shard 大小在真实数据上稳定、节点故障后的恢复时间达标、代表性搜索压测没有因 shard 扇出出现线程池排队或尾延迟恶化。满足这三项后,分片数量才是容量设计结果,而不是一次静态计算。