
NoSQL 与搜索 / 系统课时
监控 JVM 与 GC
监控 JVM 与 GC
JVM 监控的目标不是盯住一次瞬时高内存,而是识别“堆长期回不去”和“GC 开始吞噬执行时间”。本课用 Node Stats 建立 heap pressure、GC 次数与耗时的基线,并把它们组合成可落地的告警条件。
学习目标
- 采集并解释
heap_used_percent、Young GC 与 Old GC 累计计数和耗时。 - 用相邻采样点计算 GC 增量,区分正常锯齿和持续内存压力。
- 为 heap pressure 与 GC 时间占比设置可调的初始告警阈值。
先把三个信号放到同一条时间线上
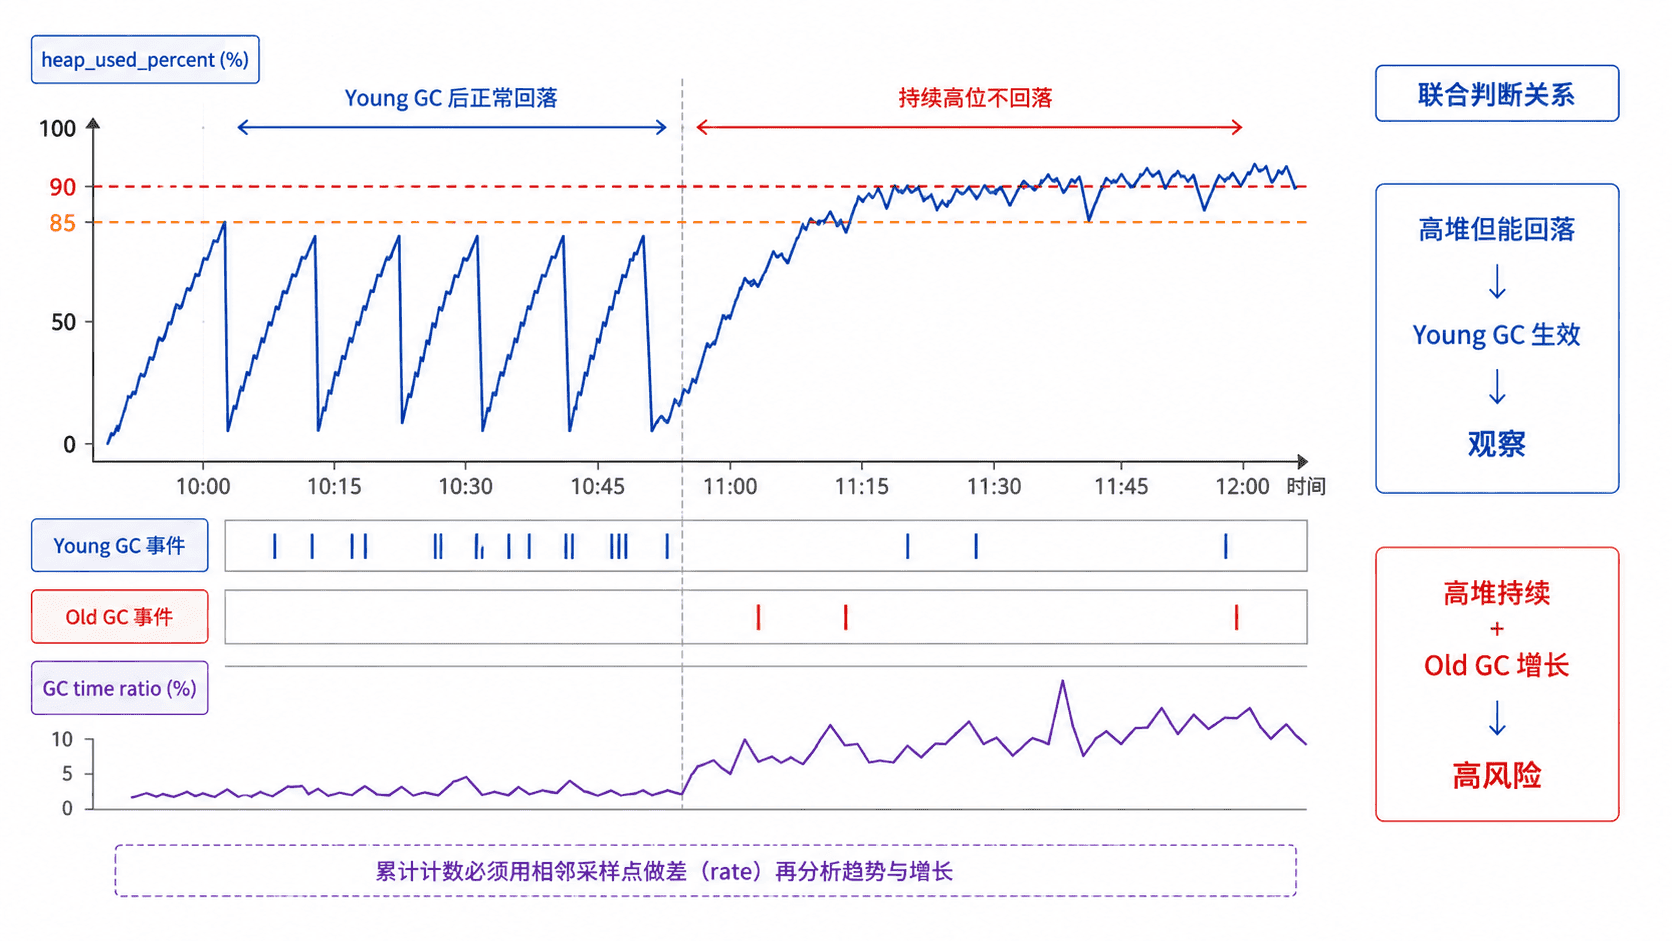
heap_used_percent 是当前堆占用快照;GC 的 collection_count 与 collection_time_in_millis 则是节点启动后的累计值。单看任意一个都容易误判:堆达到高点后迅速回落通常正常,而累计 GC 时间很大也可能只是节点运行得久。
因此监控系统应以固定周期采样,并用相邻样本做差。对一个 5 分钟窗口,可计算 ΔGC time / 300000 得到 GC 时间占比;再结合堆是否在 GC 后回落,才能判断 JVM 是否进入持续压力状态。
采集 Node Stats 形成基线样本
下面命令假设节点启用了 HTTPS 与认证,并已安装 curl 和 jq。<HOST>、<PATH>、<PASSWORD> 与输出中的数值都按实际环境替换。
curl --fail-with-body -sS \
  --cacert '<PATH>/http_ca.crt' \
  -u 'elastic:<PASSWORD>' \
  'https://<HOST>:9200/_nodes/stats/jvm?filter_path=nodes.*.name,nodes.*.jvm.mem.heap_used_percent,nodes.*.jvm.mem.heap_used_in_bytes,nodes.*.jvm.mem.heap_max_in_bytes,nodes.*.jvm.gc.collectors.*.collection_count,nodes.*.jvm.gc.collectors.*.collection_time_in_millis' \
| jq -r '
  .nodes[] |
  "node=\(.name) heap=\(.jvm.mem.heap_used_percent)% " +
  "young_count=\(.jvm.gc.collectors.young.collection_count // 0) " +
  "young_ms=\(.jvm.gc.collectors.young.collection_time_in_millis // 0) " +
  "old_count=\(.jvm.gc.collectors.old.collection_count // 0) " +
  "old_ms=\(.jvm.gc.collectors.old.collection_time_in_millis // 0)"
'
预期输出
node=es01 heap=<VALUE>% young_count=<COUNT> young_ms=<VALUE> old_count=<COUNT> old_ms=<VALUE>
node=es02 heap=<VALUE>% young_count=<COUNT> young_ms=<VALUE> old_count=<COUNT> old_ms=<VALUE>这些计数会随节点运行持续增加,告警必须对增量或速率生效,而不是直接比较累计总数。建议至少保留一周基线,并覆盖业务低谷、常规峰值和批量写入时段。
把基线转换成告警条件
阈值应先作为起点,再用历史分位数校准。对通用生产集群,可以从以下规则开始:
| 信号 | 初始告警建议 | 解释 |
|---|---|---|
| Heap pressure | 5 分钟持续 >= 85% 告警;持续 >= 90% 升级 |
关注“持续”,不要对一次尖峰报警 |
| GC 时间占比 | 5 分钟窗口高于自身历史 P95 的 2 倍且 >= 5% |
说明 JVM 花在回收上的时间明显增加 |
| Old GC | 5 分钟内计数增长且 Old GC 耗时同步明显高于基线 | Old GC 偶发并不等于故障,连续增长更值得关注 |
从组合信号定位真正的内存压力
如果 heap 呈稳定锯齿,Young GC 有规律增长,而每次回收后都能回到较低水位,通常只是正常分配活动。相反,如果 heap 长时间停在高位、Old GC 计数持续增加且 GC 时间占比上升,就应优先调查大聚合、高基数字段、过大的 bulk、分片过多或单节点负载倾斜。
告警面板至少把“当前 heap”“5 分钟 GC 时间占比”“Old GC 增量”和节点名放在同一视图中。这样告警触发后可以直接回答两个问题:压力是否只发生在单节点,以及 GC 是否真的把 CPU 时间从请求处理上抢走。