
NoSQL 与搜索 / 系统课时
理解 Primary、Replica 与写入确认
理解 Primary、Replica 与写入确认
本篇把一次 Elasticsearch 写入拆成可验证的复制流程:请求如何找到 Primary,Primary 如何把操作复制到 Replica,以及客户端何时收到成功。重点还会澄清 wait_for_active_shards 的真实含义,避免把“写入前检查副本数量”误当成“按副本数投票提交”。
学习目标
- 解释 Primary、Replica 与 replication group 的职责关系
- 看懂写入从路由、Primary 执行到 in-sync Replica 确认的完整路径
- 正确使用
wait_for_active_shards,并从_shards判断实际复制结果
Primary 与 Replica 构成复制组
一个 Primary shard 与它的零个或多个 Replica shards 组成一个 replication group。文档根据 _id 或显式 routing 被定位到某个 shard 后,所有索引、更新和删除操作都以该组当前的 Primary 作为入口;Replica 保存冗余副本,也可以承担搜索与读取。
Primary 数量决定索引的数据分区数量,创建索引后不能直接修改;Replica 数量可以动态调整。正常分配时,同一 shard 的不同 copy 会尽量放在不同节点,避免单个节点故障同时带走 Primary 与 Replica。
Replica 不是独立接受写入的“第二主节点”。它执行的是 Primary 已接受并转发的操作;Primary 失效后,Elasticsearch 才会从合格的副本中提升新的 Primary,并通过新的集群状态让整个集群接受这一角色变化。
一次写入怎样得到成功确认
协调节点先根据 routing 计算目标 shard,再把请求转发给该 replication group 的当前 Primary。Primary 校验并在本地执行操作,然后把同一个操作并行发送给当前 in-sync copies 中的 Replica。in-sync 集合表示仍被认为包含所有已确认写入的合格 shard copies。
正常情况下,Primary 等待这些 in-sync Replica 完成本地操作并返回,再向客户端确认成功。如果某个 in-sync Replica 在复制阶段失败,Primary 不能简单忽略它并立即返回;它需要请求 elected master 将故障 copy 从 in-sync 集合移除,保持“已确认写入不会依赖一个漏写的副本”这一安全约束。
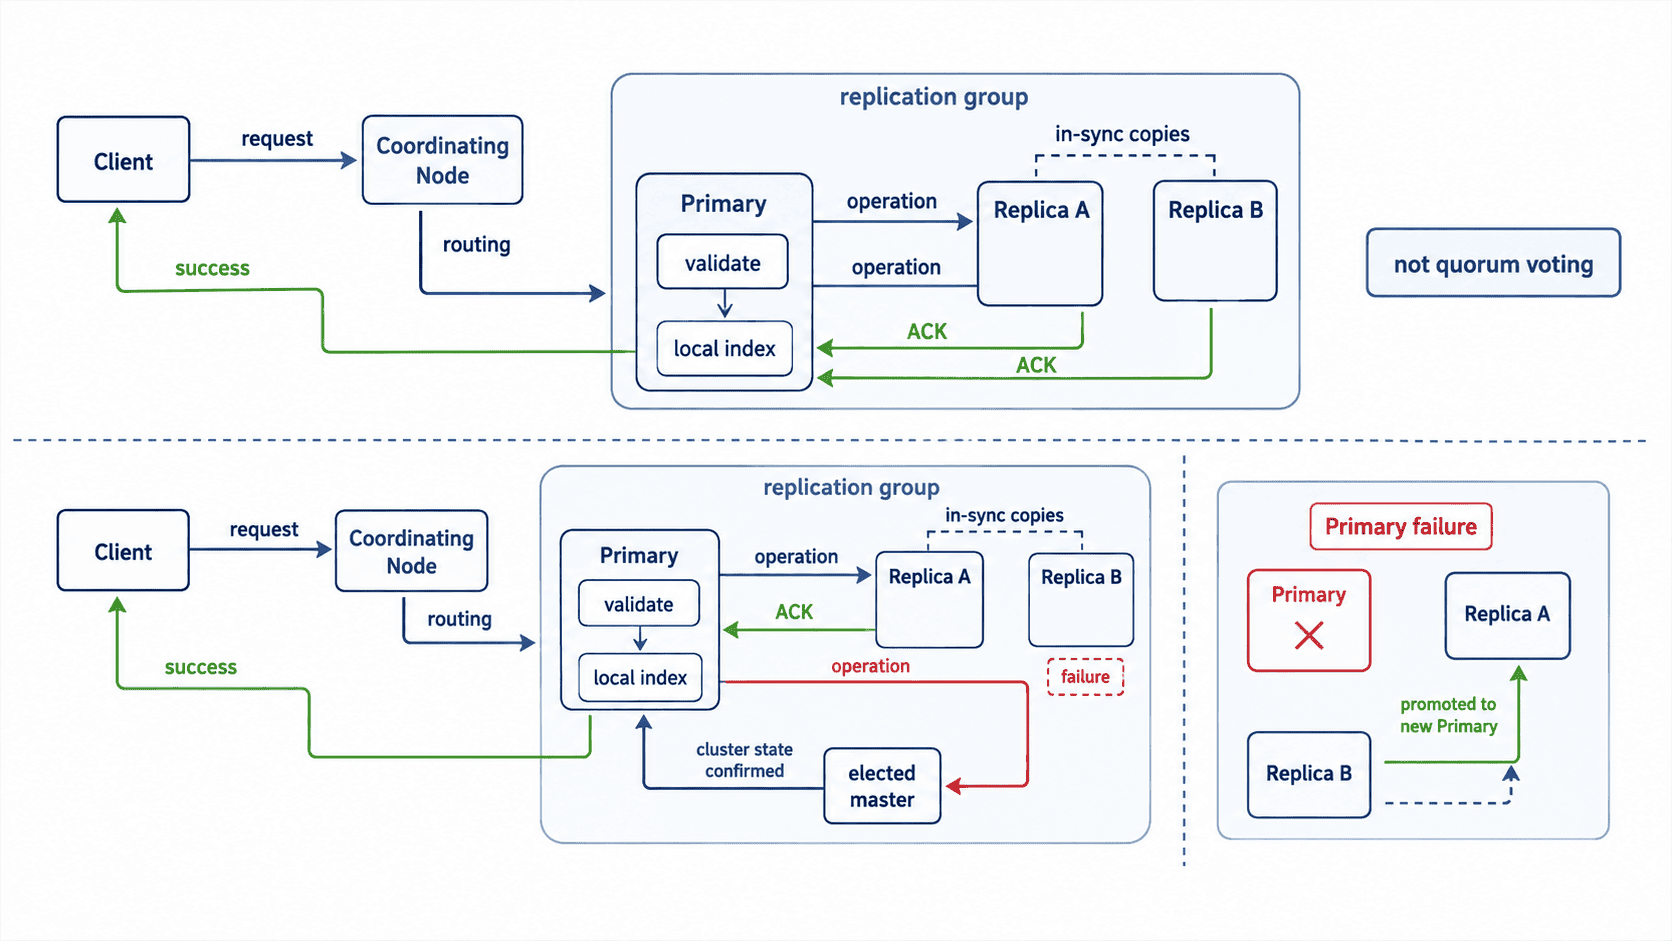
这套模型叫 primary-backup,而不是“每次写入只要多数副本成功就提交”。因此某个仍在 in-sync 集合里的慢 Replica,确实可能拖慢该 replication group 的写入延迟。
wait_for_active_shards 是写入前门槛
wait_for_active_shards 检查的是操作开始之前有多少 shard copies 处于 active。默认值是 1,也就是只要求 Primary active;设置为 all 时,则要求该 shard 所有已配置的 copies 在写入开始前都 active。
这个参数不能被解释成“成功写到 N 份后就返回”。检查通过之后,Replica 仍可能在实际复制阶段失败,因此最终还要看写入响应中的 _shards。它能提高在副本缺失时继续写入的门槛,但不能把 Primary-Replica 模型改造成 quorum write。
动手验证两副本写入
下面示例要求集群至少有两个可承载该索引 shard 的数据节点。它创建一个 1 Primary + 1 Replica 的测试索引,再要求写入必须等两份 copy 都 active 后才开始。示例使用 filter_path 让输出只保留本课需要观察的字段。
export ES_URL="https://<HOST>:<PORT>"
export ES_API_KEY="<API_KEY>"

curl -s -X PUT \
  -H "Authorization: ApiKey $ES_API_KEY" \
  -H "Content-Type: application/json" \
  "$ES_URL/ops-demo?wait_for_active_shards=all&filter_path=acknowledged,shards_acknowledged,index" \
  -d '{"settings":{"number_of_shards":1,"number_of_replicas":1}}'

curl -s -X PUT \
  -H "Authorization: ApiKey $ES_API_KEY" \
  -H "Content-Type: application/json" \
  "$ES_URL/ops-demo/_doc/42?wait_for_active_shards=all&filter_path=result,_shards" \
  -d '{"service":"checkout","status":"ok"}'
预期输出在两份 shard copy 都正常时类似:
{"acknowledged":true,"shards_acknowledged":true,"index":"ops-demo"}
{"result":"created","_shards":{"total":2,"successful":2,"failed":0}}
第一行说明索引创建与所要求的 shard 启动条件都在超时前满足;第二行的 _shards.successful: 2 表示这次文档写入在 Primary 和 Replica 上都成功完成。若节点数量、分配过滤或磁盘水位导致 Replica 无法 active,wait_for_active_shards=all 会等待直到条件满足或请求超时。
副本故障时如何理解风险
如果 Primary 仍然 active,但某个 Replica unassigned,索引健康通常会变为 yellow:数据仍可从 Primary 提供,但冗余已经下降。使用默认 wait_for_active_shards=1 的新写入仍可能继续;使用 all 则会在副本未恢复前阻止新写入进入执行阶段。
Primary 故障时,Elasticsearch 会通过集群协调选择并提升合格副本。运维上真正要关注的是:是否仍有足够的 in-sync copies、Replica 为什么无法分配或持续变慢,以及写入响应中的 _shards 是否出现失败。把“有 Replica 配置”与“Replica 当前可用且已完成这次复制”区分开,才能准确判断写入确认背后的实际冗余。