
NoSQL 与搜索 / 系统课时
设计 Rollover 边界
设计 Rollover 边界
Rollover 的目标不是“每天切一个索引”,而是让 write index 在可预测的分片大小、文档密度和时间窗口内结束写入。合理边界能减少超大分片带来的恢复成本,也能避免低流量场景产生大量小分片。设计时应先看真实写入速率,再把大小、文档数与年龄组合成条件。
学习目标
- 根据主分片大小、文档数和索引年龄选择 rollover 条件。
- 正确理解多个
max_*与min_*条件的组合语义。 - 使用 Rollover API 的
dry_run校准阈值,并把最终边界交给 ILM 自动执行。
先把 Rollover 目标定义成分片边界
优先从“单个主分片希望长到多大”反推,而不是先定一天一个索引。实践中可以先把单个主分片控制在约 10–50 GB 的常见范围,再结合节点磁盘、恢复时间、查询并发和副本数修正目标。对日志类负载,最终阈值应来自生产观测而不是固定模板。
如果每日产生约 120 GB 的 primary 数据、write index 有 3 个主分片,那么每个主分片一天大约增长 40 GB。此时把 max_primary_shard_size 设在约 40 GB,就会让 rollover 大致跟随真实数据量,而不是依赖自然日边界。
文档数条件用于补充“数据非常省空间但单分片文档过多”的情况;max_age 则更像安全上限,防止低于大小阈值的索引长时间保持写入。不要只看总索引大小,因为分片不均衡时,最大的主分片才更接近恢复与查询成本的真实瓶颈。
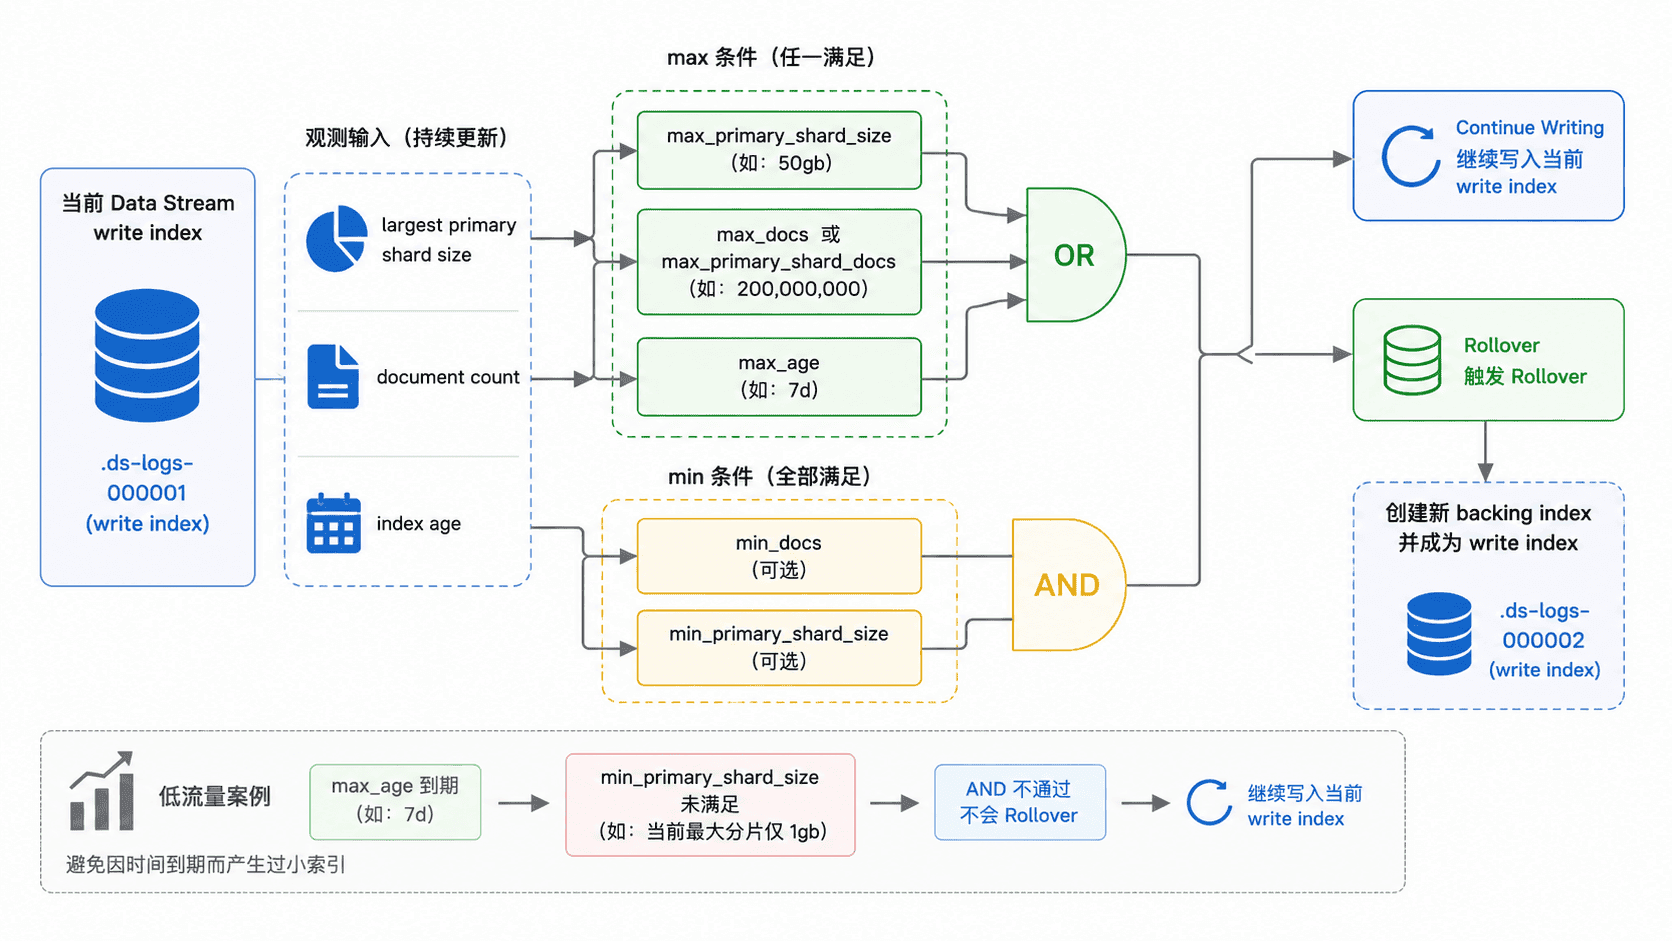
理解条件组合语义
当同时配置多个 rollover 条件时,规则不是“全部条件都满足”。只要任意一个 max_* 条件满足,并且所有 min_* 条件都满足,就可以 rollover。换成逻辑表达就是:(maxA OR maxB OR maxC) AND minA AND minB。
常用边界的职责可以这样分工:
| 条件 | 更适合控制什么 | 典型注意点 |
|---|---|---|
max_primary_shard_size |
单个主分片容量 | max_size 已标记为 deprecated,优先使用该条件 |
max_docs |
整个索引的主分片文档总数 | 不含 replica;未 refresh 的新文档不计入当前计数 |
max_primary_shard_docs |
单个主分片文档数 | 适合高压缩、小文档场景 |
max_age |
write index 最长持续写入时间 | 它不是“每天零点切索引” |
min_primary_shard_size |
防止低流量索引过早切分 | 会阻止仅由 max_age 触发的过小 rollover |
默认情况下,空 write index 即使达到 max_age 也不会 rollover。若确实需要空索引按年龄切换,可以显式设置 min_docs: 0,但多数日志和指标场景没有必要制造空 backing index。
用 Dry Run 校准阈值
不要先上线策略再观察结果。对已有 Data Stream,可以用 Rollover API 的 dry_run=true 检查当前 write index 是否满足条件;它只计算,不创建新 backing index。下面假设目标 Data Stream 叫 logs-app-prod。
POST logs-app-prod/_rollover?dry_run=true&filter_path=dry_run,rolled_over,conditions
{
  "conditions": {
    "max_primary_shard_size": "40gb",
    "max_docs": 60000000,
    "max_age": "2d",
    "min_primary_shard_size": "5gb"
  }
}
预期结果
HTTP 200
dry_run=true
rolled_over=false
conditions 中会返回每个配置条件当前为 true 或 false;dry run 不会创建新的 backing index。
如果 max_age 经常先满足,而主分片只有几百 MB,说明时间阈值太短或需要 min_primary_shard_size;如果大小阈值总是先满足且 rollover 频率远高于预期,则应检查写入突增、主分片数量和目标分片大小,而不是机械提高 max_age。自动生命周期管理会周期性检查条件,因此越过阈值与实际完成 rollover 也不保证发生在同一瞬间。
把边界交给 ILM 自动执行
在支持 ILM 的 Elastic Stack 部署中,可把验证过的条件放进 ILM hot phase。下面创建一个策略;max_* 负责触发,min_primary_shard_size 负责避免过小索引。创建策略后,还要在 Data Stream 匹配的 index template 中通过 index.lifecycle.name 关联它,才能让后续 backing index 持续受管。
PUT _ilm/policy/logs-app-policy
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": {
            "max_primary_shard_size": "40gb",
            "max_docs": 60000000,
            "max_age": "2d",
            "min_primary_shard_size": "5gb"
          }
        }
      }
    }
  }
}
预期输出
{
  "acknowledged": true
}片段示例:把下面设置合并进现有 Data Stream index template 的 template.settings,不要为了加 ILM 名称而覆盖已有 mappings 或其他 settings。
{
  "index.lifecycle.name": "logs-app-policy"
}
该配置生效后,可用 GET <BACKING_INDEX>/_ilm/explain 查看具体 backing index 的 phase、action 与 step。若使用 Elasticsearch Serverless,则不要复制这段 ILM 配置;Serverless 不提供 ILM,应使用 Data Stream Lifecycle 对应能力。
避免三类失衡
第一类是超大分片:恢复、迁移和节点重启时需要搬运更多数据。解决方向是降低目标主分片大小、提高合理的主分片并行度,或处理异常写入峰值,而不是只按日期切分。
第二类是大量小分片:每个分片都有固定的元数据、文件句柄和查询调度成本。低流量 Data Stream 若只设置很短的 max_age,最容易出现这种问题;此时应延长年龄上限或增加 min_primary_shard_size。
第三类是只看平均值:总 primary store size 看起来合理,不代表每个主分片都均匀。校准 rollover 时应同时观察最大的 primary shard、文档数和写入速率,并在流量高峰、低谷和扩容后重新验证。
合适的 rollover 边界应该让“典型流量下由大小触发、异常小流量下由年龄兜底、极高文档密度下由文档数保护”成为可观测的常态,而不是把固定日历周期当成唯一规则。