
NoSQL 与搜索 / 系统课时
识别 Heap Pressure 与长 GC
识别 Heap Pressure 与长 GC
节点偶发高延迟并不等于“堆不够”。本课从 JVM heap、old generation、GC 累计时间和节点日志建立一条定位链路,区分短时对象分配、持续存活集增长与真正的长 GC,再决定应该改查询、降负载还是继续做内存分析。
学习目标
- 用 Nodes Stats 同时观察 heap、old generation 与 young/old GC 累计计数。
- 区分高分配速率、持续 JVM memory pressure 与单次长 GC。
- 把 JVM 指标与节点延迟、日志时间窗关联,避免只凭一个百分比下结论。
先区分三种内存现象
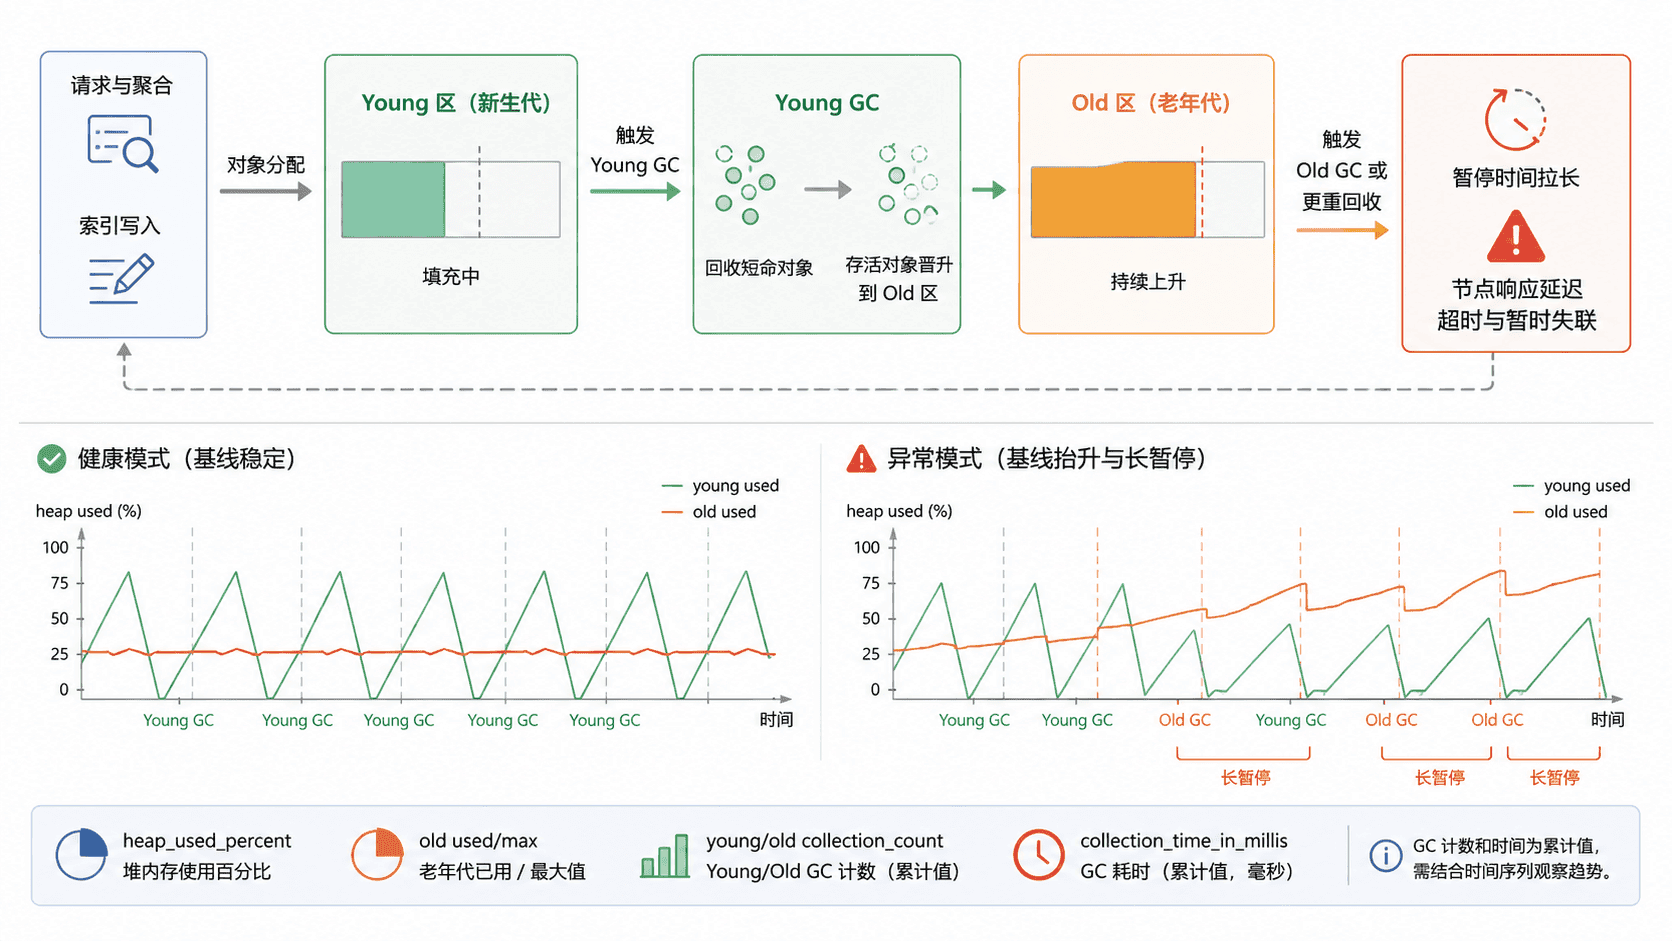
jvm.mem.heap_used_percent 适合快速观察整个 JVM 堆的占用,但 Elasticsearch 的 JVM memory pressure 更应关注 old generation 的 used_in_bytes / max_in_bytes。一次采样只能告诉你“现在多高”,不能说明对象为什么留下,也不能证明发生了长暂停。
短时分配激增通常表现为 young GC 频率上升、heap 呈锯齿回落,而 old generation 没有持续抬升。真正值得警惕的是 old generation 长时间维持高位、old GC 越来越频繁且回收后下降有限;若同时出现秒级请求停顿或节点失联,则必须继续查具体 GC 事件。
用 Nodes Stats 建立节点级证据
先对每个节点采样 JVM 数据。下面的命令需要 curl、jq,以及具备集群监控权限的账号;<HOST>、<PORT>、<USER>、<PASSWORD> 与 <PATH> 替换为实际值。为了判断趋势,应以固定间隔重复执行,而不是只保留一次截图。
export ES_URL="https://<HOST>:<PORT>"
export ES_USER="<USER>"
export ES_PASS="<PASSWORD>"
export ES_CA="<PATH>"

curl -sS --cacert "$ES_CA" -u "$ES_USER:$ES_PASS" \
  "$ES_URL/_nodes/stats/jvm?filter_path=nodes.*.name,nodes.*.jvm.mem.heap_used_percent,nodes.*.jvm.mem.pools.old,nodes.*.jvm.gc.collectors" \
| jq -r '
  .nodes[] |
  "node=\(.name)\n" +
  "heap_used_percent=\(.jvm.mem.heap_used_percent)\n" +
  "old_used_in_bytes=\(.jvm.mem.pools.old.used_in_bytes)\n" +
  "old_max_in_bytes=\(.jvm.mem.pools.old.max_in_bytes)\n" +
  "young_gc_count=\(.jvm.gc.collectors.young.collection_count // 0)\n" +
  "young_gc_time_ms=\(.jvm.gc.collectors.young.collection_time_in_millis // 0)\n" +
  "old_gc_count=\(.jvm.gc.collectors.old.collection_count // 0)\n" +
  "old_gc_time_ms=\(.jvm.gc.collectors.old.collection_time_in_millis // 0)\n"
'
预期输出
node=es-data-1
heap_used_percent=<VALUE>
old_used_in_bytes=<VALUE>
old_max_in_bytes=<VALUE>
young_gc_count=<VALUE>
young_gc_time_ms=<VALUE>
old_gc_count=<VALUE>
old_gc_time_ms=<VALUE>
这些 GC 字段是 JVM 启动以来的累计计数与累计时间,因此要用两次采样的差值判断某个观察窗口内发生了多少次 GC、累计花了多久。若 60 秒内 young_gc_count 快速增长而 old generation 基线稳定,更像分配速率过高;若 old_used_in_bytes / old_max_in_bytes 持续高位并伴随 old GC 增长,则更像存活对象占据了可回收空间。
用日志确认是否真的发生长 GC
Nodes Stats 的 collection_time_in_millis 只能告诉你累计时间,不能定位某一次暂停究竟持续多久。Elasticsearch 默认启用 GC 日志,节点日志中的 JVM GC 监控消息也能暴露明显的 GC overhead,因此应把日志时间窗与应用 P95/P99 延迟尖峰对齐。
假设当前节点日志路径已经确认并写入 ES_LOG,可先筛选 JVM GC 监控消息;<PATH> 替换为真实日志文件。
export ES_LOG="<PATH>"

grep -E "JvmGcMonitorService|gc.*overhead" "$ES_LOG" | tail -n 20
预期输出
<TIME> ... JvmGcMonitorService ... overhead, spent <TIME> collecting in the last <TIME>实际日志格式和时间值会因版本与日志配置不同;没有匹配行只表示节点日志里没有这类告警,不代表没有发生 GC。需要确认单次暂停细节时,应继续查看同一时间窗的 JVM GC 日志,而不是从累计计数反推出单次停顿。
从模式回到根因
高 heap 并不自动等于要加大 Xmx。如果 young GC 很频繁、old generation 稳定,先找高对象分配来源,例如高并发复杂查询、超大聚合、脚本或突发批量写入;这类问题通常应降低单请求工作量、控制并发或修正查询形态。
如果 old generation 长时间高位且 GC 后回落有限,应检查长期存活对象来源,例如过多分片与段元数据、fielddata、缓存、聚合状态或其他持续占用,并结合 breaker、索引与分片规模一起判断。若高压只集中在个别节点,还要先解释为什么负载或 shard 分布不均,而不是直接给全群扩容。
当长 GC 与节点延迟在同一时间窗重合、但现有指标仍解释不了 old generation 中是谁占空间时,再进入 heap dump 或更深入的 JVM 分析。生产环境采集 heap dump 可能产生较大文件并带来额外风险,应作为有计划的诊断动作,而不是第一步。