
NoSQL 与搜索 / 系统课时
理解 Shard Allocation 与 Recovery
理解 Shard Allocation 与 Recovery
本课把“分片为什么会移动”和“移动时为什么集群变慢”串成一条完整链路。你会区分 allocation、relocation 与 recovery,识别常见触发条件,并用分片和恢复 API 判断当前迁移正在消耗哪些资源。
学习目标
- 区分分片分配、重定位和恢复三个概念及它们之间的关系。
- 判断节点变化、磁盘水位、分配规则和副本调整为何会触发分片移动。
- 使用
_cat/shards与_cat/recovery观察恢复状态和进度。
Allocation 决定分片应该在哪里
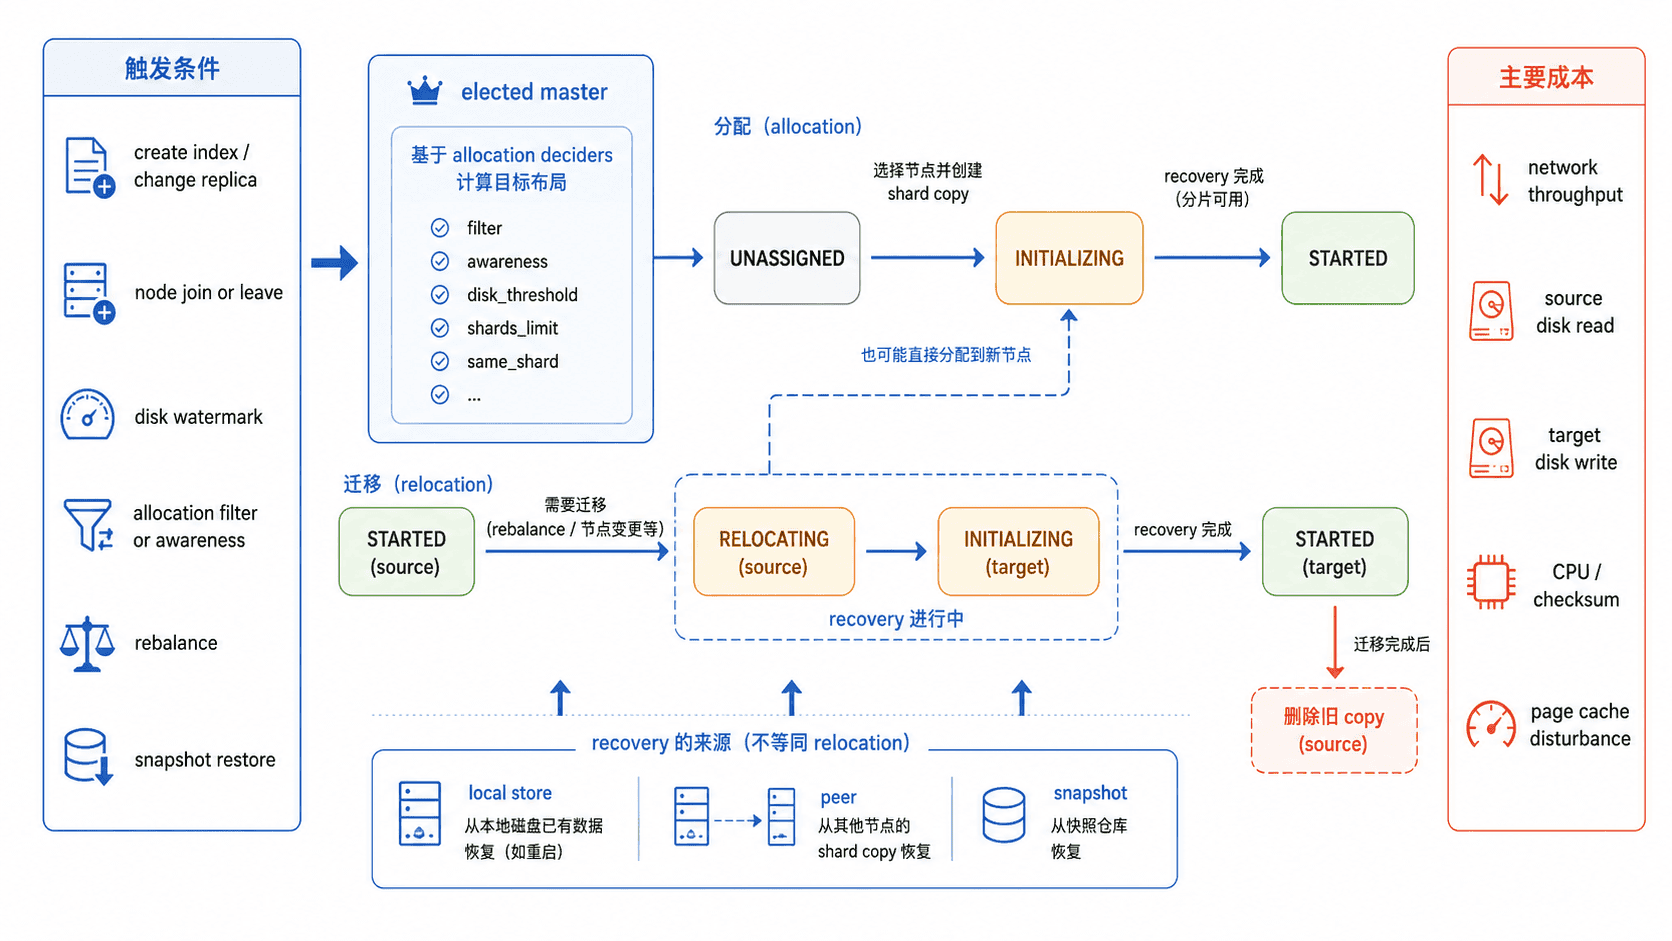
Shard allocation 是把某个主分片或副本指派给具体节点的决策过程。索引刚创建、增加副本、节点加入或离开、分配过滤规则变化、数据层迁移以及集群重新均衡,都可能让当前布局不再满足约束,从而产生新的分配决策。
真正做决策的是集群的主控层,它综合节点资格、同一分片副本不能共置、磁盘水位、allocation filtering、awareness、数据层偏好以及均衡目标等条件。某个 shard 处于 UNASSIGNED 时,重点不是立刻手工 move,而是先找出哪个 allocation decider 给出了 NO。
Relocation 通过 Recovery 完成搬迁
Relocation 表示把一个已经存在的 shard copy 从源节点移到目标节点。目标节点不会瞬间“接管”源目录,而是先创建新的 shard copy 并执行 recovery;目标副本追平并可以工作后,集群再完成切换,旧副本随后被删除。
Recovery 则是更广的初始化过程:新建副本、节点重启后恢复本地 shard、节点故障后的副本重建、relocation、snapshot restore 等场景都可能触发 recovery。因此看到 recovery 并不等于发生了故障,也不等于一定有 shard relocation。
Recovery 会争抢真实资源
Peer recovery 需要在源端读取 shard 数据,在网络上传输,并在目标端写入和校验文件;恢复后期还要处理增量变化。大量并发 recovery 会同时占用磁盘吞吐、网络带宽、CPU,并扰动文件系统缓存,所以节点扩容、滚动维护或大规模 rebalancing 期间,前台搜索与写入延迟可能一起升高。
不要把“恢复越快”简单等同于“把并发和限速调到最大”。生产调优要观察前台 P95/P99、磁盘 await、网络利用率以及 recovery 进度,在恢复时间和在线业务延迟之间做权衡。像 indices.recovery.max_bytes_per_sec 这样的设置属于资源保护旋钮,不应脱离压测和监控盲目上调。
用状态和进度判断正在发生什么
先看 shard 是否处于 UNASSIGNED、INITIALIZING 或 RELOCATING,再看 active recovery 的来源、目标和阶段。下面的 CAT API 适合人工排障查看;程序化采集应使用结构化的 cluster、shard 或 index recovery API。
ES_URL="${ES_URL:-http://localhost:9200}"

curl -sS "$ES_URL/_cat/shards?v&h=index,shard,prirep,state,node,unassigned.reason"

curl -sS "$ES_URL/_cat/recovery?v&active_only=true&h=index,shard,time,type,stage,source_node,target_node,files_percent,bytes_percent"
预期输出
index      shard prirep state        node       unassigned.reason
<INDEX>    <ID>  p      STARTED      <VALUE>    -
<INDEX>    <ID>  r      RELOCATING   <VALUE>    -

index      shard time   type stage source_node target_node files_percent bytes_percent
<INDEX>    <ID>  <TIME> peer INDEX <VALUE>     <VALUE>     <VALUE>       <VALUE>
实际没有进行中的 recovery 时,第二个命令可能只显示表头;节点名、分片号、耗时和百分比也会随现场变化。如果出现长期 UNASSIGNED,下一步应使用 allocation explain 找阻断原因;如果 recovery 持续推进但前台延迟恶化,则应优先检查恢复并发、限速以及源/目标节点的磁盘和网络饱和度,而不是把问题归咎于“分片数量不均”这一种原因。