
NoSQL 与搜索 / 系统课时
拆解 Indexing 写入链路
拆解 Indexing 写入链路
写入变慢时,只有知道时间花在协调、主分片、复制、持久化还是后台段维护上,才能选对优化方向。本课从一次文档写入出发,拆开 coordinating、primary、replica、refresh 与 merge,建立可用于观测和调优的成本模型。
学习目标
- 说明一次 indexing 请求经过 coordinating、primary 与 replica 的顺序
- 区分写入确认、refresh 可搜索、flush 持久化边界与 merge 后台整理
- 使用分片与节点统计判断写入压力集中在哪个阶段
一条写请求经历三阶段
客户端可以把请求发给任意可接收 HTTP 的节点。协调阶段先根据 routing(默认通常由文档 _id 参与计算)确定目标 replication group,再把操作转发给当前 primary。primary 负责校验并执行本地索引操作,然后把操作复制到 in-sync replica;副本完成后,结果沿 primary、协调节点返回客户端。
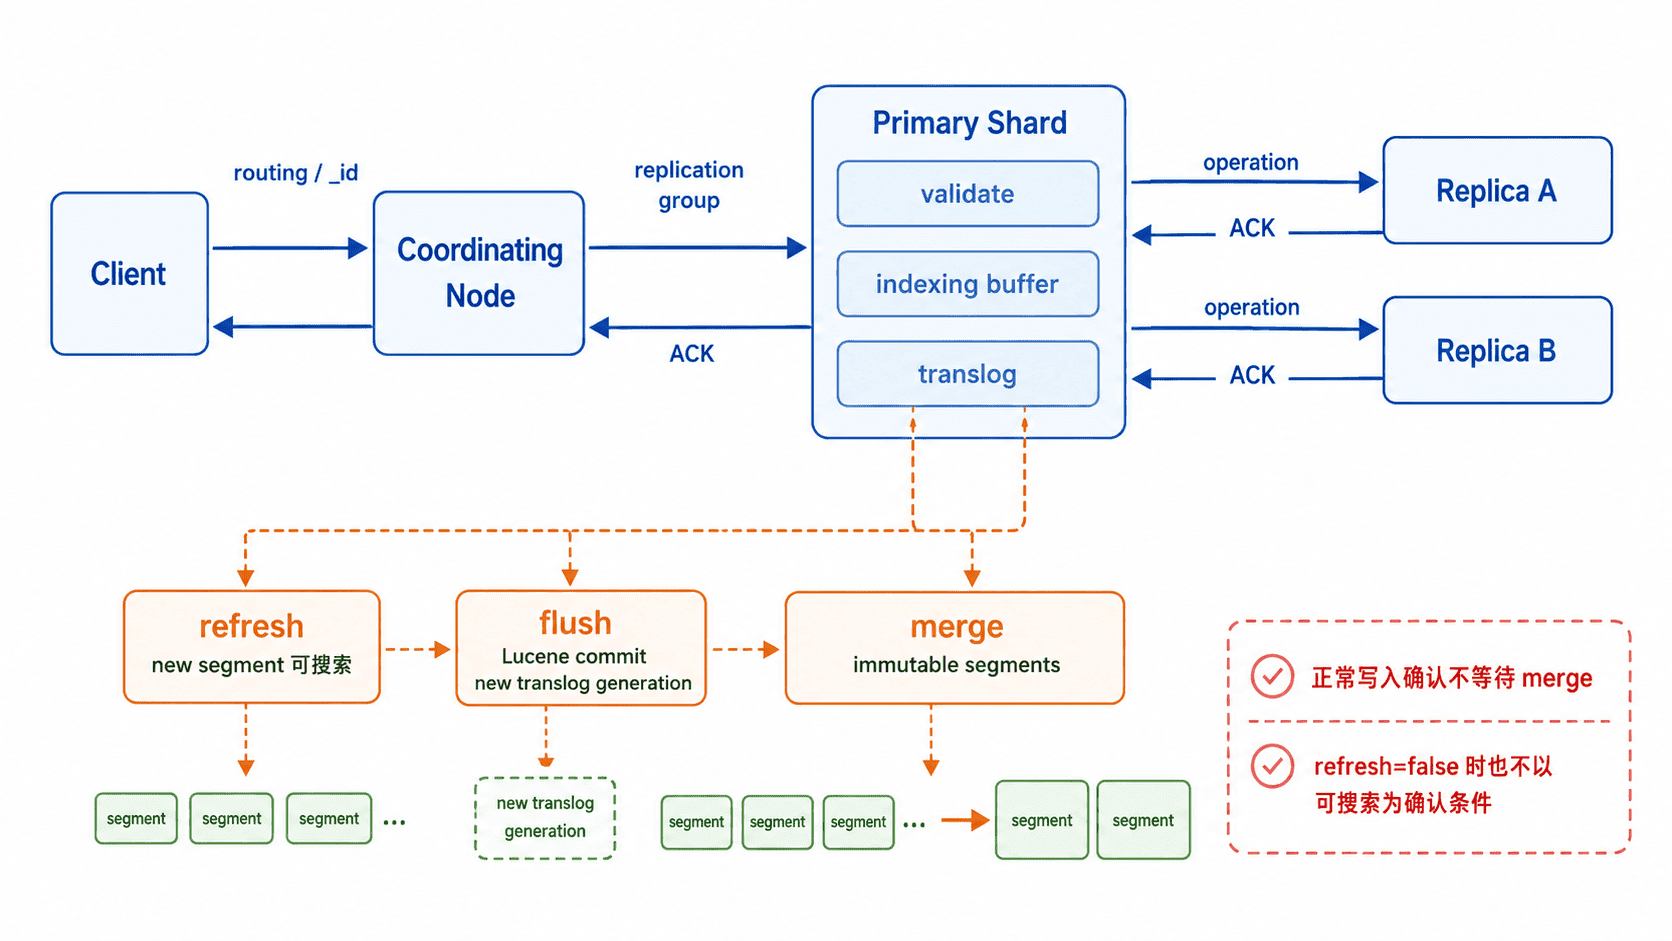
这里最容易混淆的是“已确认”和“已搜索到”。默认 index.translog.durability=request 时,成功响应与 translog 的持久化要求相关;普通写入并不会因为等待后台 merge 才返回。另一方面,没有显式要求 refresh 的请求即使已经成功,也可能要等下一次 refresh 后才能通过搜索命中。
用最小实验看见 primary 和 replica
下面实验要求至少两个可分配该索引的 data 节点,并使用具备创建索引、写入和监控权限的 API Key。先创建单主分片、单副本索引,再写入两条文档并等待索引达到 green。
export ES_URL="https://<HOST>:<PORT>"
export ES_API_KEY="<API_KEY>"

printf '=== create ===\n'
curl -sS -X PUT -H "Authorization: ApiKey $ES_API_KEY"   -H "Content-Type: application/json"   "$ES_URL/lab-write-path"   -d '{"settings":{"number_of_shards":1,"number_of_replicas":1}}'

cat > /tmp/bulk.ndjson <<'NDJSON'
{"index":{"_id":"1"}}
{"message":"alpha"}
{"index":{"_id":"2"}}
{"message":"beta"}
NDJSON

printf '\n=== bulk ===\n'
curl -sS -X POST -H "Authorization: ApiKey $ES_API_KEY"   -H "Content-Type: application/x-ndjson"   "$ES_URL/lab-write-path/_bulk?refresh=wait_for&filter_path=errors,items.*.result,items.*.status"   --data-binary @/tmp/bulk.ndjson

curl -sS -H "Authorization: ApiKey $ES_API_KEY"   "$ES_URL/_cluster/health/lab-write-path?wait_for_status=green&timeout=30s&filter_path=status,timed_out" >/dev/null

printf '\n=== shards ===\n'
curl -sS -H "Authorization: ApiKey $ES_API_KEY"   "$ES_URL/_cat/shards/lab-write-path?format=json&h=index,shard,prirep,state,node"
预期输出
=== create ===
{"acknowledged":true,"shards_acknowledged":true,"index":"lab-write-path"}
=== bulk ===
{"errors":false,"items":[{"index":{"result":"created","status":201}},{"index":{"result":"created","status":201}}]}
=== shards ===
[{"index":"lab-write-path","shard":"0","prirep":"p","state":"STARTED","node":"<PRIMARY_NODE>"},{"index":"lab-write-path","shard":"0","prirep":"r","state":"STARTED","node":"<REPLICA_NODE>"}]节点名和两行顺序可能不同。refresh=wait_for 只是等待相关写入在下一次 refresh 后可见,并不强制立即 refresh;实验用它是为了把“写入完成后可搜索”这一点变得可重复验证,而不是生产写入的默认推荐参数。
把 refresh、flush 和 merge 拆开
这三个动作都与磁盘上的 Lucene 数据有关,但职责完全不同。把它们混成“落盘”会导致错误调优。
| 机制 | 解决的问题 | 与单次写入响应的关系 |
|---|---|---|
| refresh | 把新内容暴露为可搜索的 segment | 默认不要求每次写入都等待;refresh=wait_for 可等待下一次 refresh |
| flush | 执行 Lucene commit,并开始新的 translog generation | 通常由 Elasticsearch 自动触发,不应作为每次写入的手工步骤 |
| merge | 将多个不可变小 segment 合并成较大 segment,并清理部分删除数据 | 后台执行,会消耗 CPU 与磁盘 I/O,但正常写入不等待它结束 |
因此,提高写入吞吐时不能只盯 bulk 请求本身。refresh 太频繁会制造更多小 segment,随后增加 merge 工作;merge 长时间繁忙又会与写入争抢磁盘带宽。强制 refresh=true 尤其容易把本可摊销的工作变成每批都要付出的成本。
用节点统计定位写入成本
Node Stats 可以同时看到 indexing、refresh、merge 与 indexing pressure。下面命令把每个节点的关键字段裁剪出来,适合在压测前后各采一次做差值。
curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_nodes/stats/indices,indexing_pressure?filter_path=nodes.*.name,nodes.*.indices.indexing.index_current,nodes.*.indices.indexing.index_total,nodes.*.indices.indexing.index_time_in_millis,nodes.*.indices.refresh.total,nodes.*.indices.refresh.total_time_in_millis,nodes.*.indices.merges.current,nodes.*.indices.merges.total_time_in_millis,nodes.*.indices.merges.total_throttled_time_in_millis,nodes.*.indexing_pressure.memory.current,nodes.*.indexing_pressure.memory.total.*_rejections"预期输出
{"nodes":{"<ID>":{"name":"es01","indices":{"indexing":{"index_current":<VALUE>,"index_total":<VALUE>,"index_time_in_millis":<VALUE>},"refresh":{"total":<VALUE>,"total_time_in_millis":<VALUE>},"merges":{"current":<VALUE>,"total_time_in_millis":<VALUE>,"total_throttled_time_in_millis":<VALUE>}},"indexing_pressure":{"memory":{"current":{"combined_coordinating_and_primary_in_bytes":<VALUE>,"coordinating_in_bytes":<VALUE>,"primary_in_bytes":<VALUE>,"replica_in_bytes":<VALUE>,"all_in_bytes":<VALUE>},"total":{"coordinating_rejections":0,"primary_rejections":0,"replica_rejections":0}}}}}}这些计数大多从节点启动后累计,不能直接把单次快照当成速率。更可靠的做法是按固定时间窗口计算增量:index_total 增长而 index_time_in_millis 增幅异常,说明索引执行成本上升;merge throttled time 快速增加说明段合并正在形成 I/O 压力;indexing pressure rejection 增长则说明请求已经触及节点保护机制。
用成本模型决定下一步
一次写入的成本可以粗略拆成:协调与路由、primary 本地索引与 translog、replica 复制、refresh 的可见性成本,以及后续 merge 的摊销成本。副本数增加会提高冗余,也会增加复制工作;更频繁 refresh 提高新数据可见速度,却通常牺牲写入吞吐。
因此排查写入慢时先判断“慢在哪一段”,再决定是否调整 bulk 批量、refresh 策略、分片布局或节点容量。若 429 与 indexing pressure 同时增长,应先减小进入集群的并发或批量压力;若请求本身不慢但 merge throttling 持续累积,则要转向磁盘 I/O、segment 数量和 refresh 频率,而不是继续提高客户端并发。