
NoSQL 与搜索 / 系统课时
处理 Flood-stage Watermark 与只读索引
处理 Flood-stage Watermark 与只读索引
当数据节点磁盘达到 flood-stage 水位线时,Elasticsearch 会用 index.blocks.read_only_allow_delete 保护相关索引。正确恢复顺序是先确认哪台节点缺空间、恢复到 high watermark 以下,再验证写保护自动解除;临时改阈值只能作为受控应急措施,不能替代容量修复。
学习目标
- 从磁盘使用率、有效 watermark 和索引 block 三组证据确认 flood-stage 故障。
- 区分“释放容量”和“解除写保护”,避免在磁盘仍危险时反复解锁。
- 在恢复后验证索引可写、分片可迁移,并撤销临时阈值调整。
从写入报错回溯到磁盘
典型现象是写请求被 cluster_block_exception 拒绝,并出现 read-only / allow delete。先看各数据节点磁盘,而不是立即修改索引设置。以下用 orders-000001 作为示例索引,执行时替换为实际目标索引:
GET /_cat/allocation?v=true&h=node,disk.percent,disk.avail,disk.total,disk.used,disk.indices,shards&s=disk.percent:desc预期结果:HTTP 200。实际节点名和容量会不同;重点是找出磁盘使用率最高、且承载受影响索引分片的节点。
node        disk.percent disk.avail disk.total disk.used disk.indices shards
es-hot-1    96           <VALUE>    <VALUE>    <VALUE>   <VALUE>      <VALUE>
es-hot-2    71           <VALUE>    <VALUE>    <VALUE>   <VALUE>      <VALUE>
然后读取集群真正生效的水位线,不要只凭默认值或运维手册里的旧配置判断:
GET /_cluster/settings?include_defaults=true&filter_path=*.cluster.routing.allocation.disk.watermark.*预期结果:HTTP 200,响应会在 persistent、transient 或 defaults 中显示当前相关设置;具体阈值取决于集群配置。
{
  "persistent": {},
  "transient": {},
  "defaults": {
    "cluster": {
      "routing": {
        "allocation": {
          "disk": {
            "watermark": {
              "low": "<VALUE>",
              "high": "<VALUE>",
              "flood_stage": "<VALUE>"
            }
          }
        }
      }
    }
  }
}
百分比或小数形式表达“已使用磁盘比例”,字节形式表达“剩余空间”。同一组 low、high、flood-stage 不应混用百分比与字节语义,否则容易产生错误的阈值判断。
看懂 flood-stage 的保护链
达到 flood-stage 后,保护对象不是“那块最大的索引”,而是在危险节点上拥有至少一个分片的索引。因此多个看似无关的索引可能同时变成只读。
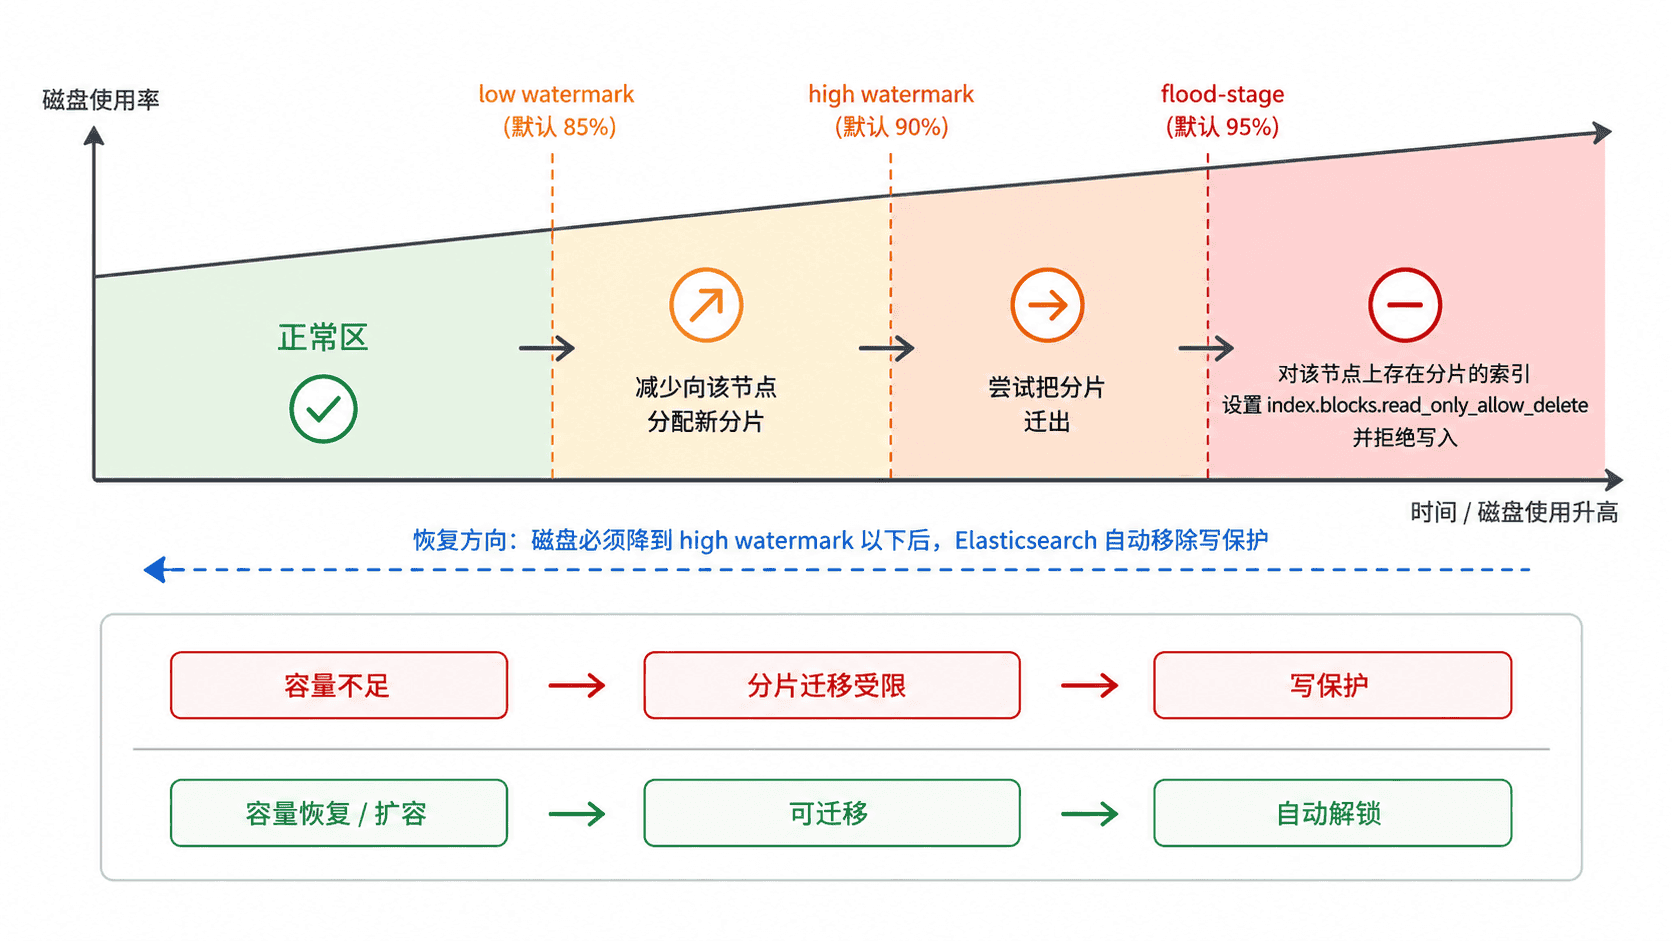
可以直接检查目标索引是否仍带有 block:
GET /orders-000001/_settings?flat_settings=true&filter_path=*.settings.index.blocks.read_only_allow_delete预期结果:HTTP 200。处于 flood-stage 写保护时,值通常为字符串 "true"。
{
  "orders-000001": {
    "settings": {
      "index.blocks.read_only_allow_delete": "true"
    }
  }
}先恢复容量再解除保护
长期修复只有两类:增加可用容量,或降低必须保留的数据量。可以扩容现有数据节点、增加同一数据层的节点让分片有迁移目的地,或按已经确认的保留策略清理整批过期索引。若要删除数据,先确认快照和业务保留要求;不要把删除文档当作低磁盘时的第一救急手段。
同时检查分片为什么没有迁走。若所有同层节点都接近水位线,或 allocation filter、awareness、tier 约束没有留下合法目的地,仅等待 rebalance 不会自动创造空间。这时应结合 Allocation Explain 处理容量与分配约束。
当前 Elasticsearch 的正常恢复路径是:受影响节点磁盘降到 high watermark 以下后,由磁盘分配器自动移除 read_only_allow_delete。因此优先等待并验证自动恢复,而不是把手工解锁写进固定运维流程。
受控场景下手动清理 block
如果容量已经确认恢复、节点低于 high watermark,但目标索引仍因既有运维操作保留 block,可以只对明确受影响的索引清理设置;不要默认对所有索引执行通配符解锁。
PUT /orders-000001/_settings
Content-Type: application/json

{
  "index.blocks.read_only_allow_delete": null
}
预期结果:HTTP 200,设置更新被接受。
{
  "acknowledged": true
}
若磁盘仍高于 flood-stage,这个动作不能算修复。需要回到容量问题;若曾为了应急临时调整 watermark,也应在容量恢复后把这些临时 cluster settings 设回 null 或恢复到组织批准的基线。
用写入和分片迁移完成验收
先重新读取 index settings,确认 block 已消失;再执行一个可控的写入探针。下面用固定测试索引名演示,<ID> 与 <TIME> 请替换为本次验证值,并在验证后按团队规范清理测试数据。
POST /orders-000001/_doc/<ID>?refresh=wait_for&filter_path=_index,_id,result
Content-Type: application/json

{
  "probe": "watermark-recovery",
  "time": "<TIME>"
}
预期结果:若 <ID> 为新的文档 ID,HTTP 201,响应表明文档已创建;实际 ID 由你的请求值决定。
{
  "_index": "orders-000001",
  "_id": "<ID>",
  "result": "created"
}
最后再次检查 _cat/allocation 与 _cat/shards。节点磁盘应稳定在安全范围,受影响分片应有合法迁移目的地,写入不再出现 read-only / allow delete。只有“磁盘余量恢复 + block 消失 + 写入成功 + 分片分配可持续”同时成立,才算真正关闭这次 flood-stage 故障。