
NoSQL 与搜索 / 系统课时
使用 Data Tiers 划分存储层
使用 Data Tiers 划分存储层
这篇把 hot、warm、cold、frozen 从概念落到节点角色、硬件资源和数据迁移规则:你会知道什么数据该进入哪一层,怎样配置节点,并让 ILM 根据数据温度自动改变分片的 tier preference。
学习目标
- 区分 hot、warm、cold、frozen 的访问特征与资源重点
- 使用内置
data_*节点角色建立存储层 - 让 ILM 驱动数据迁移,并检查
_tier_preference是否符合预期
Data Tier 是角色与硬件共同形成的层
Data tier 不是给节点贴一个名称,而是一组拥有相同 data_* 角色、并采用相近硬件规格的节点。时间序列数据通常按热度从 hot 向 warm、cold、frozen 下降;普通内容型数据则主要落在 data_content 层,不必强行经历这条温度链。
hot 层承担最新数据的持续写入和高频查询,优先保证 CPU、内存与低时延 SSD;warm 层写入很少但仍要稳定查询,可把资源重心转向容量;cold 和 frozen 更强调低成本保留,其中 searchable snapshot 会把一部分可靠性和数据读取能力转移到快照仓库。
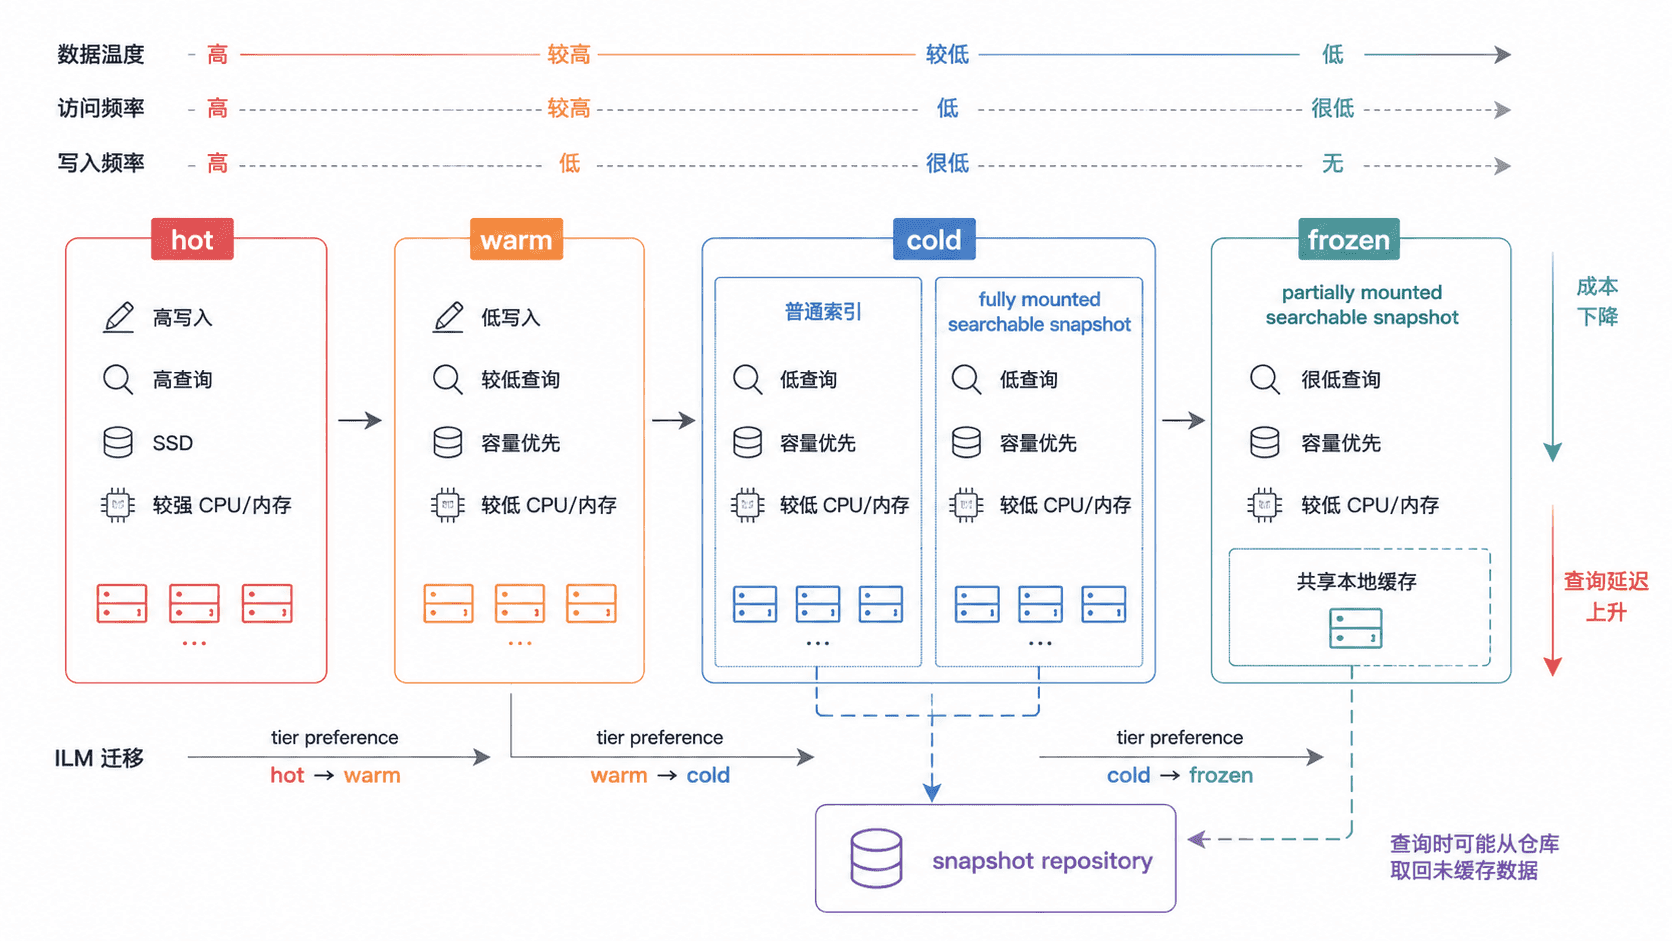
按访问模式选择资源
| 层级 | 典型数据 | 资源重点 | 关键边界 |
|---|---|---|---|
| hot | 最新日志、指标、活跃时序数据 | 高 IOPS SSD、较强 CPU 与内存 | 持续写入且查询最频繁 |
| warm | 已过写入高峰、仍常被检索的数据 | 容量优先,保留稳定查询能力 | 通常仍保存常规分片和副本 |
| cold | 很少查询的历史数据 | 更低成本容量与快照仓库吞吐 | 可用常规索引,也可用 fully mounted searchable snapshot |
| frozen | 极少查询、长期保留的数据 | 本地共享缓存与可靠对象存储 | 只承载 partially mounted searchable snapshot,查询延迟最高 |
同一 tier 内尽量保持节点 CPU、内存和磁盘规格一致。否则分片虽然“在同一层”,实际处理能力却不同,负载均衡很容易演变成热点。cold 若使用 fully mounted searchable snapshot,底层快照可用于恢复,因此通常不依赖副本来提供同样的存储可靠性;frozen 则必须有可用的 snapshot repository。
配置内置数据角色
自托管集群通过 node.roles 声明节点属于哪一层。下面是片段示例,四段应分别放入不同节点或节点组的 elasticsearch.yml,不要合并成一个配置文件。hot 与 content 常放在同一组,frozen 在生产环境更适合使用专用节点。
# hot-content 节点组
node.roles: [ data_hot, data_content, ingest ]

# warm 节点组
node.roles: [ data_warm ]

# cold 节点组
node.roles: [ data_cold ]

# frozen 节点组
node.roles: [ data_frozen ]
显式设置 node.roles 后,节点只拥有列出的角色;如果还需要 remote_cluster_client、transform 等能力,应按实际功能补齐。配置变更需要按部署方式滚动重启或重建节点,再检查角色是否生效。
ES="https://<HOST>:<PORT>"
ES_USER="<USER>"
ES_PASS="<PASSWORD>"

curl -sS -u "$ES_USER:$ES_PASS"   "$ES/_nodes/data-hot-1,data-warm-1,data-cold-1,data-frozen-1?filter_path=nodes.*.name,nodes.*.roles"
预期输出
{"nodes":{"<ID_HOT>":{"name":"data-hot-1","roles":["data_content","data_hot","ingest"]},"<ID_WARM>":{"name":"data-warm-1","roles":["data_warm"]},"<ID_COLD>":{"name":"data-cold-1","roles":["data_cold"]},"<ID_FROZEN>":{"name":"data-frozen-1","roles":["data_frozen"]}}}节点 ID 和角色数组顺序可能不同;验收标准是每个节点组包含计划中的 data_* 角色,而不是输出文本完全一致。
让 ILM 驱动层间迁移
对 ILM 管理的索引,Elasticsearch 会在生命周期阶段中使用 tier preference 把分片迁移到对应数据层。不要再同时维护一套相互冲突的自定义 allocation filter,否则索引可能进入了新阶段,却因为分配规则冲突而无法真正搬迁。
下面示例假设已注册名为 logs-repo 的 snapshot repository,并且部署支持 searchable snapshots。策略让数据滚动后依次进入 warm、cold、frozen,cold 使用 fully mounted searchable snapshot,frozen 使用 partially mounted searchable snapshot。
ES="https://<HOST>:<PORT>"
ES_USER="<USER>"
ES_PASS="<PASSWORD>"

curl -sS -u "$ES_USER:$ES_PASS"   -X PUT "$ES/_ilm/policy/logs-tiered"   -H 'Content-Type: application/json'   -d '{
    "policy": {
      "phases": {
        "hot": {
          "actions": {
            "rollover": {
              "max_primary_shard_size": "50gb"
            }
          }
        },
        "warm": {
          "min_age": "7d",
          "actions": {
            "set_priority": {
              "priority": 50
            }
          }
        },
        "cold": {
          "min_age": "30d",
          "actions": {
            "searchable_snapshot": {
              "snapshot_repository": "logs-repo"
            }
          }
        },
        "frozen": {
          "min_age": "90d",
          "actions": {
            "searchable_snapshot": {
              "snapshot_repository": "logs-repo"
            }
          }
        },
        "delete": {
          "min_age": "180d",
          "actions": {
            "delete": {}
          }
        }
      }
    }
  }'
预期输出
{"acknowledged":true}创建策略只完成了生命周期定义,还要把 logs-tiered 关联到实际索引模板或 data stream。对于发生过 rollover 的索引,各阶段 min_age 从 rollover 时间计算,而不是简单从索引创建时间计算。
用 tier preference 判断数据到底在哪里
index.routing.allocation.include._tier_preference 按从左到右的顺序声明首选层和回退层。例如 warm 阶段常见 data_warm,data_hot,表示优先放 warm;若 warm 层暂时没有可用节点,允许回退到 hot,而不是直接让分片长期 UNASSIGNED。
排查“ILM 显示已进入 cold,但磁盘没有下降”时,应同时检查当前 ILM step、_tier_preference、分片实际所在节点和 allocation explain。尤其要分清 cold 的两种形态:普通 cold 索引仍主要依赖本地完整数据;fully mounted searchable snapshot 才会利用快照仓库减少本地副本需求。
Data Tiers 的核心取舍不是把所有历史数据一路“降温”,而是先用访问频率、写入频率、查询延迟目标和保留成本确定边界,再让节点角色与 ILM 执行这个边界。hot 追求吞吐和时延,warm 追求容量效率,cold 与 frozen 则用更低访问性能交换更低的长期存储成本。