
NoSQL 与搜索 / 系统课时
使用 Data Stream 管理时序数据
使用 Data Stream 管理时序数据
Data Stream 适合持续追加的日志、事件与指标数据:应用始终对一个稳定名称读写,Elasticsearch 在其下维护一组隐藏 backing index,并把新写入送到当前 write index。掌握这层抽象后,就不必让采集端感知每天或每次 rollover 产生的新索引名。
学习目标
- 说明 Data Stream、backing index 与 write index 的职责关系。
- 创建一个最小可用的 Data Stream,并验证写入实际落到哪个 backing index。
- 理解 rollover 后写入切换、历史查询与文档修改的边界。
Data Stream 把什么抽象掉
Data Stream 本身不是一个新的存储格式,而是多个 backing index 之上的逻辑入口。它依赖匹配的 index template;每条文档必须包含 @timestamp。普通 Data Stream 的写请求只进入最新一代 backing index,而对 Data Stream 名称发起搜索时,Elasticsearch 会覆盖它当前包含的全部 backing index。
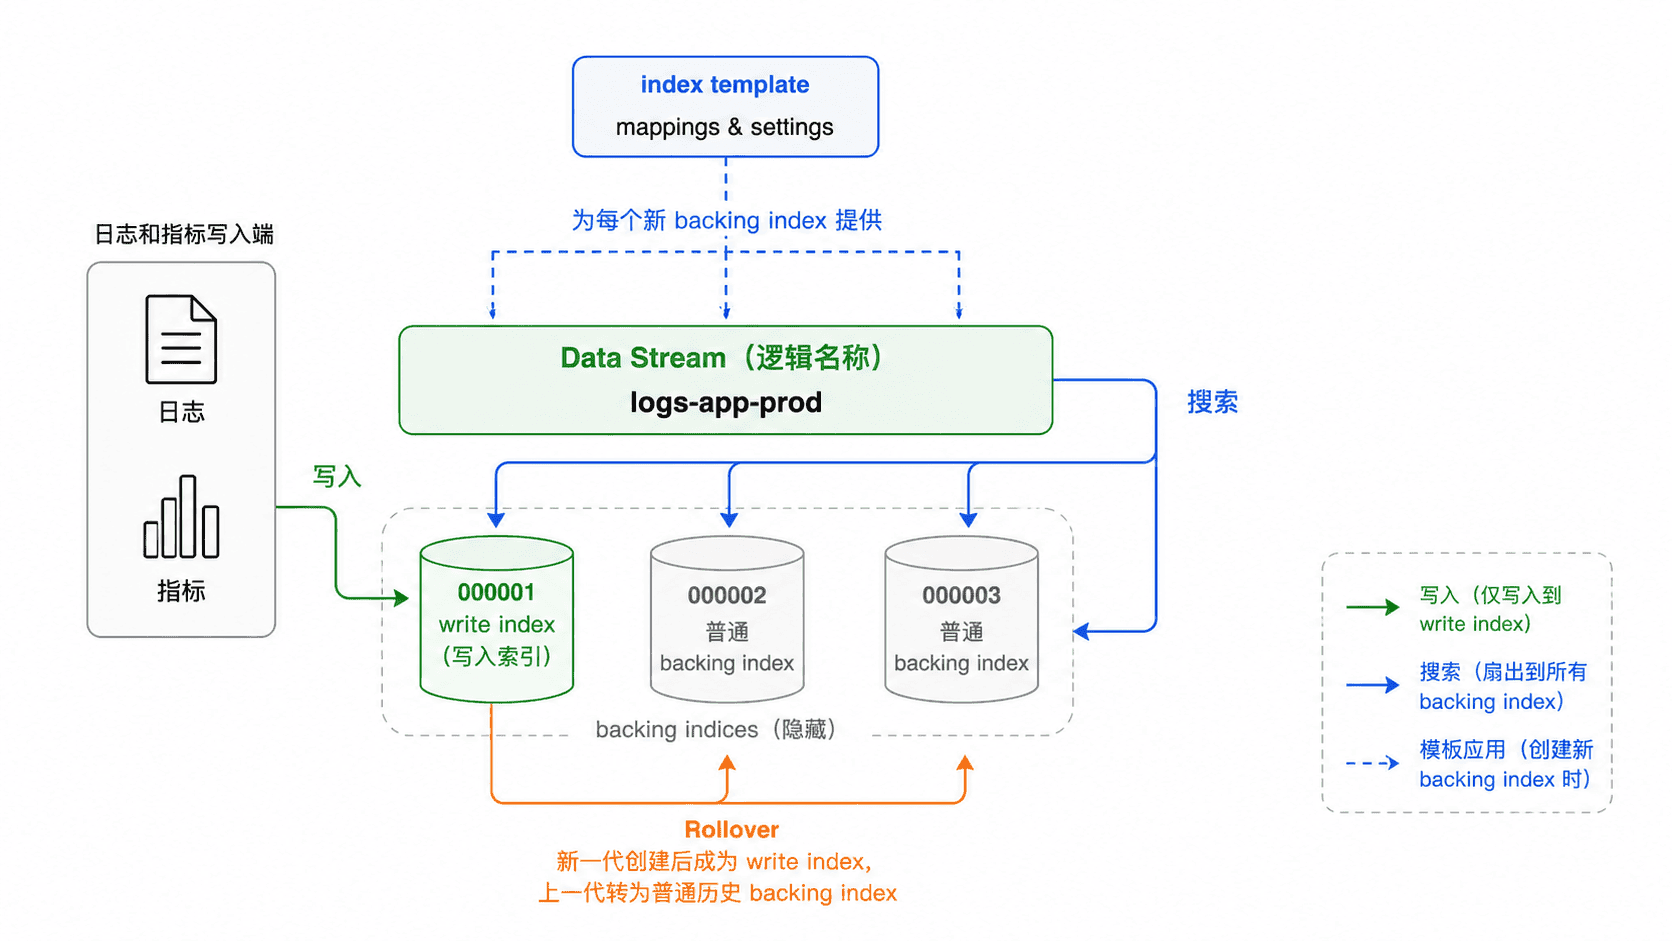
这类结构最适合 append-only 数据。若业务频繁用同一个 _id 做 last-write-wins 更新,Data Stream 会增加定位旧文档的复杂度,此时应重新评估普通索引或带 write index 的 alias 是否更合适。对于近实时指标,还可以进一步选择专门的 Time Series Data Stream,但日志场景使用标准 Data Stream 已足够。
创建最小可用 Data Stream
下面在 Kibana Dev Tools 或兼容的 Elasticsearch HTTP 客户端中执行。模板先声明 data_stream,再给 @timestamp、服务名和消息字段定义 mapping;第一次向匹配名称写入时,Elasticsearch 会自动创建 Data Stream 及首个 backing index。
PUT _index_template/logs-app-template
{
  "index_patterns": ["logs-app-*"],
  "priority": 500,
  "data_stream": {},
  "template": {
    "settings": {
      "number_of_shards": 1,
      "number_of_replicas": 1
    },
    "mappings": {
      "properties": {
        "@timestamp": { "type": "date" },
        "service": {
          "properties": {
            "name": { "type": "keyword" }
          }
        },
        "message": { "type": "text" }
      }
    }
  }
}

POST logs-app-prod/_doc?filter_path=_index,result
{
  "@timestamp": "2026-08-26T15:30:00Z",
  "service": { "name": "checkout" },
  "message": "payment accepted"
}

GET _data_stream/logs-app-prod?filter_path=data_streams.name,data_streams.generation,data_streams.timestamp_field,data_streams.indices.index_name
预期输出
{"acknowledged":true}
{"_index":".ds-logs-app-prod-<DATE>-000001","result":"created"}
{"data_streams":[{"name":"logs-app-prod","timestamp_field":{"name":"@timestamp"},"indices":[{"index_name":".ds-logs-app-prod-<DATE>-000001"}],"generation":1}]}
<DATE> 取决于实际创建时间。关键不是 backing index 的完整名字,而是采集端始终写 logs-app-prod;generation: 1 表示当前只有第一代。生产环境还应根据故障域与容量规划调整主分片、副本、mapping 和生命周期策略,不要照搬示例中的单主分片配置。
Rollover 如何切换写入索引
Rollover 会创建新的 backing index、递增 generation,并把新一代设为 write index;旧一代仍属于同一个 Data Stream,因此查询方不用改索引名。下面手工 rollover 用于观察机制,它会立即执行,不带容量条件。
POST logs-app-prod/_rollover?filter_path=old_index,new_index,rolled_over

GET _data_stream/logs-app-prod?filter_path=data_streams.name,data_streams.generation,data_streams.indices.index_name
预期输出
{"old_index":"<OLD_BACKING_INDEX>","new_index":"<NEW_BACKING_INDEX>","rolled_over":true}
{"data_streams":[{"name":"logs-app-prod","indices":[{"index_name":"<OLD_BACKING_INDEX>"},{"index_name":"<NEW_BACKING_INDEX>"}],"generation":2}]}
实际 backing index 名称会包含创建日期和代次。手工 rollover 适合验证或运维操作;生产持续写入通常应交给 ILM 或相应的数据生命周期机制,根据分片大小、文档数和年龄自动触发。
写入与修改的边界
正常写入应始终以 Data Stream 名称为目标,不要让采集端写 .ds-* backing index。查询同样优先使用 Data Stream 名称,这样 rollover 后无需维护索引列表。
需要更新或删除历史文档时,要先搜索得到文档所在 backing index,再直接针对该 backing index 执行更新或删除;当前 write index 也不能直接被删除,必须先 rollover 让新的 backing index 接管写入。这个限制正是 Data Stream 强调“持续追加、集中读取”工作负载的体现。
把 Data Stream 当作稳定的数据入口,把 backing index 当作生命周期和分片治理单元:采集端只认逻辑名称,运维侧才关注每一代索引的大小、分片与保留状态。这样 rollover、迁移数据层级和删除历史数据都能与业务写入解耦。