
NoSQL 与搜索 / 系统课时
排查 Indexing Pressure 与写入拒绝
排查 Indexing Pressure 与写入拒绝
写入出现 429 Too Many Requests 时,不能只看到“rejected”就扩容线程池。Elasticsearch 可能因为 indexing pressure 的内存保护拒绝请求,也可能因为写入线程池排队耗尽而拒绝。本课用同一套节点指标区分两条路径,并沿 coordinating、primary、replica 阶段定位压力来源。
学习目标
- 能区分 indexing pressure 拒绝与写入线程池拒绝
- 能根据 coordinating、primary、replica 指标判断压力停在哪个写入阶段
- 能用削峰、缩小 bulk、降低并发和消除热点恢复稳定写入
先按拒绝路径分类
一次外部写入会经历 coordinating、primary 和 replica 阶段。Indexing pressure 会为尚未完成的写入记账;上游阶段要等下游完成后才释放对应占用,因此慢 primary、慢 replica 或过大的并发 bulk 都可能让在途字节长期堆积。另一方面,真正执行写任务还要经过写入线程池。Elasticsearch 9.1+ 将 bulk 协调放到 write_coordination,实际 shard 写入仍使用 write;较旧版本的 bulk 协调也走 write。任一有界队列耗尽都可能产生拒绝。
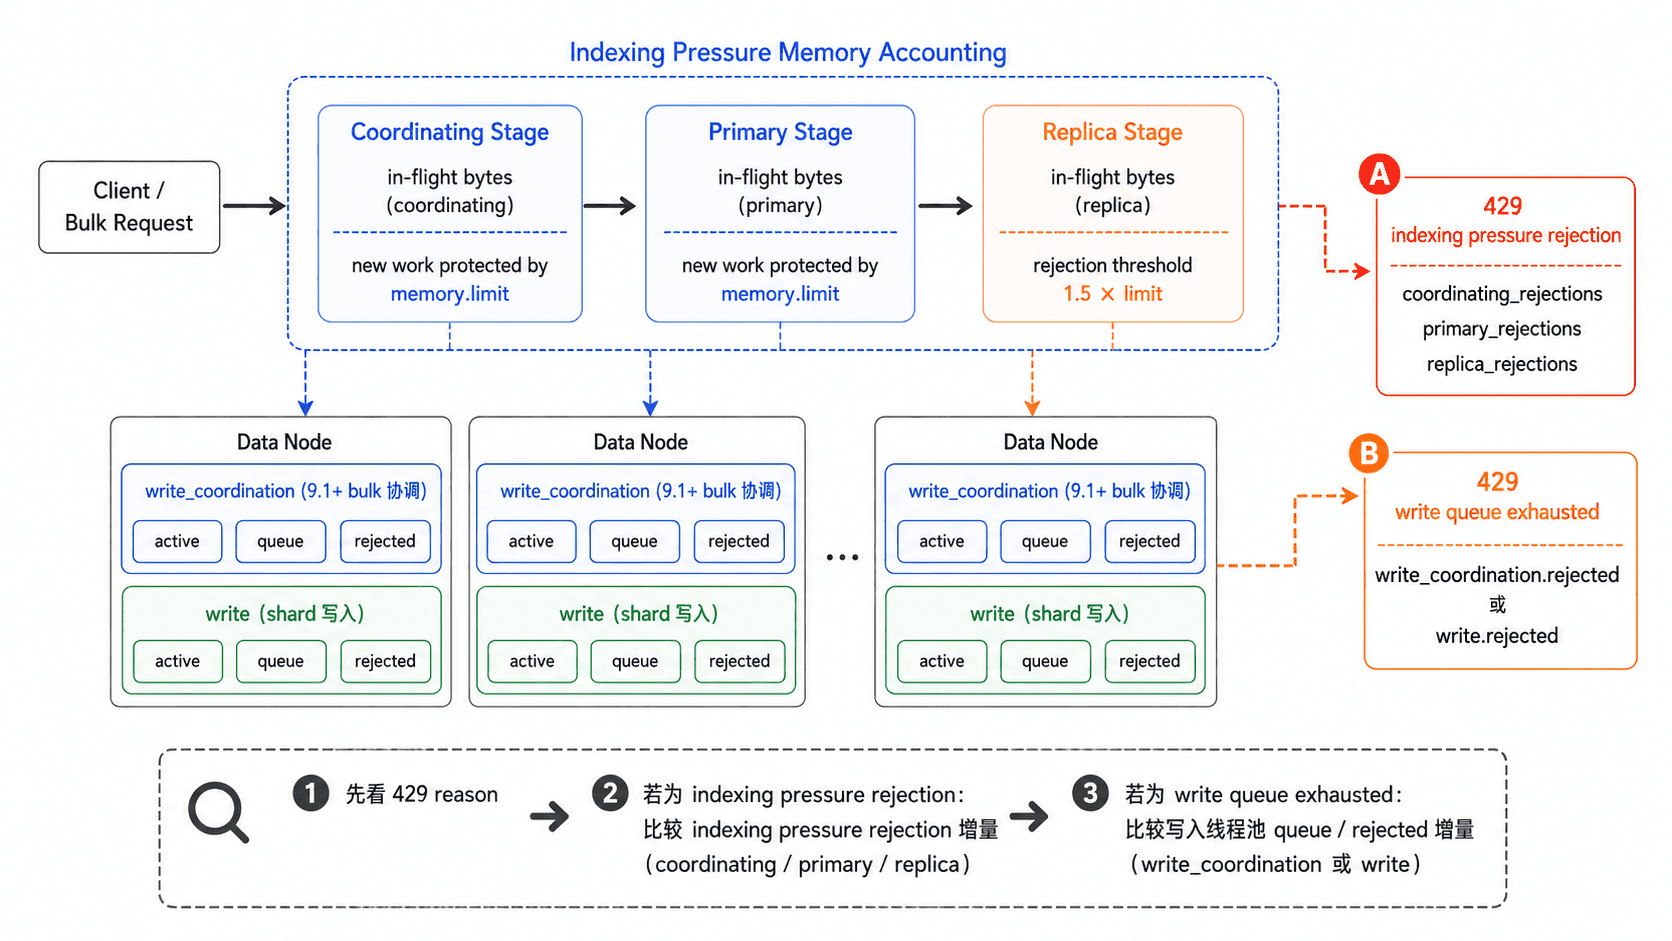
因此第一步不是调参数,而是读取 429 响应里的 error.reason,再把它与节点统计对齐。Indexing pressure 的默认内存限制是节点堆的 10%;达到限制时会优先阻止新的 coordinating/primary 工作,而 replica 阶段有更高的保护阈值,用来让已经接受的复制工作尽可能完成。
一次采集 Pressure 与线程池
下面命令同时抓取 indexing pressure 当前占用、累计拒绝数,以及 write、write_coordination 线程池的 active、queue、rejected、completed。ES_URL 与 ES_API_KEY 需要预先设置,API Key 至少具备节点监控权限。
curl -sS \
  -H "Authorization: ApiKey $ES_API_KEY" \
  "$ES_URL/_nodes/stats/indexing_pressure,thread_pool?filter_path=nodes.*.name,nodes.*.indexing_pressure.memory.current,nodes.*.indexing_pressure.memory.total.coordinating_rejections,nodes.*.indexing_pressure.memory.total.primary_rejections,nodes.*.indexing_pressure.memory.total.replica_rejections,nodes.*.indexing_pressure.memory.limit_in_bytes,nodes.*.thread_pool.write.active,nodes.*.thread_pool.write.queue,nodes.*.thread_pool.write.rejected,nodes.*.thread_pool.write.completed,nodes.*.thread_pool.write_coordination.active,nodes.*.thread_pool.write_coordination.queue,nodes.*.thread_pool.write_coordination.rejected,nodes.*.thread_pool.write_coordination.completed"
预期结果
HTTP 层返回 200,响应中每个 nodes.<ID> 可见:
indexing_pressure.memory.current.*
indexing_pressure.memory.total.coordinating_rejections
indexing_pressure.memory.total.primary_rejections
indexing_pressure.memory.total.replica_rejections
indexing_pressure.memory.limit_in_bytes
thread_pool.write.active
thread_pool.write.queue
thread_pool.write.rejected
thread_pool.write.completed
thread_pool.write_coordination.*              # Elasticsearch 9.1+ 可见
实际数值随节点负载变化。
active 和 queue 是当前状态,rejected、completed 以及 indexing pressure 的拒绝计数是累计值。排障时应固定 10~30 秒采样间隔比较增量;节点重启会重置累计计数,所以不能把不同启动周期直接相减。
用增量判断是哪一层先满
如果 indexing pressure 的某类 rejection 持续增加,同时 current 中在途字节长期接近限制,而 write.rejected 没有明显增长,优先按内存准入压力处理。coordinating_rejections 增长通常说明入口节点接收新批次过快;primary_rejections 或 replica_rejections 则要继续检查对应 shard 所在节点为何无法及时完成。
如果 write.queue 或 write_coordination.queue 长时间维持高位,并且对应 rejected 增长,而 indexing pressure rejection 基本不变,说明线程池处理能力先耗尽。根因可能是 CPU 饱和、磁盘写入或 merge 变慢、热点 shard、复杂 ingest pipeline,或客户端并发超过节点持续处理能力。
两类计数同时增长并不矛盾:线程池消化变慢会延长请求生命周期,在途内存随后升高,最终又触发 indexing pressure。此时应按时间顺序找“第一个恶化的信号”,避免把二级保护机制误判成根因。
从压力来源回到写入模型
最常见的外部原因是 bulk 太大或并发 worker 太多。单个 bulk 越大、同时在途请求越多,协调阶段需要保留的字节越多;当多个请求又集中到少量 primary shard 时,还会形成节点级热点。
慢 replica 也会放大前级压力。Primary 为保证复制语义,需要等待 in-sync replica 的结果;如果某个副本节点磁盘、网络或 merge 长期落后,请求占用会更久,coordinating/primary 侧的记账也更难快速释放。因此看到 primary 压力时,不要只检查 primary 所在节点。
修复顺序与验证标准
先降低客户端并发,再把 bulk 调整到压测得到的稳定区间;如果拒绝集中在单个节点或 shard,再处理 routing 热点、shard 分布、磁盘或 CPU 瓶颈。只有证明默认保护阈值与经过容量验证的工作负载不匹配时,才评估 indexing_pressure.memory.limit,因为提高它会把更多堆交给在途索引请求,并不会增加磁盘或 CPU 的实际处理能力。
修复后用同一命令重复采样。理想结果是业务负载恢复后 write.queue 与存在时的 write_coordination.queue 能及时回落,相应 rejected 与三类 pressure rejection 在观察窗口内不再增长,在途字节远离长期高水位,同时端到端写入延迟回到基线。只要拒绝数停止增长但队列仍长期堆积,就说明系统仍在临界点上,还没有真正恢复余量。