
NoSQL 与搜索 / 系统课时
排查 Master 选举抖动
排查 Master 选举抖动
Master 反复切换会让集群状态发布、节点加入和分片分配不断被打断。排查时应先证明发生了重复选举,再区分网络失联、cluster state 发布失败和 master 资源停顿,优先恢复协调面稳定,而不是直接修改选举或故障检测参数。
学习目标
- 从 master-eligible 节点日志确认重复选举与失稳时间线
- 区分故障检测、集群状态发布和资源压力造成的主节点切换
- 用 pending tasks 与 master 节点指标验证协调面是否恢复
先证明发生了重复选举
真正的 Master 选举抖动应在 master-eligible 节点日志中反复看到 elected-as-master,其他节点会记录 master node changed。如果一段时间内没有任何节点赢得选举,还应检查 ClusterFormationFailureHelper 的日志,确认发现到的节点与形成法定人数所需条件。
先在所有 master-eligible 节点的同一时间窗口筛选协调日志:
ES_LOG="<PATH>"
grep -Ei 'elected-as-master|master node changed|ClusterFormationFailureHelper|master_not_discovered_exception' "$ES_LOG"
预期输出若显示短时间内不同节点反复成为 master,即可确认抖动;时间和节点名以现场为准:
[<TIME>][INFO ][o.e.c.c.Coordinator] [es-master-1] master node changed ...
[<TIME>][INFO ][o.e.c.c.Coordinator] [es-master-2] ... elected-as-master ...
[<TIME>][INFO ][o.e.c.c.Coordinator] [es-master-3] master node changed ...
不要把单次计划内重启后的重新选举判成抖动。先确认是否存在高频重复事件,以及选举前是否伴随节点掉线、网络超时、长暂停或 cluster state 发布异常。
按三条失稳路径定位
Master 稳定依赖 master-eligible 节点之间的发现、投票和持续通信。集群状态发布需要先获得足够确认完成提交,再让各节点应用;如果一次发布在允许时间内无法完成提交,elected master 会认为自身无法继续履职并退出主节点角色。发布速度还会受到 master-eligible 节点存储延迟与节点间网络质量影响。cluster.publish.timeout 约束的是发布完成 commit 的窗口;若状态已经 commit,只是某个 follower 长时间未应用,则应按 lagging 节点处理,不应误判为同一种 master 发布失败。
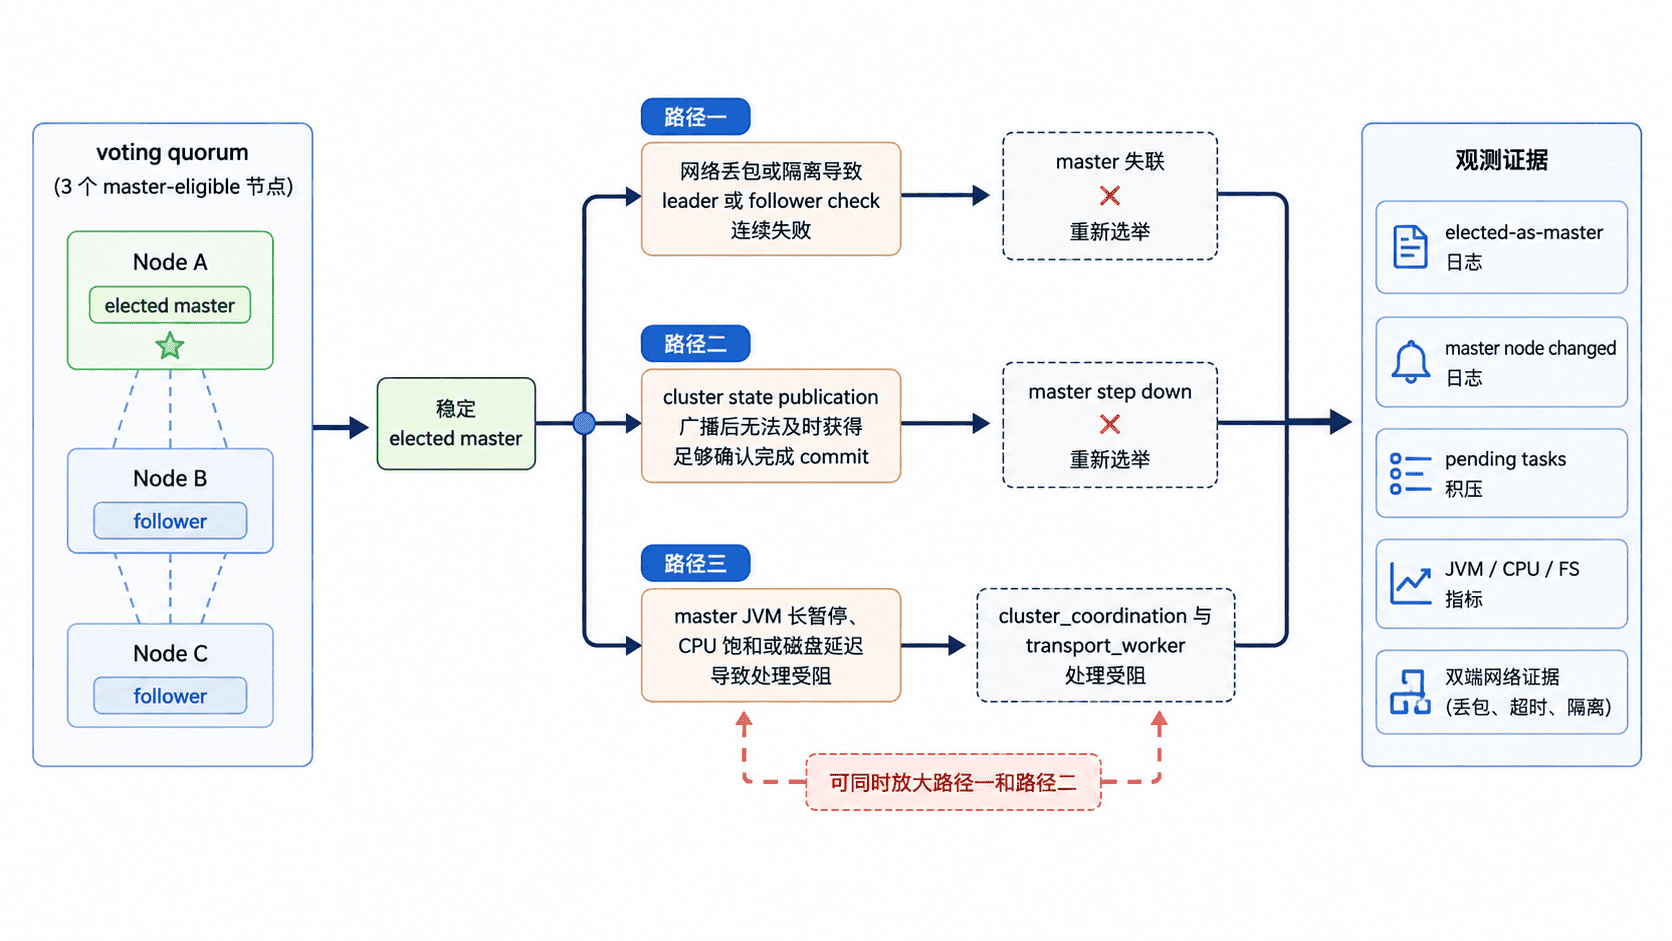
网络路径的关键问题是 master-eligible 节点能否稳定发现彼此并维持 transport 通信;发布路径要找 cluster state 提交或应用变慢的证据;资源路径则关注 elected master 是否出现长 GC、CPU 饱和、慢磁盘或协调线程长时间得不到执行。三者可能同时发生,因此必须按时间戳关联,而不是只看某一项平均值。
检查协调队列与 Master 资源
先获取当前 master ID,再查看 pending cluster tasks 和该节点的资源快照。pending tasks 持续增长说明 master 处理集群状态变更的速度落后于进入速度,但它只是结果,仍要结合任务来源和节点资源判断根因。
ES_URL="https://<HOST>:9200"
ES_CA="<PATH>"
ES_USER="<USER>"
ES_PASS="<PASSWORD>"
MASTER_RESULT="$(curl --cacert "$ES_CA" -u "$ES_USER:$ES_PASS" -sS -w '\nHTTP_STATUS:%{http_code}\n' "$ES_URL/_cat/master?h=id")"
printf '%s\n' "$MASTER_RESULT"
MASTER_ID="$(printf '%s\n' "$MASTER_RESULT" | head -n 1 | xargs)"
curl --cacert "$ES_CA" -u "$ES_USER:$ES_PASS" -sS -w '\nHTTP_STATUS:%{http_code}\n'   "$ES_URL/_cluster/pending_tasks?filter_path=tasks.insert_order,tasks.priority,tasks.source,tasks.time_in_queue_millis"
curl --cacert "$ES_CA" -u "$ES_USER:$ES_PASS" -sS -w '\nHTTP_STATUS:%{http_code}\n'   "$ES_URL/_nodes/$MASTER_ID/stats/jvm,os,process,fs,transport?filter_path=nodes.*.name,nodes.*.jvm.mem.heap_used_percent,nodes.*.os.cpu.percent,nodes.*.process.cpu.percent,nodes.*.fs.total.available_in_bytes,nodes.*.transport.server_open"
预期结果是 pending tasks 列表和当前 master 的关键资源指标;没有积压时 tasks 为空数组,动态值以现场为准:
<MASTER_ID>
HTTP_STATUS:200
{"tasks":[]}
HTTP_STATUS:200
{"nodes":{"<MASTER_ID>":{"name":"es-master-1","jvm":{"mem":{"heap_used_percent":<VALUE>}},"os":{"cpu":{"percent":<VALUE>}},"process":{"cpu":{"percent":<VALUE>}},"fs":{"total":{"available_in_bytes":<VALUE>}},"transport":{"server_open":<VALUE>}}}}
HTTP_STATUS:200
若积压主要由频繁索引创建、mapping 更新、分片重分配等 cluster state 变更驱动,应先降低变更速率或缩小不必要的元数据规模;若 master 本身资源紧张,则为 master-eligible 节点恢复 CPU、堆、磁盘与网络余量。生产集群宜保持少量且稳定的 master-eligible 节点,避免让它们承担会争用资源的重负载。
验证协调面已经恢复
修复后要确认同一个 master 能持续保持不变,日志不再出现新的重复选举,同时 pending tasks 不再持续积压。可以做一个短时间连续观测:
ES_URL="https://<HOST>:9200"
ES_CA="<PATH>"
ES_USER="<USER>"
ES_PASS="<PASSWORD>"
for i in 1 2 3; do
  curl --cacert "$ES_CA" -u "$ES_USER:$ES_PASS" -sS -w '\nHTTP_STATUS:%{http_code}\n' "$ES_URL/_cat/master?h=id,node&format=json"
  sleep 5
done
预期输出三次都指向同一 master;ID 和节点名按现场变化:
[{"id":"<MASTER_ID>","node":"es-master-1"}]
HTTP_STATUS:200
[{"id":"<MASTER_ID>","node":"es-master-1"}]
HTTP_STATUS:200
[{"id":"<MASTER_ID>","node":"es-master-1"}]
HTTP_STATUS:200
只有“主节点稳定、协调日志安静、pending tasks 不再累积、master 资源有余量”同时成立,才能认为选举抖动已恢复;如果仅靠延长超时让告警暂时消失,根因通常仍然存在。