
NoSQL 与搜索 / 系统课时
设计扩容阈值与容量余量
设计扩容阈值与容量余量
扩容不能等到 Elasticsearch 开始保护磁盘后才讨论。可执行的容量策略应把业务预警、扩容决策和集群保护阈值分开,并用增长速度换算“还剩多少天”,让采购、变更和数据迁移都留有时间。
学习目标
- 区分业务扩容阈值与 Elasticsearch 自身的磁盘保护水位
- 用磁盘、分片和节点增长速度计算扩容提前量
- 根据瓶颈类型选择横向扩容、纵向扩容或先调整分片模型
把保护阈值和扩容阈值拆开
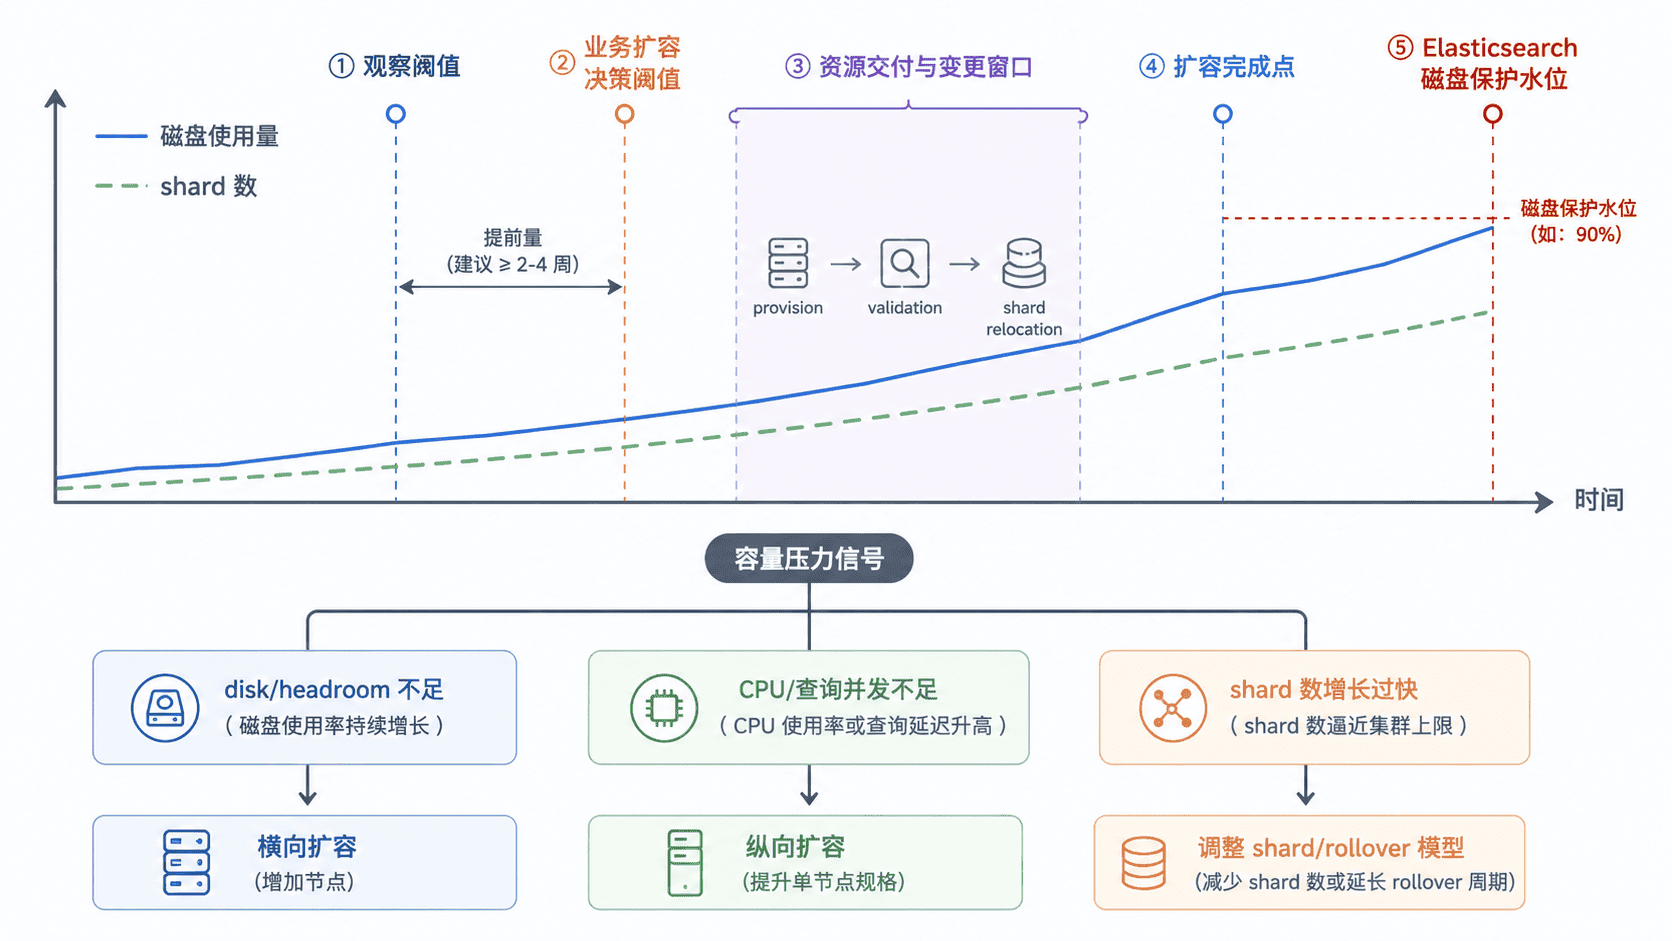
Elasticsearch 的磁盘 allocation watermarks 用于限制继续分配、触发迁移或保护写入,它们属于最后一道安全机制,不应直接充当日常扩容触发器。业务阈值必须更早,因为新增节点、滚动变更和 shard relocation 都需要时间与额外空间。
| 层级 | 目的 | 触发后动作 |
|---|---|---|
| 观察阈值 | 发现增长趋势改变 | 核对写入量、保留周期、shard 增速 |
| 扩容决策阈值 | 给实施留出提前量 | 决定增节点、增规格或调整数据生命周期 |
| 集群保护阈值 | 防止磁盘继续恶化 | 由 Elasticsearch allocation 机制执行保护 |
扩容看的是“距保护边界还有多少可操作空间”,而不是单看当前磁盘百分比。一个 20 TB 节点和一个 2 TB 节点即使使用率相同,剩余绝对空间和可容纳的 shard 数也完全不同。
用剩余天数计算提前量
设扩容决策边界对应的可用容量为 ,当前已用容量为 ,近期净增长速度为 ,则距离触发边界的时间可以估算为:
不要只用长期平均增长量。日志突增、保留期变化或大规模 reindex 会让短期增速显著偏高,实际告警更适合采用近期高分位增长速度或按业务峰值做情景估算。
扩容触发条件可以写成:当 daysToThreshold 小于“资源交付时间 + 变更验证时间 + shard 迁移时间 + 安全缓冲”时进入实施,而不是等磁盘已经逼近保护阈值。
读取当前容量和生效水位
先采集每个节点的磁盘与 shard 分布,再读取集群实际生效的 watermarks。这样可以避免把文档默认值、云平台默认值或历史手工配置误当成当前值。
export ES_URL="https://<HOST>:<PORT>"
export ES_API_KEY="<API_KEY>"
# 节点级数据用于计算最坏节点,而不是只看集群平均磁盘利用率。
curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_cat/allocation?format=json&bytes=gb&h=node,shards,disk.used,disk.avail,disk.total,disk.percent"
# include_defaults 让未显式配置的生效默认值也可被核对。
curl -sS -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_cluster/settings?include_defaults=true&filter_path=persistent.cluster.routing.allocation.disk.watermark,transient.cluster.routing.allocation.disk.watermark,defaults.cluster.routing.allocation.disk.watermark"
预期输出
[{"node":"<NODE>","shards":"<VALUE>","disk.used":"<VALUE>","disk.avail":"<VALUE>","disk.total":"<VALUE>","disk.percent":"<VALUE>"}, ...]
{"persistent":{"cluster":{"routing":{"allocation":{"disk":{"watermark":{...}}}}}},"transient":{...},"defaults":{"cluster":{"routing":{"allocation":{"disk":{"watermark":{"low":"<VALUE>","high":"<VALUE>","flood_stage":"<VALUE>",...}}}}}}}
实际返回会受版本、部署方式和显式配置影响。容量面板应保留节点级最大值或最小余量,否则某个热点节点可能先进入保护状态,而集群平均值仍看起来健康。
决定横向还是纵向扩容
磁盘余量下降、CPU 饱和和 shard 数增长代表不同问题,不能统一用“加大机器”处理。横向扩容适合需要更多故障承载空间、更多 shard 放置位置或更高查询并行能力的场景;纵向扩容更适合节点数与拓扑已经合理,但单节点 CPU、内存或磁盘容量不足的场景;同一 data tier 内应尽量保持节点规格一致,避免分配后形成新的热点。
如果 shard 数增长很快但单 shard 很小,继续加节点只是把过度分片向后推,应先调整 primary 数、rollover 或保留策略。反过来,如果单 shard 过大导致 recovery 超时,单纯增加磁盘也不会缩短需要复制的数据量,应先重新设计 shard size。
容量余量至少要覆盖三部分:既定故障模型下一个节点或故障域失效后需要重新放置的数据、从触发扩容到资源就绪期间的业务增长,以及 relocation、merge 等后台操作需要的临时空间。把这三部分显式纳入阈值后,扩容就从“磁盘快满了再处理”变成可以提前执行和验证的工程规则。