
NoSQL 与搜索 / 系统课时
控制维护期间的 Shard Recovery
控制维护期间的 Shard Recovery
维护窗口里,Shard Recovery 会和搜索、写入争抢磁盘、网络与 CPU。本课用可观测数据控制恢复速率与并发,避免为了“尽快变绿”反而把前台延迟推高,并在维护结束后恢复正常分片调度。
学习目标
- 用 Recovery API 判断当前恢复类型、源节点、目标节点和进度。
- 区分恢复带宽、节点并发与集群重平衡并发三个控制维度。
- 在短时节点维护前后正确限制分配,并完成恢复验收。
先把 Recovery 当成资源预算
Peer Recovery 会把分片文件和后续操作从源分片同步到目标分片;节点离开、分片重定位、扩副本等动作都可能触发它。维护期间真正要优化的是“前台 SLO 可接受时的最大恢复吞吐”,而不是单独追求最短恢复时间。
indices.recovery.max_bytes_per_sec 控制每个节点用于恢复的总入站和出站流量。普通数据节点的默认值通常为 40mb;专用 cold/frozen 节点会按节点内存采用不同默认值。动态修改该设置会把同一上限应用到所有节点,因此异构节点要谨慎统一下发。
节点级并发由 cluster.routing.allocation.node_concurrent_incoming_recoveries 和 cluster.routing.allocation.node_concurrent_outgoing_recoveries 控制,默认均为 2。官方不建议为了追求速度直接调大;更高并发可能增加 I/O 竞争,却未必明显缩短总耗时。cluster.routing.allocation.cluster_concurrent_rebalance 只限制“因为集群失衡而发生”的并发重定位,不会限制由 allocation filtering 或 forced awareness 触发的迁移。
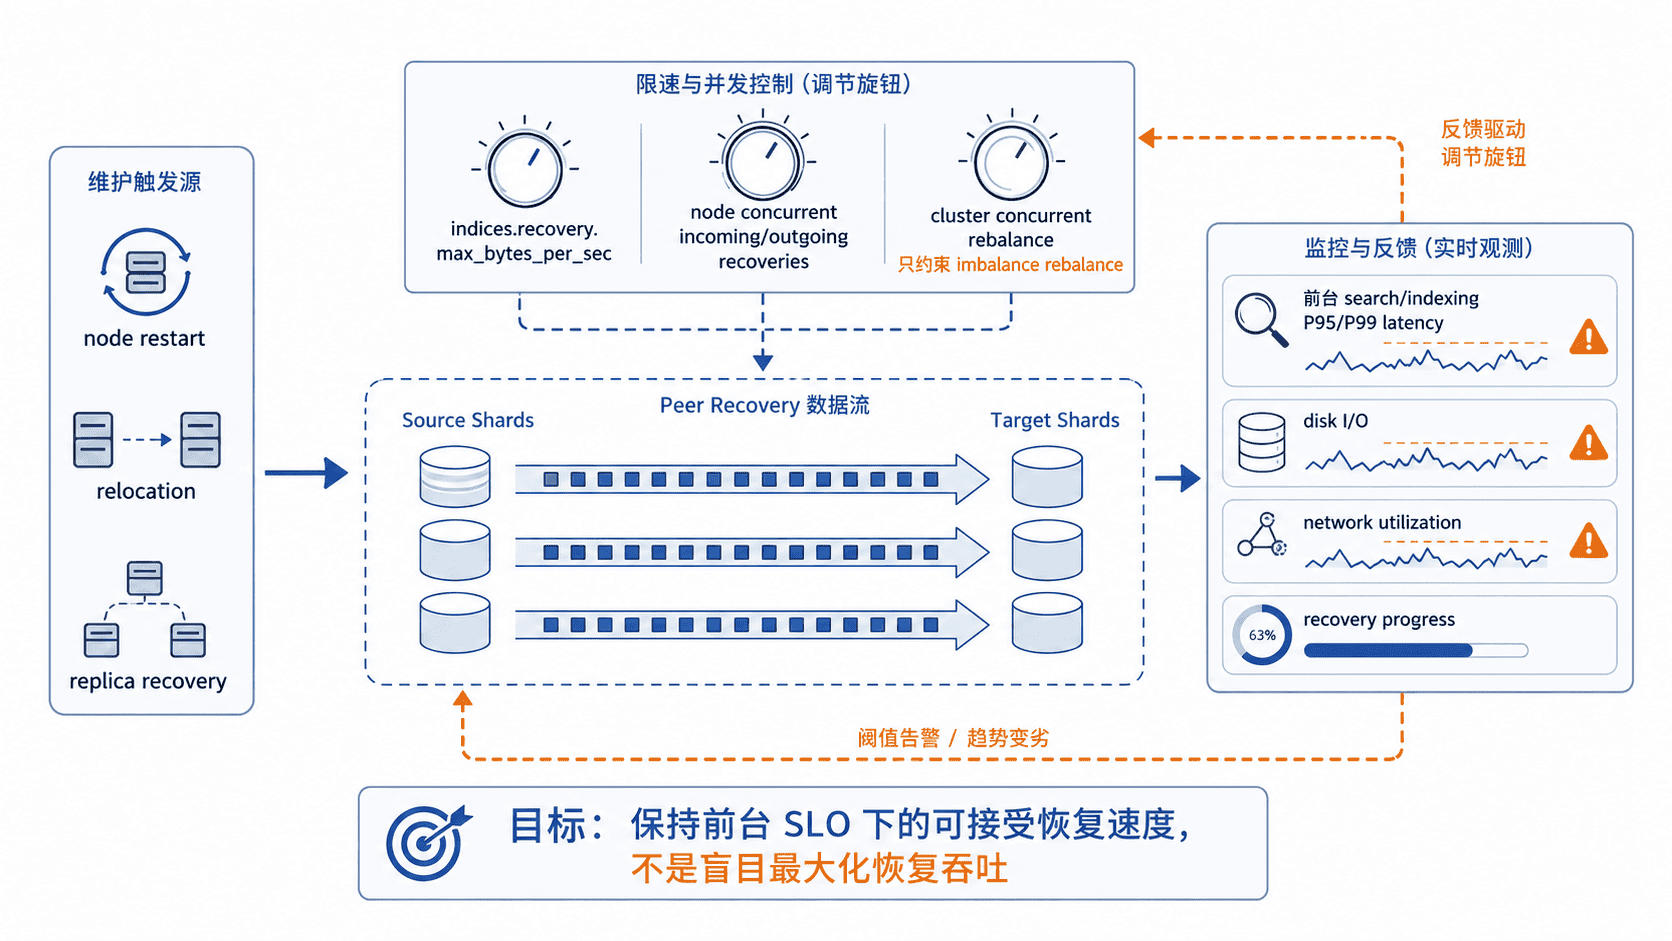
先观察再调参数
下面示例假设已设置 ES_URL 与具有 monitor 权限的 API Key。active_only=true 只看正在恢复的分片,重点关注恢复类型、阶段、源/目标节点、字节进度与持续时间。
export ES_URL='https://<HOST>:<PORT>'
export ES_API_KEY='<API_KEY>'

curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cat/recovery?active_only=true&format=json&h=index,shard,type,stage,source_node,target_node,bytes_percent,time"   -w '\nHTTP_STATUS=%{http_code}\n'
预期输出(存在活动恢复时,实际索引、节点、进度与时间会不同):
[{"index":"<INDEX>","shard":"<SHARD>","type":"peer","stage":"<VALUE>","source_node":"<SOURCE_NODE>","target_node":"<TARGET_NODE>","bytes_percent":"<VALUE>%","time":"<TIME>"}]
HTTP_STATUS=200
如果前台 P95/P99 延迟、磁盘 await 或网络利用率已经接近容量边界,再提高恢复速度通常只会放大争用。先确认瓶颈资源,再决定是降低带宽上限、降低并发,还是保持默认值等待恢复完成。
优先调带宽,谨慎碰并发
自管集群可以通过 Cluster Update Settings API 动态设置恢复带宽。下面把每节点恢复上限临时控制为 80mb,这只是操作示例,不是通用推荐值;生产值应从当前链路带宽、磁盘余量和前台延迟反推。调用该 API 需要 manage 集群权限。
curl -sS -X PUT -H "Authorization: ApiKey ${ES_API_KEY}" -H 'Content-Type: application/json' "${ES_URL}/_cluster/settings?flat_settings=true" -d '{"persistent":{"indices.recovery.max_bytes_per_sec":"80mb"}}' -w '\nHTTP_STATUS=%{http_code}\n'预期输出(若集群已有其他持久或临时设置,响应中还会包含它们):
{"acknowledged":true,"persistent":{"indices.recovery.max_bytes_per_sec":"80mb"},"transient":{}}
HTTP_STATUS=200
带宽限制仍压不住 I/O 竞争时,才考虑把节点入站或出站恢复并发从默认 2 暂时降到 1。不要默认把并发调高,也不要误以为 cluster.routing.allocation.cluster_concurrent_rebalance 能限制所有迁移来源。
短时重启避免无意义副本迁移
如果维护动作只是短时间重启一个数据节点,可以在停机前把新的分片分配限制为 primary。这样节点短暂离开时不会立刻为了副本缺失而制造大量网络复制;该设置只影响后续分配,不会把已经分配的分片主动卸载。非必要写入可暂停时,再执行一次 flush 能缩短后续恢复路径。
curl -sS -X PUT   -H "Authorization: ApiKey ${ES_API_KEY}"   -H 'Content-Type: application/json'   "${ES_URL}/_cluster/settings?flat_settings=true"   -d '{"persistent":{"cluster.routing.allocation.enable":"primaries"}}'   -w '\nHTTP_STATUS=%{http_code}\n'

curl -sS -X POST   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_flush"   -w '\nHTTP_STATUS=%{http_code}\n'
预期输出:
{"acknowledged":true,"persistent":{"cluster.routing.allocation.enable":"primaries"},"transient":{}}
HTTP_STATUS=200
{"_shards":{"total":<VALUE>,"successful":<VALUE>,"failed":0}}
HTTP_STATUS=200
节点启动并重新加入集群后,应尽快恢复正常 allocation;不要为了减少恢复流量长期保持 primaries,否则副本无法重新分配,集群会持续处于降级冗余状态。
恢复基线并完成验收
维护结束后,把临时恢复限速和 allocation 限制都删除。将动态设置写成 null 表示移除覆盖值,让 Elasticsearch 回到节点配置或默认值。随后等待 relocation 完成,再检查是否仍有 initializing 或 unassigned shard。
curl -sS -X PUT   -H "Authorization: ApiKey ${ES_API_KEY}"   -H 'Content-Type: application/json'   "${ES_URL}/_cluster/settings?flat_settings=true"   -d '{"persistent":{"indices.recovery.max_bytes_per_sec":null,"cluster.routing.allocation.enable":null}}'   -w '\nHTTP_STATUS=%{http_code}\n'

curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cluster/health?wait_for_no_relocating_shards=true&timeout=5m&filter_path=status,relocating_shards,initializing_shards,unassigned_shards"   -w '\nHTTP_STATUS=%{http_code}\n'
预期输出(高可用且副本配置完整的集群最终应为 green):
{"acknowledged":true,"persistent":{},"transient":{}}
HTTP_STATUS=200
{"status":"green","relocating_shards":0,"initializing_shards":0,"unassigned_shards":0}
HTTP_STATUS=200
最后再对比维护前后的搜索与写入延迟、节点 I/O、网络利用率和 Recovery 完成时间。只有“集群恢复完成”与“前台 SLO 未明显恶化”同时成立,维护期间的 Recovery 策略才算验收通过。