
NoSQL 与搜索 / 系统课时
排查节点频繁加入退出
排查节点频繁加入退出
节点反复离开又加入集群时,先不要追着黄色分片或恢复任务处理;真正要做的是还原节点成员变更时间线,再把离群原因与 JVM、网络、资源争用和维护事件对齐,最终证明节点为什么掉线、修复后是否持续稳定。
学习目标
- 从 elected master 日志识别节点退出与重新加入的时间线
- 区分重启、连接断开、状态应用滞后和 follower check 失败
- 用节点指标与主机事件定位 JVM、网络或资源争用根因
先锁定节点为什么离开
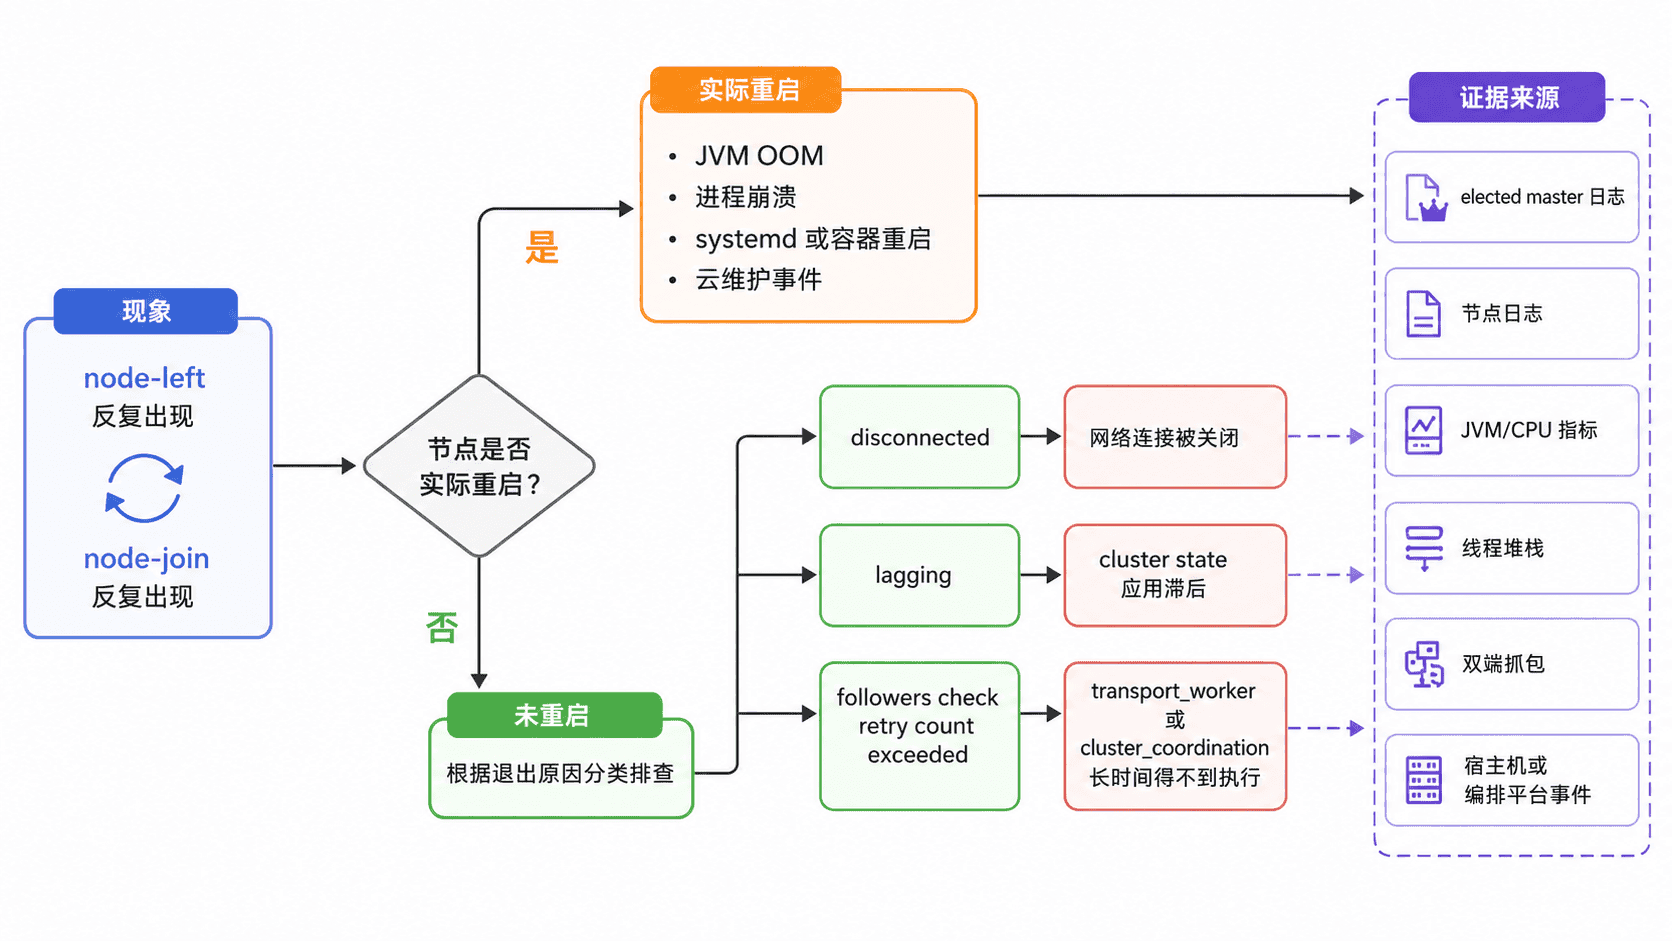
排查 node flapping 的第一证据应来自当时的 elected master 日志,而不是某一刻的集群指标。Elasticsearch 会在成员变化时记录 NodeLeftExecutor 与 NodeJoinExecutor 相关信息;若节点未重启却反复离群,应继续沿退出原因追查。
先在 elected master 上收窄时间窗口并提取成员变化、主节点变化与进程异常。下面假设日志路径保存在 ES_LOG,实际文件位置按部署方式替换:
ES_LOG="<PATH>"
grep -Ei 'node-left|node-join|master node changed|elected-as-master|OutOfMemoryError|fatal' "$ES_LOG"
预期输出会出现与故障时间一致的成员事件,实际时间、节点 ID 和地址会不同:
[<TIME>][INFO ][o.e.c.c.NodeLeftExecutor] [es-master-1] node-left: [{es-data-2}{<ID>}...] with reason [disconnected]
[<TIME>][INFO ][o.e.c.c.NodeJoinExecutor] [es-master-1] node-join: [{es-data-2}{<ID>}...]
如果 node-join 表明节点是重启后加入,优先回到该节点的 Elasticsearch、systemd、容器或云平台事件中找退出原因。若没有重启,则重点看 disconnected、lagging 或 follower check 连续失败:它们分别更偏向连接被关闭、节点未及时应用集群状态、节点未及时响应协调健康检查。
把离群时间与资源指标对齐
确认可疑节点后,用 Nodes Stats 获取同一节点的 JVM、CPU 与 transport 指标。这个快照不能替代日志时间线,但能帮助判断节点是否长期处于高堆占用、CPU 饱和或 transport 异常。
ES_URL="https://<HOST>:9200"
ES_CA="<PATH>"
ES_USER="<USER>"
ES_PASS="<PASSWORD>"
curl --cacert "$ES_CA" -u "$ES_USER:$ES_PASS" -sS -w '\nHTTP_STATUS:%{http_code}\n'   "$ES_URL/_nodes/es-data-2/stats/jvm,os,process,transport?filter_path=nodes.*.name,nodes.*.jvm.mem.heap_used_percent,nodes.*.os.cpu.percent,nodes.*.process.cpu.percent,nodes.*.transport.server_open"
预期结果为 HTTP 200,并只返回目标节点的关键指标;动态值随现场变化:
{"nodes":{"<ID>":{"name":"es-data-2","jvm":{"mem":{"heap_used_percent":<VALUE>}},"os":{"cpu":{"percent":<VALUE>}},"process":{"cpu":{"percent":<VALUE>}},"transport":{"server_open":<VALUE>}}}}
HTTP_STATUS:200
如果离群前出现长 GC、CPU 抢占、磁盘或线程长时间阻塞,应先解决节点资源和工作负载;如果节点资源正常却以 disconnected 为主,则检查交换机、防火墙、NAT、MTU、内核 TCP 事件,并在 master 与故障节点两端同时抓包。若故障总与滚动升级、实例回收或自动伸缩重合,则把维护事件纳入根因,而不是继续调 Elasticsearch 超时。
修复后验证成员关系稳定
修复完成后,持续观察同一节点是否再次产生 node-left,同时确认节点数和分片恢复趋于稳定。不要仅以一次绿色健康状态作为结论。
ES_URL="https://<HOST>:9200"
ES_CA="<PATH>"
ES_USER="<USER>"
ES_PASS="<PASSWORD>"
curl --cacert "$ES_CA" -u "$ES_USER:$ES_PASS" -sS -w '\nHTTP_STATUS:%{http_code}\n'   "$ES_URL/_cluster/health?filter_path=status,number_of_nodes,relocating_shards,initializing_shards,unassigned_shards"
预期结果中 number_of_nodes 应保持在预期规模,恢复完成后 initializing、relocating 与 unassigned 数量应回落;具体值取决于集群规模:
{"status":"green","number_of_nodes":<VALUE>,"relocating_shards":0,"initializing_shards":0,"unassigned_shards":0}
HTTP_STATUS:200
最终结论要能同时解释“为什么离开”和“为什么重新加入”:若只有当前指标正常,却没有 master 日志、节点日志或平台事件支持,就还不能把 node flapping 视为已定位。