
NoSQL 与搜索 / 系统课时
使用 Index 与 Shard Stats 观察数据面
使用 Index 与 Shard Stats 观察数据面
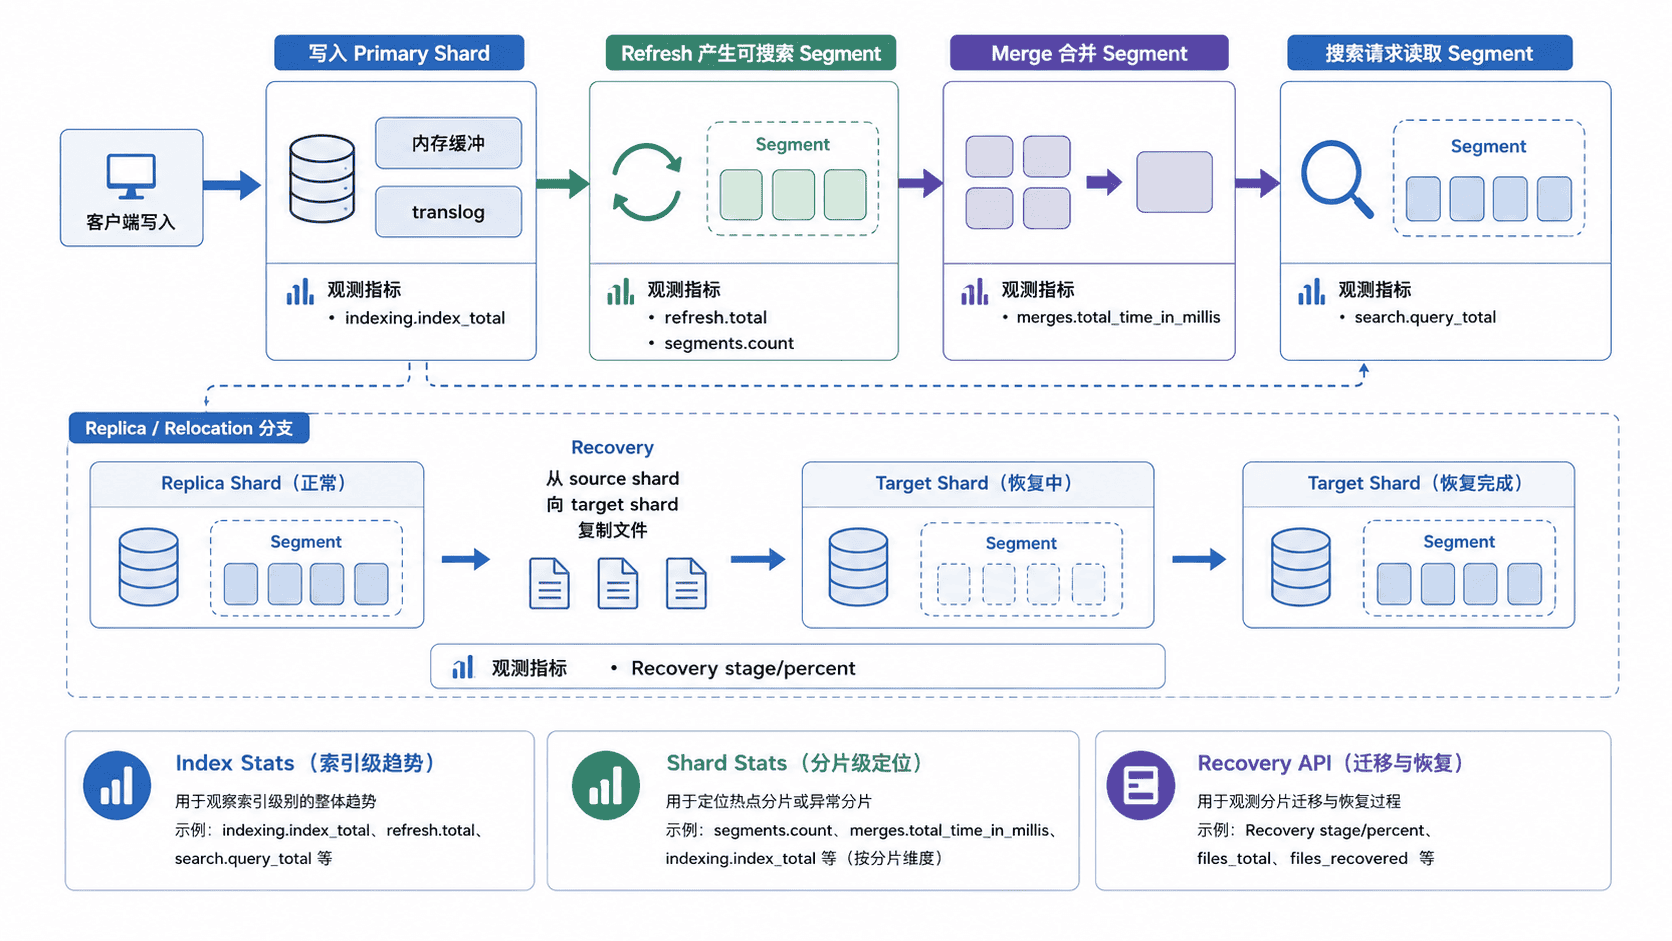
节点资源只能告诉你“机器忙不忙”,却不能解释忙在什么数据活动上。本课从索引与分片两个层级读取 indexing、search、refresh、merge、segment 与 recovery 指标,把写入、查询、段维护和副本恢复串成一条可定位的数据面链路。
学习目标
- 用 Index Stats 判断索引级读写、refresh、merge 与 segment 活动
- 下钻到 shard 级识别热点分片和副本之间的负载偏斜
- 结合 Recovery API 判断分片迁移或副本恢复是否正在消耗数据面资源
先看索引级活动
Index Stats 里的大量字段是累计计数器,因此基线应比较相邻采样点的增量,而不是只看总数。primaries.indexing 适合估算主分片承接的逻辑写入量;查询可能落到主分片或副本,所以搜索、refresh、merge 与 segment 的资源活动更应关注 total。
export ES_URL="https://es01.example.com:9200"
export ES_API_KEY="<API_KEY>"

curl -sS --cacert <PATH>/http_ca.crt   -H "Authorization: ApiKey $ES_API_KEY"   "$ES_URL/_stats/indexing,search,refresh,merge,segments?level=indices&filter_path=indices.*.primaries.indexing.index_total,indices.*.total.search.query_total,indices.*.total.refresh.total,indices.*.total.merges.total,indices.*.total.merges.total_time_in_millis,indices.*.total.segments.count"
预期输出
{
  "indices": {
    "orders-v1": {
      "primaries": {
        "indexing": {"index_total": "<VALUE>"}
      },
      "total": {
        "search": {"query_total": "<VALUE>"},
        "refresh": {"total": "<VALUE>"},
        "merges": {
          "total": "<VALUE>",
          "total_time_in_millis": "<VALUE>"
        },
        "segments": {"count": "<VALUE>"}
      }
    }
  }
}
真实响应中的统计值是数字,这里用 <VALUE> 标出动态值。如果写入速率上升后 refresh 与 segment 数同步抬高,随后 merge 时间也增加,通常说明 Lucene 段维护正在跟随写入压力工作。单看 segments.count 的绝对值不能判错,关键是它的趋势是否长期累积,以及 merge 是否有能力把小段持续合并掉。
下钻到 shard 级找热点
索引级总量正常,并不代表每个分片都均衡。把 level 改为 shards 后,可以比较同一索引各 shard copy 的写入、查询、segment 与 merge 时间。若某个主分片的增量长期显著高于其他分片,应优先检查 routing key、时间型写入热点或分片大小差异。
curl -sS --cacert <PATH>/http_ca.crt -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_stats/indexing,search,merge,segments?level=shards&filter_path=indices.*.shards.*.*.routing.node,indices.*.shards.*.*.routing.primary,indices.*.shards.*.*.indexing.index_total,indices.*.shards.*.*.search.query_total,indices.*.shards.*.*.segments.count,indices.*.shards.*.*.merges.total_time_in_millis"预期输出
{
  "indices": {
    "orders-v1": {
      "shards": {
        "0": [
          {
            "routing": {"node": "<ID>", "primary": true},
            "indexing": {"index_total": "<VALUE>"},
            "search": {"query_total": "<VALUE>"},
            "segments": {"count": "<VALUE>"},
            "merges": {"total_time_in_millis": "<VALUE>"}
          }
        ]
      }
    }
  }
}
这里仍应比较固定窗口内的增量。例如某个 shard 的 search.query_total 增速远高于其他 shard,而 CPU 热点又落在承载它的节点上,就能把“节点很忙”进一步收敛为“某个分片被高频查询”。
把 Recovery 放回同一条链路
分片 relocation、节点重启后的副本恢复或新副本创建,都会产生额外磁盘读写和网络流量。此时仅看 merge 或 indexing 容易把恢复流量误判成业务压力,可以用 Recovery API 单独确认是否存在活动恢复。
curl -sS --cacert <PATH>/http_ca.crt -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_recovery?active_only=true&detailed=true"预期结果
无活动恢复时通常返回空对象:{}
存在恢复时,响应会按索引列出正在恢复的 shard,并包含 stage、source、target 以及文件或字节恢复进度等字段;实际索引名、节点名、阶段和百分比会随恢复过程变化。
把三类观察合并后,定位顺序会更稳定:先用索引级增量确认是写入、查询还是段维护在增长,再用 shard 级统计判断是否偏斜,最后用 Recovery API 排除迁移和恢复造成的额外 I/O。这样才能把节点资源异常准确映射到具体的数据面活动。