
NoSQL 与搜索 / 系统课时
用 Rally 建立查询回归门槛
用 Rally 建立查询回归门槛
性能调优如果只比较一次压测结果,很容易把缓存、数据状态或环境噪声误当成收益。本课用固定 Rally Track、基线 Race 与候选 Race 建立可重复实验,并把延迟、吞吐和错误率转成可执行的回归门槛。
学习目标
- 固定数据集、查询组合、预热方式与目标吞吐,减少基准测试噪声。
- 使用 Rally 分别运行 baseline 与 contender,并比较同一任务的关键指标。
- 为 P95/P99 延迟、吞吐与错误率设计能进入 CI 的性能门槛。
先固定实验,而不是先看分数
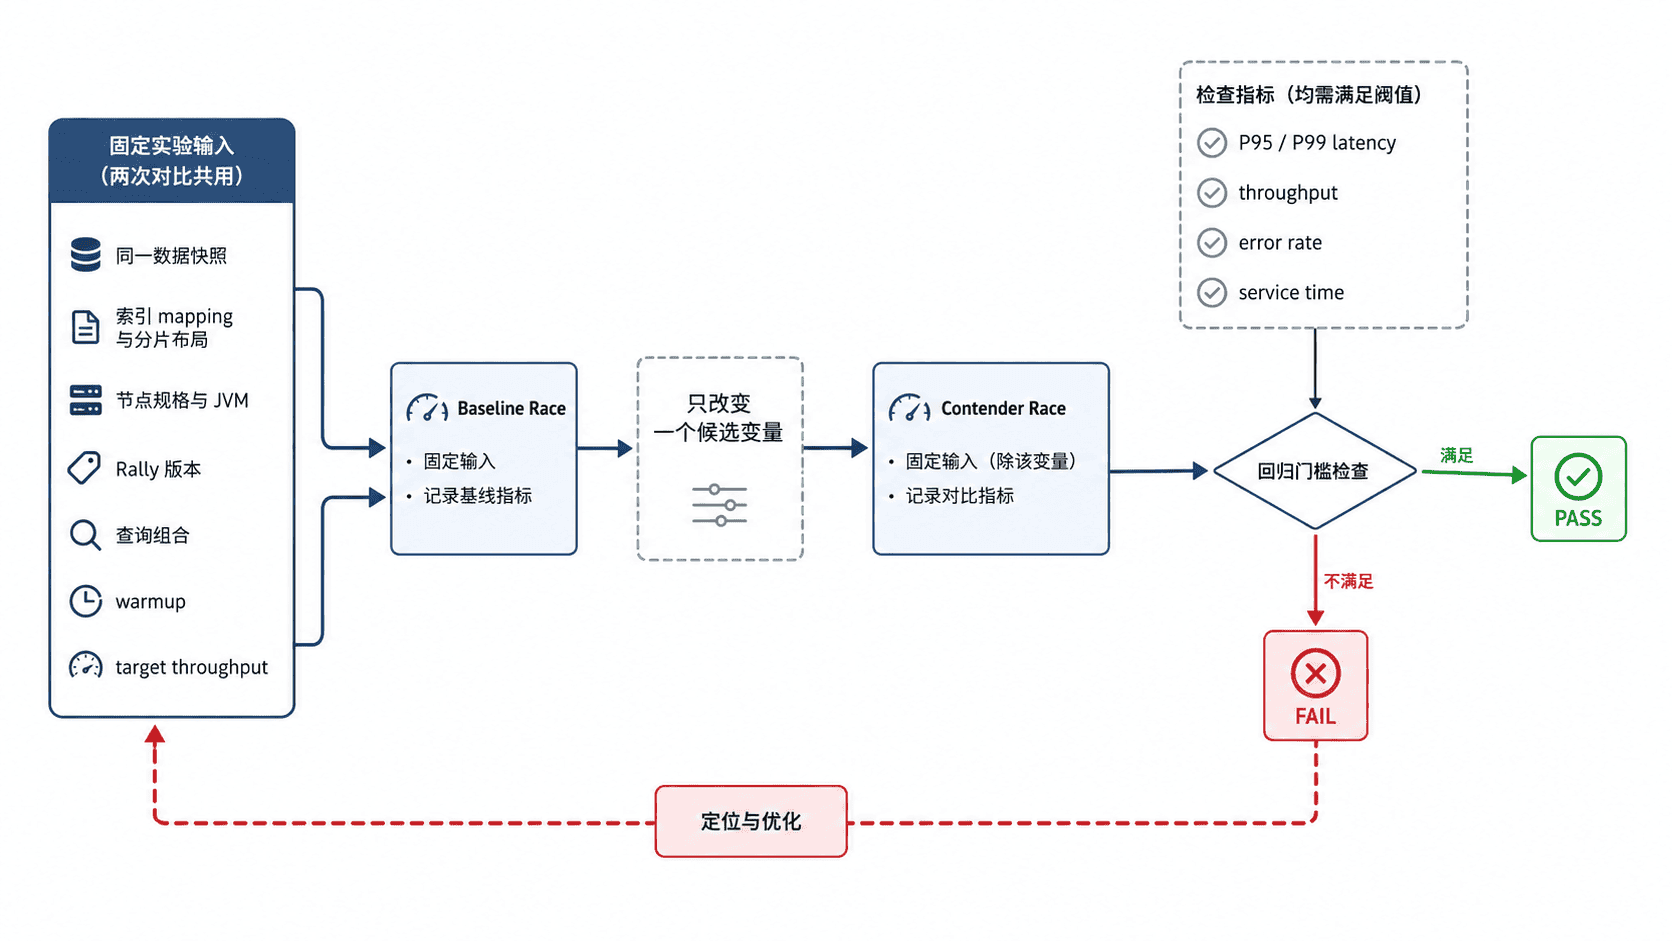
查询回归测试的核心不是“把 Rally 跑起来”,而是让两次 Race 只有一个主要变量不同。数据快照、索引 mapping、分片布局、节点规格、JVM 配置、Rally 版本、负载机位置、查询参数分布和预热时长都应固定;要验证的 Elasticsearch 版本、查询实现或集群配置才是 contender 的变量。
不要直接把生产集群当压测目标。更稳妥的做法是从同一快照恢复独立基准集群,基线与候选各从相同初始状态开始,再使用一致的 warmup 进入稳定阶段。若测试已有集群,可使用 benchmark-only pipeline,但应接受“集群由你负责复现”的前提。
用 Track 固定真实查询组合
默认 Track 更适合工具入门,真正的回归门槛应来自业务查询分布。下面的 track.json 假设基准集群已存在固定数据索引 products-bench,把精确过滤、聚合和短语查询按 80:15:5 的目标吞吐并行执行,并明确 warmup 与测量时长。
{
  "version": 2,
  "description": "query regression workload",
  "operations": [
    {
      "name": "term-filter",
      "operation-type": "search",
      "index": "products-bench",
      "body": {
        "query": {
          "term": {
            "category.keyword": "books"
          }
        }
      }
    },
    {
      "name": "brand-aggregation",
      "operation-type": "search",
      "index": "products-bench",
      "body": {
        "size": 0,
        "aggs": {
          "top_brands": {
            "terms": {
              "field": "brand.keyword",
              "size": 20
            }
          }
        }
      }
    },
    {
      "name": "phrase-search",
      "operation-type": "search",
      "index": "products-bench",
      "body": {
        "query": {
          "match_phrase": {
            "description": "wireless headphones"
          }
        }
      }
    }
  ],
  "challenges": [
    {
      "name": "query-regression",
      "default": true,
      "schedule": [
        {
          "parallel": {
            "warmup-time-period": 30,
            "time-period": 120,
            "tasks": [
              {
                "operation": "term-filter",
                "target-throughput": 80
              },
              {
                "operation": "brand-aggregation",
                "target-throughput": 15
              },
              {
                "operation": "phrase-search",
                "target-throughput": 5
              }
            ]
          }
        }
      ]
    }
  ]
}
这是完整 Track 配置,但它依赖预先准备好的 products-bench。验证时先确认三个查询都能在目标索引执行,再把文件保存为 <PATH>/track.json;不要在 baseline 与 contender 之间修改查询文本、目标吞吐或数据。
跑出可比较的两次 Race
以下命令以已安装并初始化 Rally、目标 Elasticsearch 开启 HTTPS 与基本认证为前提。先运行 baseline,完成待验证的单一变更并恢复到同样数据状态后,再运行 contender;<HOST>、<PORT>、<PATH>、<USER> 与 <PASSWORD> 需要替换为实际值。
export ES_HOST="<HOST>:<PORT>"
export ES_USER="<USER>"
export ES_PASS="<PASSWORD>"
export ES_CA="<PATH>"
export TRACK_PATH="<PATH>"

esrally race \
  --track-path="$TRACK_PATH" \
  --pipeline=benchmark-only \
  --target-hosts="$ES_HOST" \
  --client-options="use_ssl:true,verify_certs:true,ca_certs:'${ES_CA}',basic_auth_user:'${ES_USER}',basic_auth_password:'${ES_PASS}'" \
  --user-tags="candidate:baseline"

# 完成且仅完成待验证变更,并从同一数据状态重新开始后执行 contender。
esrally race \
  --track-path="$TRACK_PATH" \
  --pipeline=benchmark-only \
  --target-hosts="$ES_HOST" \
  --client-options="use_ssl:true,verify_certs:true,ca_certs:'${ES_CA}',basic_auth_user:'${ES_USER}',basic_auth_password:'${ES_PASS}'" \
  --user-tags="candidate:contender"
预期输出
[INFO] Racing on track [<VALUE>] ...
...
[INFO] SUCCESS
...
[INFO] Racing on track [<VALUE>] ...
...
[INFO] SUCCESS
实际报告会同时列出各任务的吞吐与可用延迟百分位;具体数值、耗时和 Race ID 每次都不同。若请求错误率非零、Rally 无法达到设定吞吐,或测试期间出现节点故障,这次 Race 不应直接拿来证明优化有效。
比较结果并设置门槛
先用 esrally list races 找到带有 baseline 与 contender 标签的 Race ID,再比较两次结果。下面使用 <ID> 占位,实际 ID 会不同。
BASELINE_RACE_ID="<ID>"
CONTENDER_RACE_ID="<ID>"

esrally compare \
  --baseline="$BASELINE_RACE_ID" \
  --contender="$CONTENDER_RACE_ID"
预期输出
Comparing baseline
  Race ID: <ID>
with contender
  Race ID: <ID>
...
Metric                                  Baseline   Contender   Diff
<Query latency percentile metric>       <VALUE>    <VALUE>     <VALUE>
<Query throughput metric>               <VALUE>    <VALUE>     <VALUE>
compare 负责给出差异,不会替你决定“能不能发布”。门槛应同时包含相对变化与业务绝对上限,例如:核心查询 P99 不得回退超过 8%,同时必须低于既定 SLO;固定负载下的实际吞吐不得低于目标;错误率必须保持在允许范围。只设“相对 baseline 不变慢”会放过本来就很慢的结果,只设绝对上限又可能掩盖明显回退。
为了降低偶然噪声,同一候选至少重复多次,并用相同规则处理异常 Race。只有当同一查询组合、同一环境和同一数据状态下的重复结果稳定越过门槛,才把变化视为真实回归或真实收益。