
NoSQL 与搜索 / 系统课时
用 Hot Threads 定位 CPU 热点
用 Hot Threads 定位 CPU 热点
节点 CPU 飙高时,Hot Threads 能把“哪个节点很忙”进一步缩小到“哪些 Java 线程正在消耗 CPU,以及它们反复停留在哪段调用栈”。本课用多次采样把热点关联到搜索、脚本、Lucene 合并或集群管理任务,并给出下一步证据链。
学习目标
- 从集群中选出真正需要采样的高 CPU 节点
- 正确读取 Hot Threads 的线程占比、采样次数与重复栈
- 将持续热点归因到搜索、脚本、合并或集群管理工作
从高 CPU 节点开始采样
不要一上来对所有节点盲目抓 Hot Threads。先用 CAT Nodes 按 CPU 排序,再只采样热点节点。下面示例需要集群监控权限;full_id=true 让 CAT Nodes 返回完整节点 ID,便于直接作为 Hot Threads 的节点选择器。
ES_URL="https://localhost:9200"
ES_CA="<PATH>"
ELASTIC_API_KEY="<API_KEY>"

curl --cacert "$ES_CA" -sS   -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ES_URL/_cat/nodes?v=true&full_id=true&h=id,name,cpu,load_1m,heap.percent,node.role&s=cpu:desc"

NODE_ID="<NODE_ID>"
curl --cacert "$ES_CA" -sS   -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ES_URL/_nodes/$NODE_ID/hot_threads?threads=3&type=cpu&interval=500ms&snapshots=10&ignore_idle_threads=true"
预期输出
id        name    cpu    load_1m    heap.percent    node.role
<ID>      es01    <CPU>  <LOAD>     <HEAP_PERCENT>  <ROLE>

::: {es01}{<ID>}{<ID>}{es01}{<IP>}{<IP>:<PORT>}...
   Hot threads at <TIME>, interval=500ms, busiestThreads=3, ignoreIdleThreads=true:
   <PERCENT>% [cpu=<PERCENT>%, other=<PERCENT>%] ... cpu usage by thread '<THREAD_NAME>'
     <COUNT>/10 snapshots sharing following <COUNT> elements
       <STACK_FRAME>
       <STACK_FRAME>
实际线程名、百分比和栈帧会随负载变化。Hot Threads 是短时间采样,不是长期 profiler;单次结果只能提供线索,不能独立证明根因。
用重复采样筛掉偶然热点
判断时同时看三个信号:线程 CPU 占比是否高、10 次快照中是否大量共享同一段栈、以及相隔数秒重新采样后是否仍出现同类栈。只有三个信号持续一致,才值得把它当作主热点。
如果第一次看到某个搜索线程占满 CPU,第二次已经消失,它可能只是刚好撞上采样窗口。反之,同一个查询执行栈或脚本栈在多次采样里反复出现,才说明它持续占用计算时间。
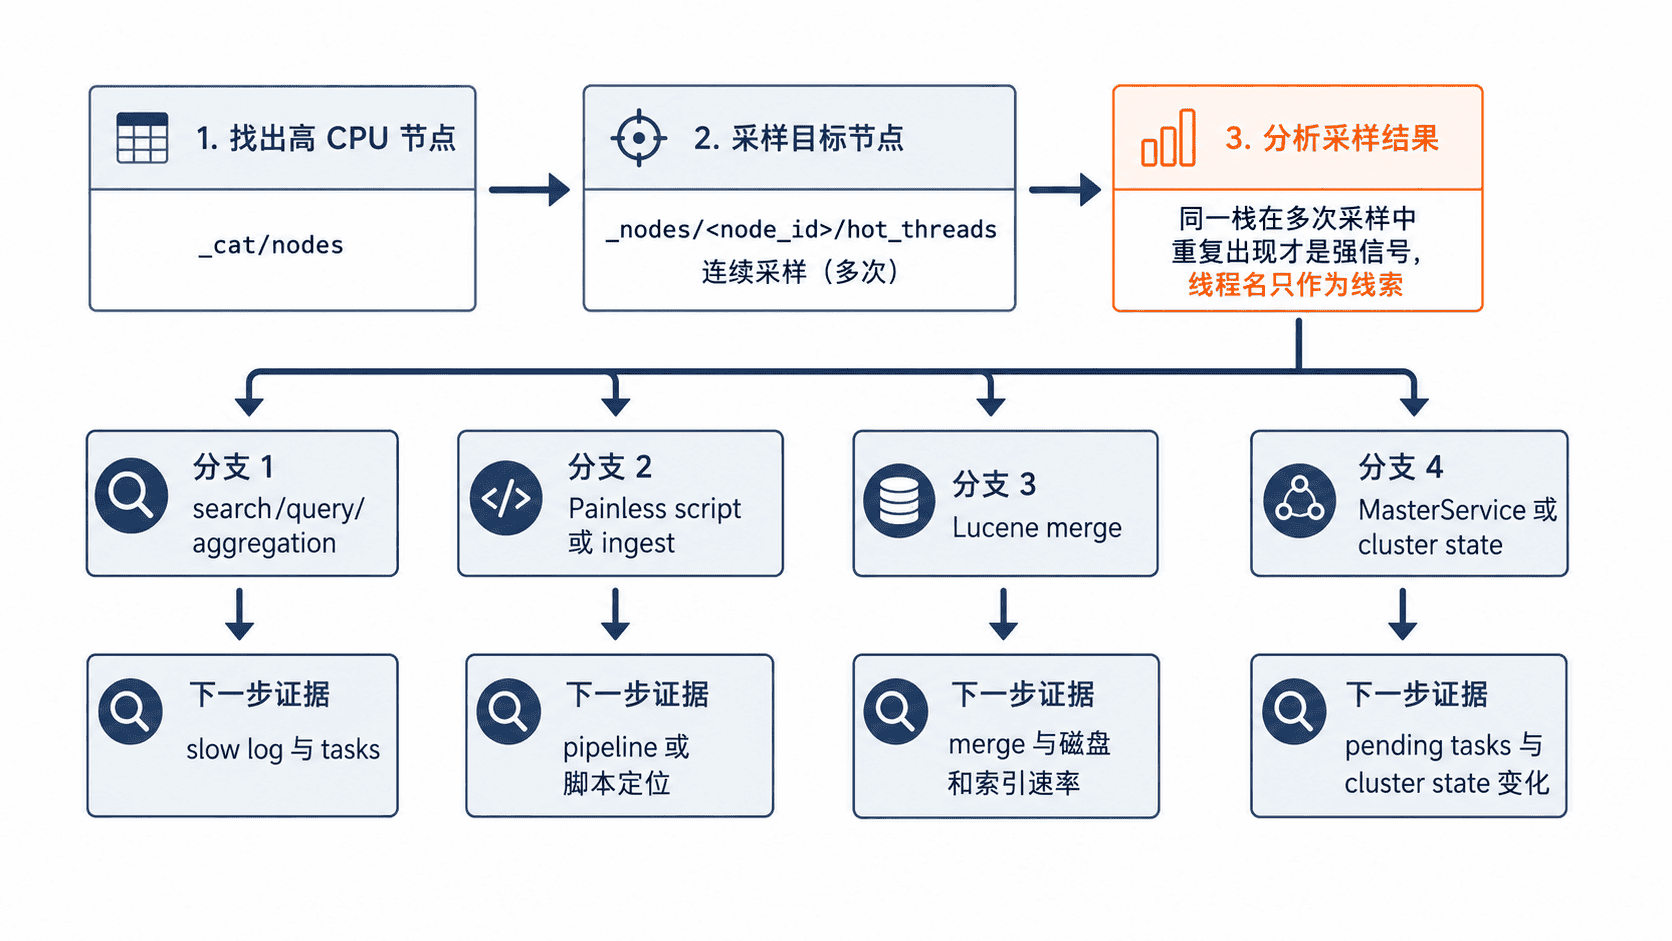
把调用栈归到四类工作
| 热点线索 | 常见含义 | 下一步核对 |
|---|---|---|
search 线程及查询、聚合执行栈反复出现 |
慢查询、高成本聚合或大量搜索计算 | 搜索慢日志、Tasks API、查询 Profile |
| Painless、script 或 ingest processor 栈反复出现 | 脚本字段、script score、runtime field 或 ingest 脚本计算重 | 定位具体脚本、pipeline 与请求来源 |
Lucene merge、ConcurrentMergeScheduler 一类栈持续出现 |
索引写入触发段合并,CPU 可能同时受磁盘吞吐影响 | merges stats、索引速率、segment 数和磁盘延迟 |
| MasterService、cluster state 更新或发布相关栈持续出现 | 集群状态变更过密、映射或分片管理任务偏重 | pending tasks、mapping 变更、分片数量与集群状态规模 |
线程名只能帮助缩小范围,真正有辨识度的是重复出现的栈帧。例如线程名是 write,但栈里持续落在 Painless processor,就应先追脚本处理;不能因为看到 write 就直接归因于普通索引吞吐。
让 Hot Threads 与其他证据闭环
搜索热点要与慢日志或正在运行的 search task 对上,才能确定具体请求;脚本热点要落到具体 script、runtime field 或 ingest processor;merge 热点要同时观察索引速率、merge 时间与磁盘压力;集群管理热点则应检查 pending cluster tasks、频繁 mapping 更新和分片变化。
完成诊断的标准不是看到一段漂亮的栈,而是能形成闭环:高 CPU 节点 → 稳定重复的热点栈 → 对应任务或工作负载 → 调整后 CPU 与业务延迟共同回落。