
NoSQL 与搜索 / 系统课时
使用 SLM 自动执行快照
使用 SLM 自动执行快照
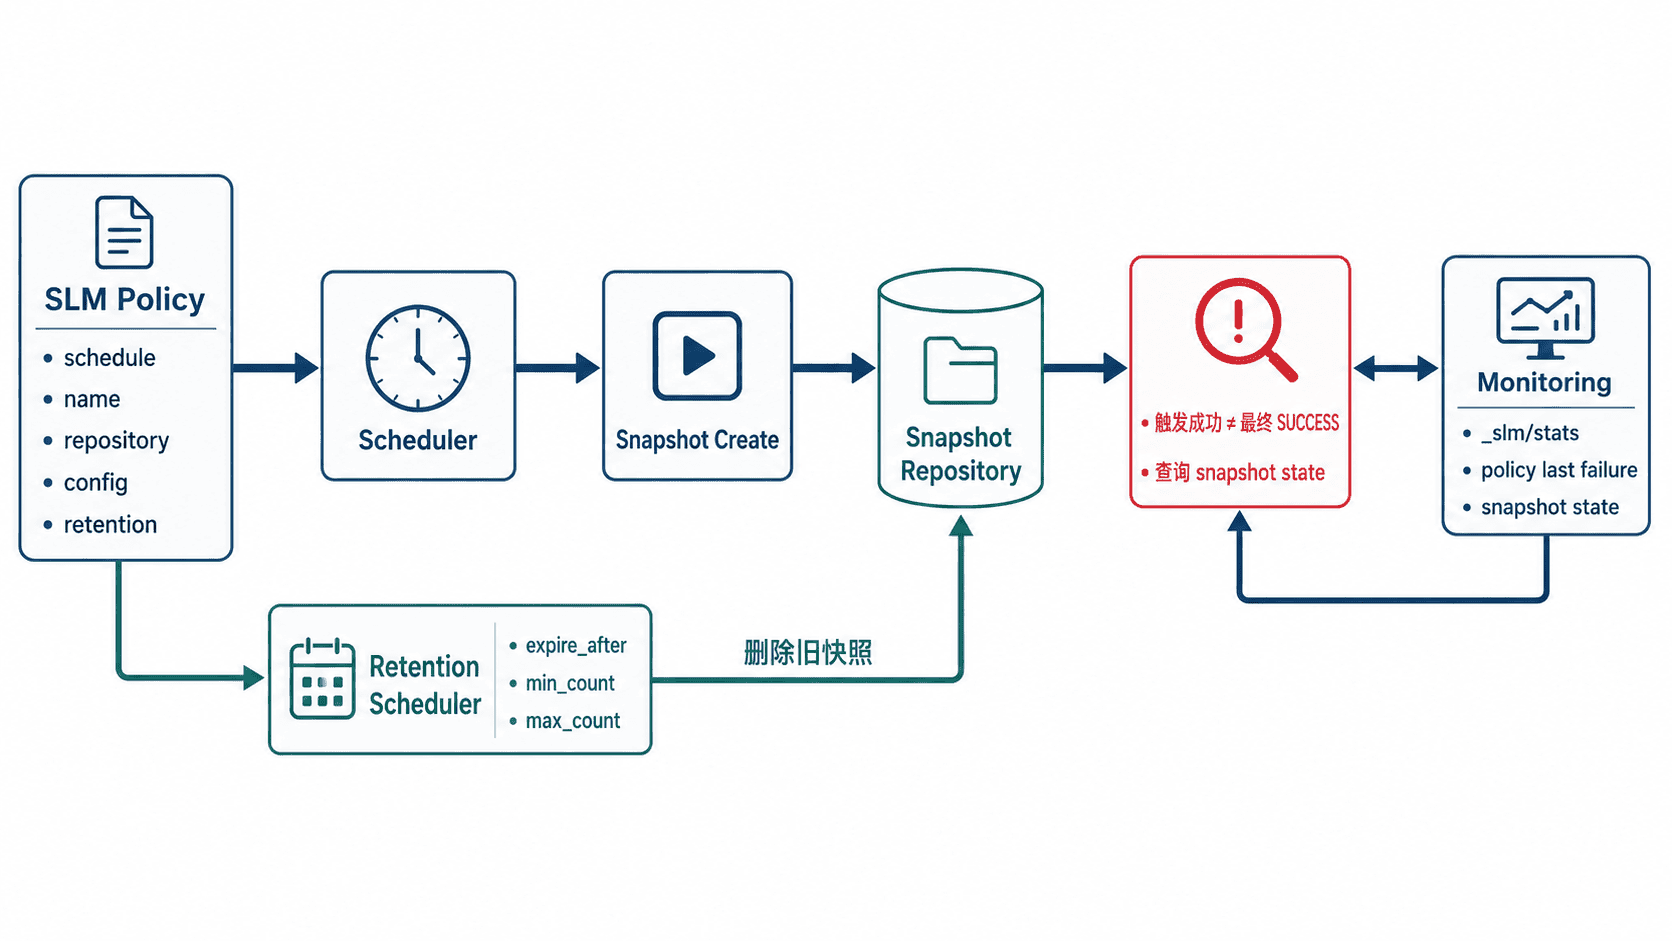
SLM(Snapshot Lifecycle Management)把“定时创建快照、按规则清理旧快照、持续暴露执行状态”收敛成一份策略。本课完成一条可验证的每日备份链路,并把“请求已触发”和“快照真正成功”区分开。
学习目标
- 配置 SLM 的执行计划、快照范围和保留规则
- 手动执行策略并确认快照最终进入
SUCCESS - 用 SLM 统计与历史结果建立失败监控
先确认仓库和 SLM 可用
以下示例以已注册的 prod-backups 快照仓库为前提,可在 Kibana Dev Tools 中执行。先验证仓库可被集群节点访问,再确认 SLM 没有被停止;仓库验证失败时,不要继续创建“看起来正确”的策略。
POST _snapshot/prod-backups/_verify

GET _slm/status
预期结果
_snapshot/prod-backups/_verify 返回 HTTP 200,并在 nodes 中列出可访问仓库的节点。
_slm/status 返回 operation_mode = RUNNING。
如果仓库验证失败,优先检查仓库注册参数、对象存储或共享文件系统权限、节点网络连通性以及对应仓库插件或凭据。SLM 默认会随集群启动;只有此前被显式停止时才需要重新启动。
定义每日快照和保留规则
下面的策略每天 02:30 执行,备份 orders-* 与 logs-*,保留 30 天,同时至少保留 7 个、最多保留 50 个由该策略成功创建的快照。示例刻意不包含全局集群状态,避免把“业务数据备份”和“集群配置灾备”混在一起。
PUT _slm/policy/prod-daily
{
  "schedule": "0 30 2 * * ?",
  "name": "<prod-{now/d}>",
  "repository": "prod-backups",
  "config": {
    "indices": [
      "orders-*",
      "logs-*"
    ],
    "ignore_unavailable": false,
    "include_global_state": false
  },
  "retention": {
    "expire_after": "30d",
    "min_count": 7,
    "max_count": 50
  }
}
预期结果
{
  "acknowledged": true
}
expire_after 决定快照何时具备过期资格,min_count 防止可用快照数量降得过低,max_count 则限制成功快照的数量上界。保留任务独立于创建计划运行,所以“快照已过期”并不等于它会在同一秒被删除。
如果灾备范围还包括模板、持久化集群设置、ILM 策略或安全等 feature state,应单独定义恢复范围并演练,不要仅因为“想备份更多”就无条件打开 include_global_state。
立即执行并确认真正成功
新策略不要等到第二天才发现错误。先手动执行一次;该 API 返回 snapshot_name 只表示 SLM 已发起本次快照,随后仍要查询该快照的最终状态。
PUT _slm/policy/prod-daily/_execute预期结果
snapshot_name = prod-<TIME>-<ID>将实际返回的名称替换下面的 <SNAPSHOT>。快照完成后,状态应为 SUCCESS,并且失败分片数为 0;实际完成时间和分片数量会随数据量变化。
GET _snapshot/prod-backups/<SNAPSHOT>?filter_path=snapshots.snapshot,snapshots.state,snapshots.shards预期结果
snapshots[0].state = SUCCESS
snapshots[0].shards.failed = 0把失败变成可告警信号
持续备份不能只看“今天有没有文件”。应周期性采集 SLM 统计,至少关注快照失败、删除失败和保留任务失败是否产生新增。
GET _slm/stats预期结果
HTTP 200
返回 total_snapshots_taken、total_snapshots_failed、total_snapshot_deletion_failures、retention_failed 和 policy_stats。
监控系统应对失败计数的增量告警,而不是把历史累计值非零直接当成当前故障;同时保留策略级失败记录,便于定位是仓库不可达、权限不足、索引状态异常还是保留清理失败。真正闭环的 SLM 不是“策略存在”,而是按计划产生可恢复的成功快照,并且失败会被及时发现。