
NoSQL 与搜索 / 系统课时
执行滚动版本升级
执行滚动版本升级
滚动升级的难点不是把新包装上去,而是让不同版本节点只在受支持的短窗口内共存,并保证每次只损失一个节点的容量。本课以自管 Elasticsearch 为例,完成升级前检查、按角色滚动、节点恢复与最终版本验收。
学习目标
- 判断目标版本是否位于受支持的升级路径,并准备可恢复的回退方案。
- 按数据层、普通功能节点、master-eligible 节点的顺序滚动升级。
- 对每个节点执行“限制分配、停机升级、重新加入、恢复副本、验收”闭环。
先确认升级路径和回退能力
正式变更前先检查 breaking changes、弃用项、插件兼容性和目标版本支持路径。跨 8.x 到 9.x 的升级应先到最新 8.19.x,并在该版本运行 Upgrade Assistant 处理阻断项;同一主版本内也不能只凭版本号判断,仍要核对目标版本的发布与兼容说明。
Elasticsearch 不支持把已经升级的节点原地降回旧版本。混合版本集群只允许存在于滚动升级期间;一旦首个节点进入目标版本,就应有能力把整批节点升级完。真正的回退方案是升级前得到可用快照,并在必要时用旧版本重建空集群再恢复,而不是把已升级节点直接降级。
先记录健康状态和每个节点的角色、master 标记、版本。下面示例只读取集群,不修改状态。
export ES_URL='https://<HOST>:<PORT>'
export ES_API_KEY='<API_KEY>'

curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cluster/health?filter_path=status,number_of_nodes,active_primary_shards,unassigned_shards"   -w '\nHTTP_STATUS=%{http_code}\n'

curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cat/nodes?format=json&h=name,ip,node.role,master,version&s=name"   -w '\nHTTP_STATUS=%{http_code}\n'
预期输出(节点名、IP、角色与版本以实际集群为准):
{"status":"green","number_of_nodes":<VALUE>,"active_primary_shards":<VALUE>,"unassigned_shards":0}
HTTP_STATUS=200
[{"name":"<NODE_NAME>","ip":"<IP>","node.role":"<ROLE>","master":"<VALUE>","version":"<VERSION>"}]
HTTP_STATUS=200按角色顺序滚动
数据节点要先升级,并按数据层从 data_frozen、data_cold、data_warm、data_hot 到其他 data 节点推进。之后升级既非 data 又非 master-eligible 的节点,例如 ingest、ML、transform、remote-cluster-client 与专用 coordinating 节点;master 和 voting_only master-eligible 节点最后升级。多角色节点归入这套顺序中最先命中的角色组。
这个顺序的关键是 master 兼容边界:新版本节点可以在旧版本 master 管理下逐步加入,但旧版本节点未必能加入已经由新版本 master 管理的集群。因此不要为了“先升级最重要节点”而把 master 提前。
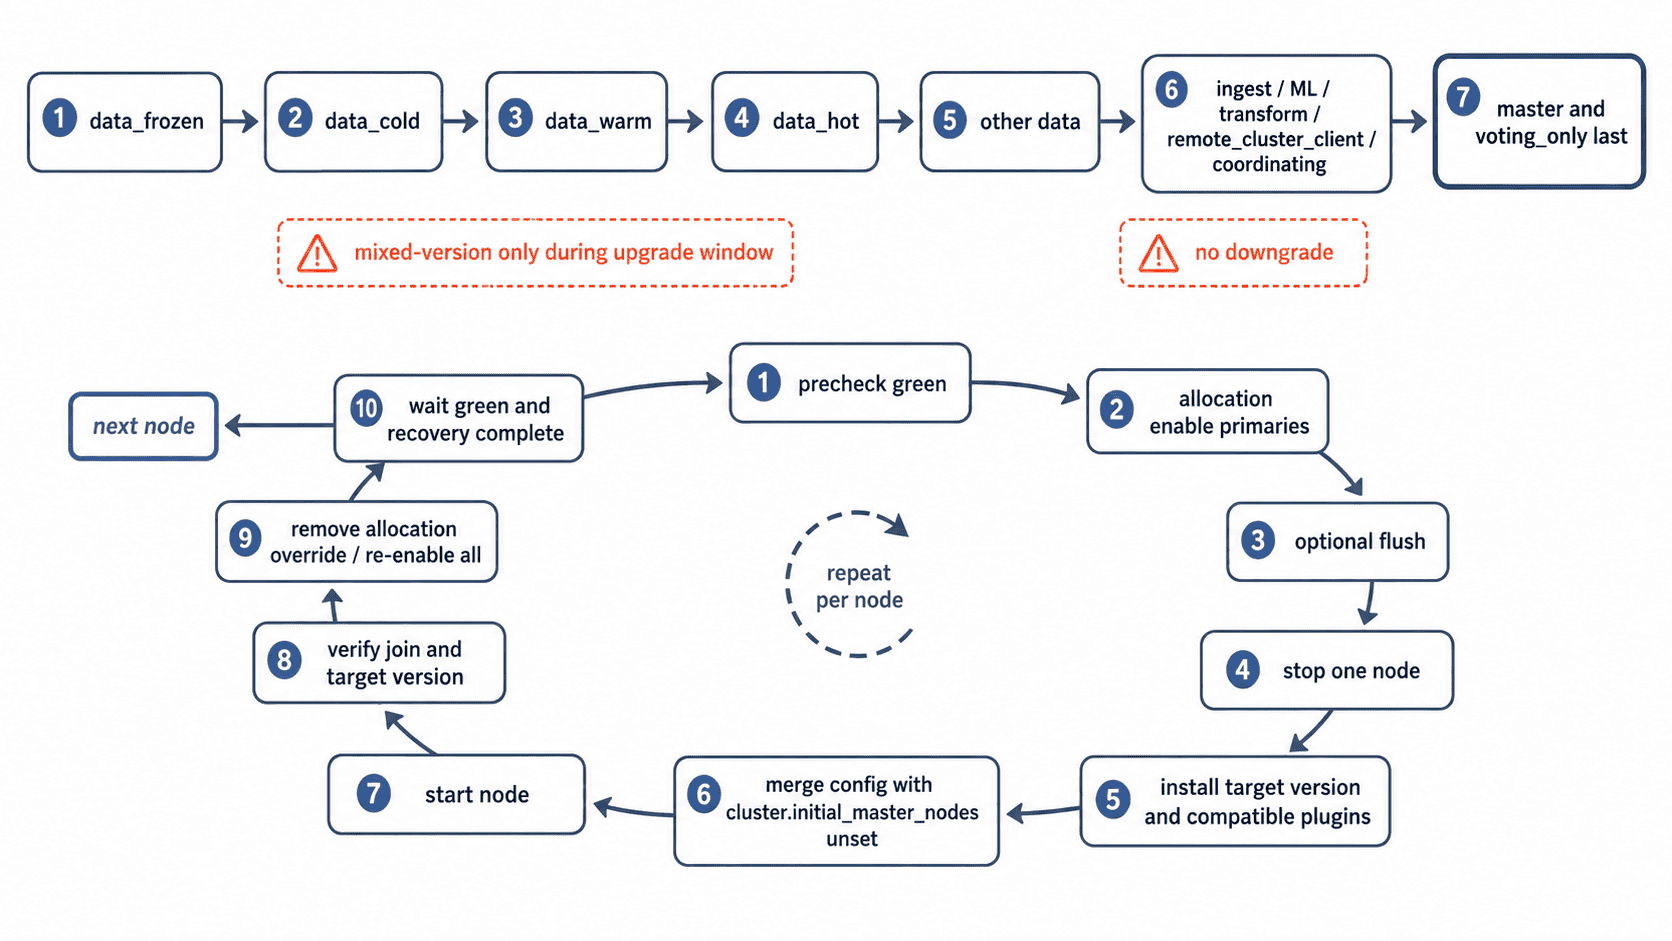
每个数据节点执行同一个闭环
准备停一个数据节点前,可以临时只允许 primary 分配,并在业务允许时停止非必要写入后 flush。这样可避免节点短暂离线时立即复制它的副本。设置完成后只停止一个节点,替换该节点的 Elasticsearch 版本与所有插件,再启动并确认它重新加入原集群。
curl -sS -X PUT   -H "Authorization: ApiKey ${ES_API_KEY}"   -H 'Content-Type: application/json'   "${ES_URL}/_cluster/settings?flat_settings=true"   -d '{"persistent":{"cluster.routing.allocation.enable":"primaries"}}'   -w '\nHTTP_STATUS=%{http_code}\n'

curl -sS -X POST   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_flush"   -w '\nHTTP_STATUS=%{http_code}\n'
预期输出:
{"acknowledged":true,"persistent":{"cluster.routing.allocation.enable":"primaries"},"transient":{}}
HTTP_STATUS=200
{"_shards":{"total":<VALUE>,"successful":<VALUE>,"failed":0}}
HTTP_STATUS=200
节点包或镜像的替换方式取决于现有安装介质。下面是 Debian/Ubuntu 且已配置目标主版本 APT 仓库 的完整示例;执行前把 <TARGET_VERSION> 替换为已通过兼容性检查的具体版本。升级时保留原数据目录,并检查新版本配置差异;滚动升级节点的 elasticsearch.yml 中不要设置 cluster.initial_master_nodes。
export TARGET_VERSION='<TARGET_VERSION>'

sudo systemctl stop elasticsearch.service
sudo apt-get update
sudo apt-get install "elasticsearch=${TARGET_VERSION}"
sudo systemctl start elasticsearch.service
sudo systemctl is-active elasticsearch.service
预期输出的 APT 细节会随系统变化,最终服务状态应为:
active如果安装了插件,必须在该节点启动前确认插件版本与目标 Elasticsearch 版本兼容并完成对应升级。不要把旧安装目录中的整份 jvm.options 或 log4j2.properties 机械覆盖到新版本,应该保留新版本默认配置,只迁移明确需要的 overrides。
节点回来后先恢复冗余再继续
升级节点重新加入后,立即移除之前的 allocation 限制,让副本开始恢复。等集群重新达到预期健康状态,再升级下一个节点;不要连续停两个节点来“提高速度”,否则会把滚动升级变成容量和副本同时下降的批量重启。
curl -sS -X PUT   -H "Authorization: ApiKey ${ES_API_KEY}"   -H 'Content-Type: application/json'   "${ES_URL}/_cluster/settings?flat_settings=true"   -d '{"persistent":{"cluster.routing.allocation.enable":null}}'   -w '\nHTTP_STATUS=%{http_code}\n'

curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cluster/health?wait_for_status=green&wait_for_no_relocating_shards=true&timeout=10m&filter_path=status,relocating_shards,initializing_shards,unassigned_shards"   -w '\nHTTP_STATUS=%{http_code}\n'

curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cat/nodes?format=json&h=name,version,master,node.role&s=name"   -w '\nHTTP_STATUS=%{http_code}\n'
预期输出(中间阶段允许新旧版本并存,但已升级节点应显示目标版本):
{"acknowledged":true,"persistent":{},"transient":{}}
HTTP_STATUS=200
{"status":"green","relocating_shards":0,"initializing_shards":0,"unassigned_shards":0}
HTTP_STATUS=200
[{"name":"<NODE_NAME>","version":"<VERSION>","master":"<VALUE>","node.role":"<ROLE>"}]
HTTP_STATUS=200
如果出现“新版本 primary 不能把 replica 分配到更旧节点”之类的分配错误,先检查是否打乱了数据层升级顺序或是否仍有旧版本节点承担该副本。不要尝试把新节点降级;修复顺序或配置后继续完成目标版本升级。
全集群升级后再做最终验收
最后一个 master-eligible 节点升级完成后,确认所有 Elasticsearch 节点版本一致、集群为 green、无活动恢复或异常 unassigned shard,并执行一轮真实搜索与写入冒烟测试。若升级期间暂停了 ML upgrade mode、非必要 indexing 或其他作业,此时再逐项恢复。
curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cat/nodes?format=json&h=name,version&s=version,name"   -w '\nHTTP_STATUS=%{http_code}\n'

curl -sS   -H "Authorization: ApiKey ${ES_API_KEY}"   "${ES_URL}/_cat/recovery?active_only=true&format=json"   -w '\nHTTP_STATUS=%{http_code}\n'
预期输出(所有节点都应为同一个 <TARGET_VERSION>;没有活动恢复时第二个响应为空数组):
[{"name":"<NODE_NAME>","version":"<TARGET_VERSION>"}]
HTTP_STATUS=200
[]
HTTP_STATUS=200
升级完成后再继续升级 Kibana,并按兼容计划处理 Fleet Server、APM、Beats、Elastic Agent、Logstash 与客户端库。真正的完成条件不是“所有进程都启动”,而是版本一致、分片完整、核心读写通过、监控与告警恢复正常。