
NoSQL 与搜索 / 系统课时
验证 Snapshot 可恢复性
验证 Snapshot 可恢复性
快照显示 SUCCESS 只证明写入流程完成,并不能替代恢复演练。本课把一个成功快照恢复成隔离名称,检查分片、文档和业务读路径,再记录恢复耗时,确保备份在真正需要时可用。
学习目标
- 选择可用于演练的成功快照并确认其完整性状态
- 使用重命名恢复避免覆盖现有生产索引
- 用健康、数据与业务校验结果形成可审计的恢复证据
先定义恢复演练的验收口径
恢复验证最好在独立测试集群进行,因为这样还能验证仓库访问、节点容量、版本兼容和环境依赖。资源受限时,也可以在原集群把不可变索引重命名恢复,但这种方式只能证明数据级恢复路径,不等价于完整灾备演练。
本例选择快照中的不可变索引 orders-2026.08.26。执行恢复前,先确认目标快照最终为 SUCCESS 且没有失败分片。
GET _snapshot/prod-backups/<SNAPSHOT>?filter_path=snapshots.snapshot,snapshots.state,snapshots.indices,snapshots.shards预期结果
snapshots[0].state = SUCCESS
snapshots[0].shards.failed = 0
snapshots[0].indices 包含 orders-2026.08.26
恢复验收至少要提前保存一份基线,例如该不可变索引在快照时刻的文档数、关键业务查询结果或若干已知文档 ID。否则即使索引能打开,也无法判断内容是否符合预期。
用重命名恢复隔离生产数据
恢复到同一集群时,不要直接覆盖正在使用的索引。下面把命中的索引改名为 restore-test-*,关闭别名恢复,并明确排除全局状态和 feature state;同时把副本数临时设为 0,便于单节点测试环境完成分片分配。
POST _snapshot/prod-backups/<SNAPSHOT>/_restore?wait_for_completion=true
{
  "indices": "orders-2026.08.26",
  "include_global_state": false,
  "feature_states": [
    "none"
  ],
  "include_aliases": false,
  "rename_pattern": "(.+)",
  "rename_replacement": "restore-test-$1",
  "index_settings": {
    "index.number_of_replicas": 0
  }
}
预期结果
HTTP 200
snapshot.shards.failed = 0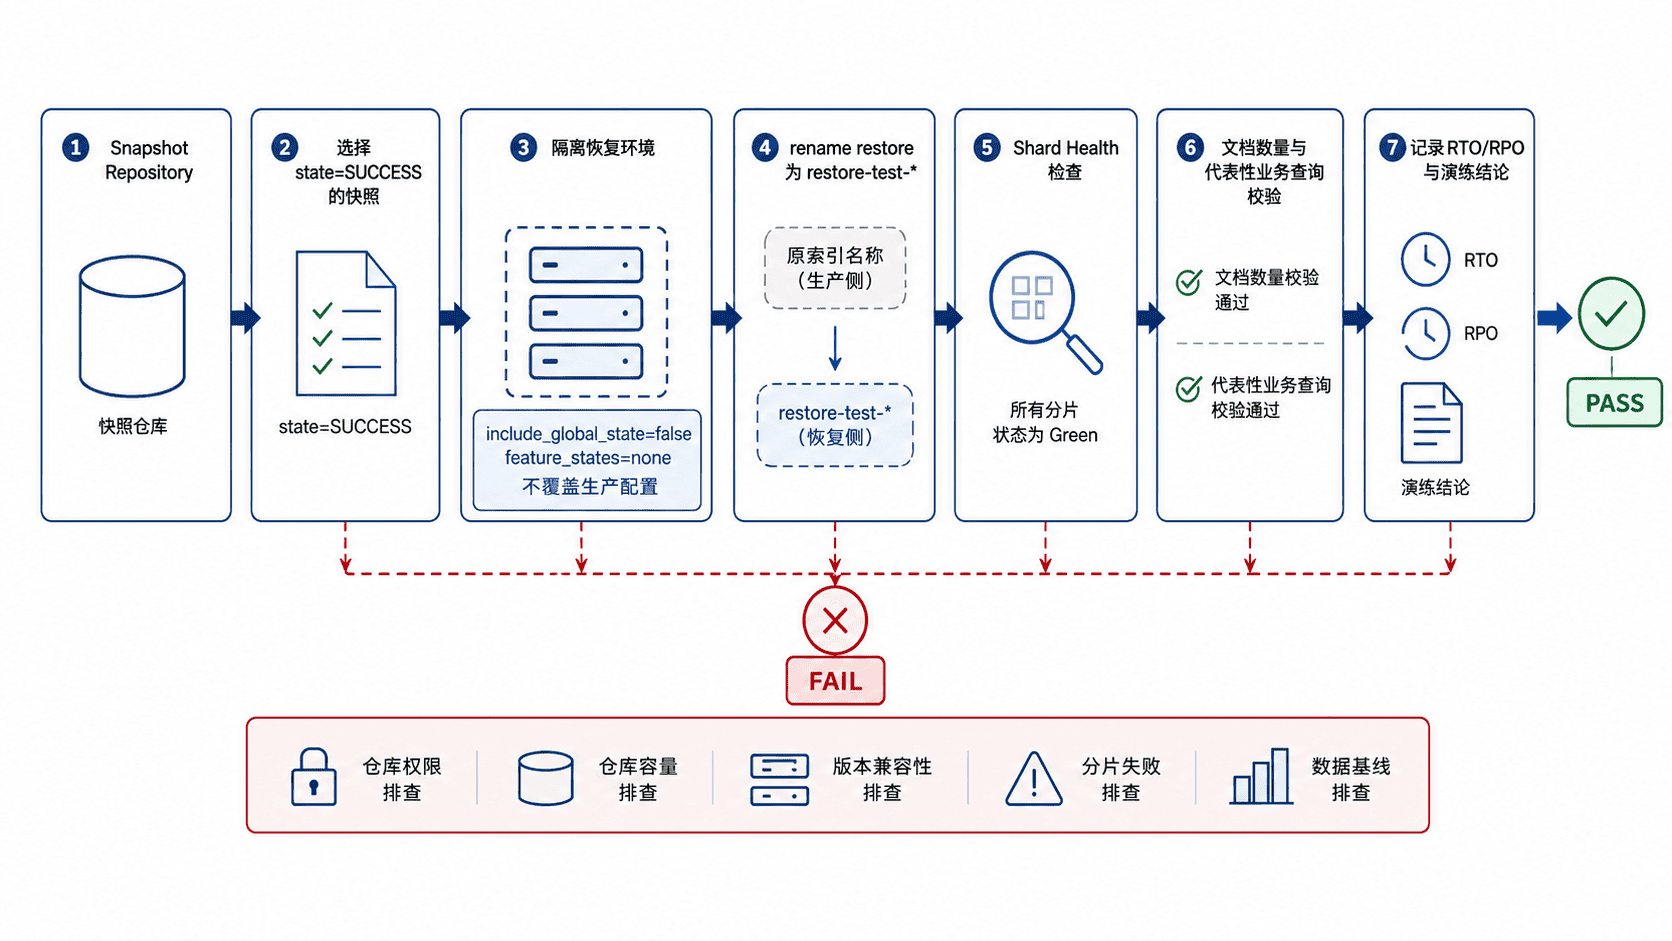
检查分片和数据内容
先等待恢复后的索引达到预期健康状态。因为示例把副本数设为 0,单节点测试环境也可以达到 green。
GET _cluster/health/restore-test-orders-2026.08.26?wait_for_status=green&timeout=60s预期结果
status = green
timed_out = false
接着检查文档数。这里的 <VALUE> 必须与快照时刻保存的基线一致,而不是与仍在持续写入的生产索引当前值比较。
GET restore-test-orders-2026.08.26/_count预期结果
count = <VALUE>文档数相同仍不足以覆盖所有故障模式。生产演练还应执行一组稳定的代表性读取:查询已知文档、验证关键字段、执行核心聚合,并让应用或自动化测试真实访问恢复后的索引。任何一项不一致,都应把本次演练判定为失败而不是“基本可用”。
记录 RTO、RPO 并清理演练数据
把恢复开始时间、首次达到可查询状态的时间、全部业务校验通过时间记录下来,得到本次实际恢复耗时;再记录被恢复快照的完成时间与目标故障时点之间的间隔,用于判断 RPO 是否满足要求。只有可重复测量,灾备目标才不是纸面数字。
同集群重命名演练结束后删除测试索引,避免它继续占用磁盘和分片配额。
DELETE restore-test-orders-2026.08.26预期结果
{
  "acknowledged": true
}
建议把恢复验证做成固定周期任务,并轮换抽取不同日期、不同索引和不同快照。日常的重命名恢复可以验证数据可读性;更低频但完整的灾备演练则应在新集群中同时验证仓库凭据、容量、版本兼容、模板与必要 feature state。只有两类验证都持续通过,才能把“有快照”升级为“有恢复能力”。