
NoSQL 与搜索 / 系统课时
估算 CPU、I/O 与网络余量
估算 CPU、I/O 与网络余量
节点容量不是“CPU 未到 100% 就还有空间”。搜索扇出、写入复制、Lucene merge 与 shard recovery 会在不同时间争抢 CPU、磁盘和网络。本课把峰值业务与后台任务转换为三个资源预算,并用 N-1 故障场景验证是否真正留有余量。
学习目标
- 把搜索、写入、merge 与 recovery 映射到 CPU、磁盘和网络消耗
- 根据峰值负载与故障模型计算节点应保留的资源余量
- 用 Elasticsearch 节点统计识别最先到达瓶颈的资源
先把负载拆成资源向量
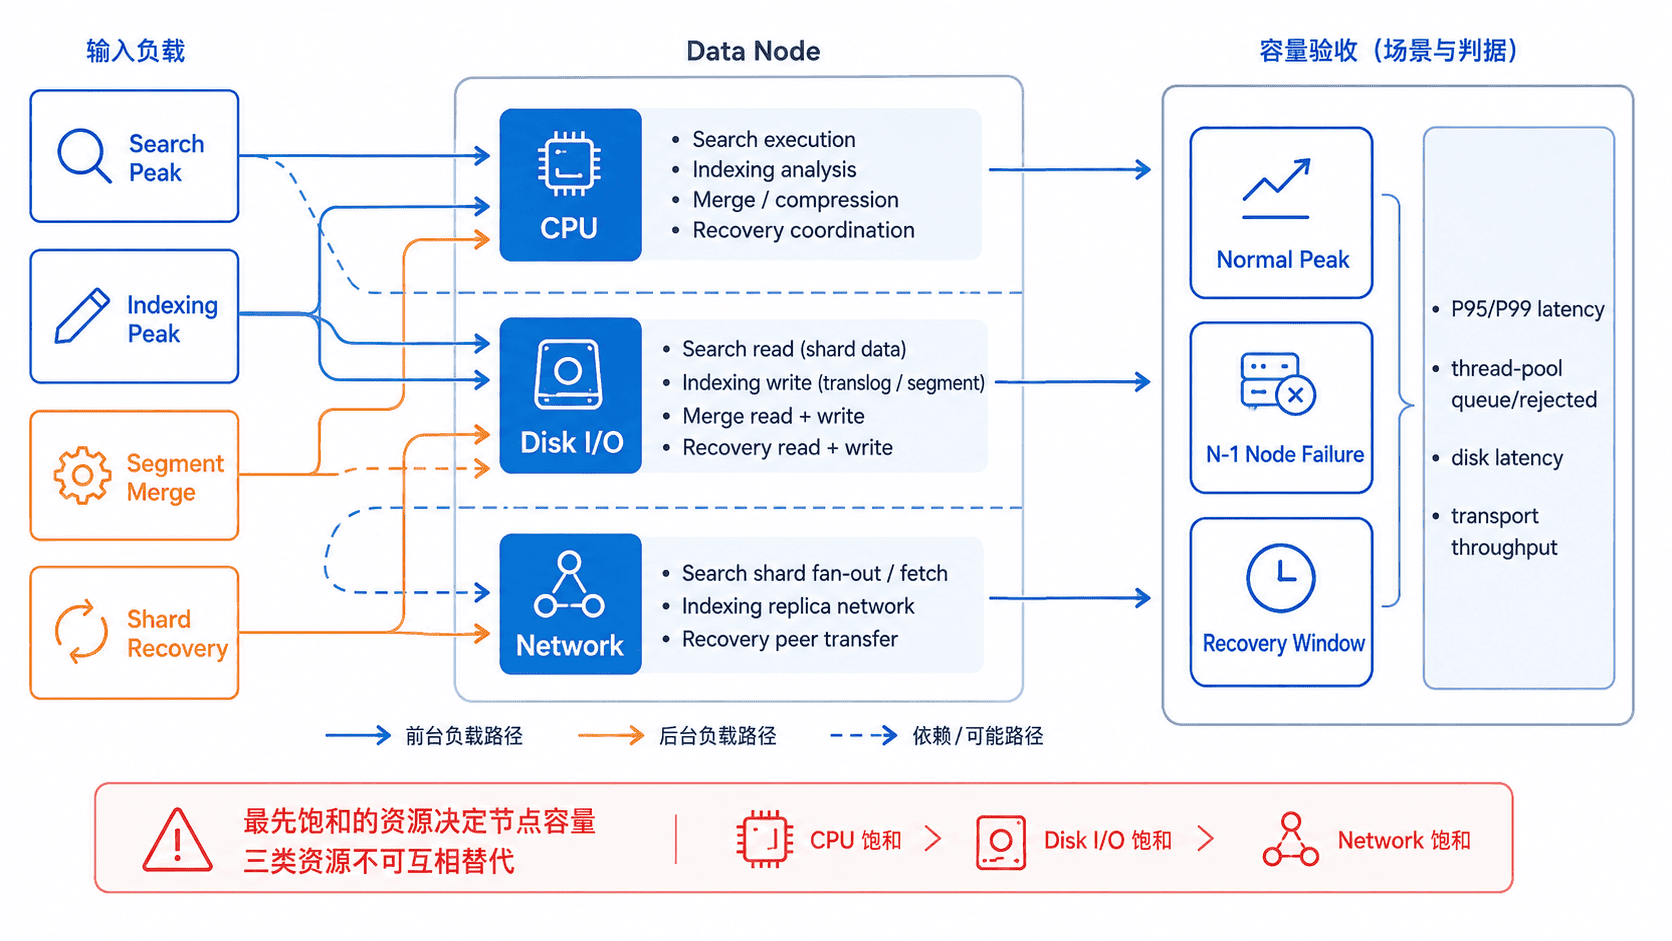
搜索不是一次请求只消耗一次 CPU。协调节点会把请求分发到目标 shard copy,各分片执行查询与聚合后再归并结果;分片越多、查询越复杂,CPU 与跨节点网络扇出通常越明显。写入则同时消耗分析与索引 CPU、段文件与 translog I/O,并把操作复制到副本。
后台 merge 会持续读取旧 segment、写出新 segment;shard relocation 或 recovery 还会复制大量数据并占用源节点与目标节点的磁盘和网络。因此容量模型至少要同时保留三类余量,而不能只盯平均 CPU:
- CPU:查询执行、聚合、脚本、ingest pipeline、索引与 merge
- I/O:Page Cache 未命中的读取、segment 写入与 merge、flush、恢复数据读写
- 网络:协调节点 scatter/gather、主副本复制、节点间 recovery 与客户端响应
用故障模型定义余量而不是拍百分比
余量应来自你要承受的故障,而不是统一套一个“保留 20%”。如果有 4 台同规格数据节点且负载均匀,正常时每台承担约四分之一工作量;失去 1 台后,剩余 3 台在理想均衡下平均工作量会变成原来的 ,也就是约增加 33%,而此时恢复和重分配还会额外消耗 I/O 与网络。
因此可以先定义每种资源允许的峰值上限,再反推正常状态目标。例如要求 N-1 后 CPU 仍不超过 80%,忽略其他额外开销时,正常峰值 CPU 就不能长期高于约 60%。真正生产预算还要继续给 merge、recovery、负载不均和突发查询留空间。
I/O 与网络更不能只按“带宽百分比”判断。随机读延迟、设备队列和 fsync 延迟可能在吞吐尚未打满前就恶化;网络同样要同时关注吞吐、包处理和节点间流量。最先破坏延迟 SLO 或产生排队的资源,就是当前节点的容量上限。
采集一次资源快照
Node Stats 可以把 Elasticsearch 进程看到的 CPU、文件系统 I/O、传输流量、merge 与线程池状态放到同一份快照中。下面的请求只读,不修改集群。
export ES_URL="https://<HOST>:<PORT>"
export ELASTIC_API_KEY="<API_KEY>"

curl -sS \
  -H "Authorization: ApiKey ${ELASTIC_API_KEY}" \
  "${ES_URL}/_nodes/stats/os,process,fs,transport,indices,thread_pool?human=true&filter_path=nodes.*.name,nodes.*.os.cpu,nodes.*.process.cpu,nodes.*.fs.io_stats,nodes.*.transport,nodes.*.indices.merges,nodes.*.thread_pool.search,nodes.*.thread_pool.write"
预期输出会按节点返回这些资源块;部分文件系统 I/O 统计依赖运行平台,具体计数与速率需结合两次采样的时间差计算:
{
  "nodes": {
    "<ID>": {
      "name": "<NODE>",
      "os": {"cpu": {...}},
      "process": {"cpu": {...}},
      "fs": {"io_stats": {...}},
      "transport": {...},
      "indices": {"merges": {...}},
      "thread_pool": {
        "search": {...},
        "write": {...}
      }
    }
  }
}
重点看趋势而不是单点:CPU 持续高位同时 search 或 write 队列增长,说明计算资源接近饱和;merge 活跃时磁盘延迟同步上升,说明后台合并正在争抢 I/O;transport 收发字节在恢复窗口陡增,则需要确认节点间网络是否挤压正常搜索与复制。
把 recovery 当成正式容量场景
indices.recovery.max_bytes_per_sec 可以限制每个节点用于恢复的数据传输速率,但把限制调高并不会凭空增加恢复能力:恢复同时消耗源端读、目标端写和节点间网络。如果业务峰值期间把恢复流量推到链路或磁盘上限,恢复可能更快,线上查询却会先超时。
容量测试应至少覆盖正常峰值、单节点失效后的业务峰值,以及恢复并发发生的窗口。对每个场景记录 P95/P99 延迟、HTTP 429、线程池排队、CPU、磁盘延迟和 transport 吞吐;若只有降低恢复速度才能守住业务 SLO,就把这个恢复速率写入运行基线,而不是临时凭经验调整。
用最窄资源决定扩容方向
CPU 先饱和时,优先减少高成本查询与分片扇出,检查 ingest/脚本开销,并通过更多节点分摊计算;I/O 先恶化时,优先验证 Page Cache 命中、merge 压力、存储延迟与热数据密度;网络先成为瓶颈时,则检查跨节点查询、主副本复制和 recovery 是否叠加。
最终容量值应来自代表性压测与故障演练:在业务峰值下仍留出足够空间,让一个节点离线后,剩余节点既能服务流量,也能完成必要的 shard recovery。这样的余量才是可运维的容量,而不是仪表盘上看起来“还没满”的百分比。