
NoSQL 与搜索 / 系统课时
执行滚动重启
执行滚动重启
滚动重启的目标不是“把节点依次重启”这么简单,而是让每次只损失一个节点的容量,并在下一台维护前恢复到可接受的健康状态。本课给出一套适用于自管 Elasticsearch 集群的维护门槛、操作顺序和验收方法。
学习目标
- 能在停节点前判断集群是否具备滚动重启条件
- 能限制无意义的副本重分配,并逐台完成停止、启动与回归
- 能用集群健康、节点列表和恢复状态决定是否进入下一台
先建立单节点下线门槛
开始前先确认集群没有 red、没有正在扩大的未分配主分片,并且剩余节点有足够磁盘、CPU 与副本承载能力。对于 dedicated master-eligible 节点,任何时刻都必须保留可形成多数派的节点,不能同时维护多台。
在运维机上查询健康状态和节点角色。以下示例假设已经配置集群地址与 API Key:
export ELASTICSEARCH_URL="https://es.example.com:9200"
export ELASTIC_API_KEY="<API_KEY>"

curl -sS -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ELASTICSEARCH_URL/_cluster/health?filter_path=status,number_of_nodes,active_primary_shards,unassigned_shards,relocating_shards,initializing_shards"

curl -sS -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ELASTICSEARCH_URL/_cat/nodes?full_id=true&h=id,name,roles,master,version"
预期输出
{"status":"green","number_of_nodes":<VALUE>,"active_primary_shards":<VALUE>,"relocating_shards":0,"initializing_shards":0,"unassigned_shards":0}
<ID> node-a dim - <VERSION>
<ID> node-b dim * <VERSION>
<ID> node-c dim - <VERSION>
实际节点 ID、角色缩写、主节点标记和版本会随集群不同而变化。若集群已经 red、磁盘逼近水位线,或还有大量 relocation/recovery,先处理这些问题,不要把滚动重启叠加到正在发生的故障上。
控制短暂离线引发的重分配
数据节点短时间离线时,如果立即把其副本复制到其他节点,会制造不必要的磁盘与网络 I/O。维护数据节点前可以临时把集群级分配限制为仅允许 primary,并在写入压力允许时执行一次 flush。
curl -sS -X PUT   -H "Authorization: ApiKey $ELASTIC_API_KEY"   -H "Content-Type: application/json"   "$ELASTICSEARCH_URL/_cluster/settings"   -d '{"persistent":{"cluster.routing.allocation.enable":"primaries"}}'

curl -sS -X POST   -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ELASTICSEARCH_URL/_flush?filter_path=_shards.failed"
预期输出
{"persistent":{"cluster":{"routing":{"allocation":{"enable":"primaries"}}}},"transient":{}}
{"_shards":{"failed":0}}
primaries 只限制后续分配,不会把已经分配的 shard 主动移走;节点重新加入后,本地已有的有效 shard copy 仍可参与恢复。协调节点或纯 ingest 节点不持有数据时,不必为了它们修改 shard allocation。
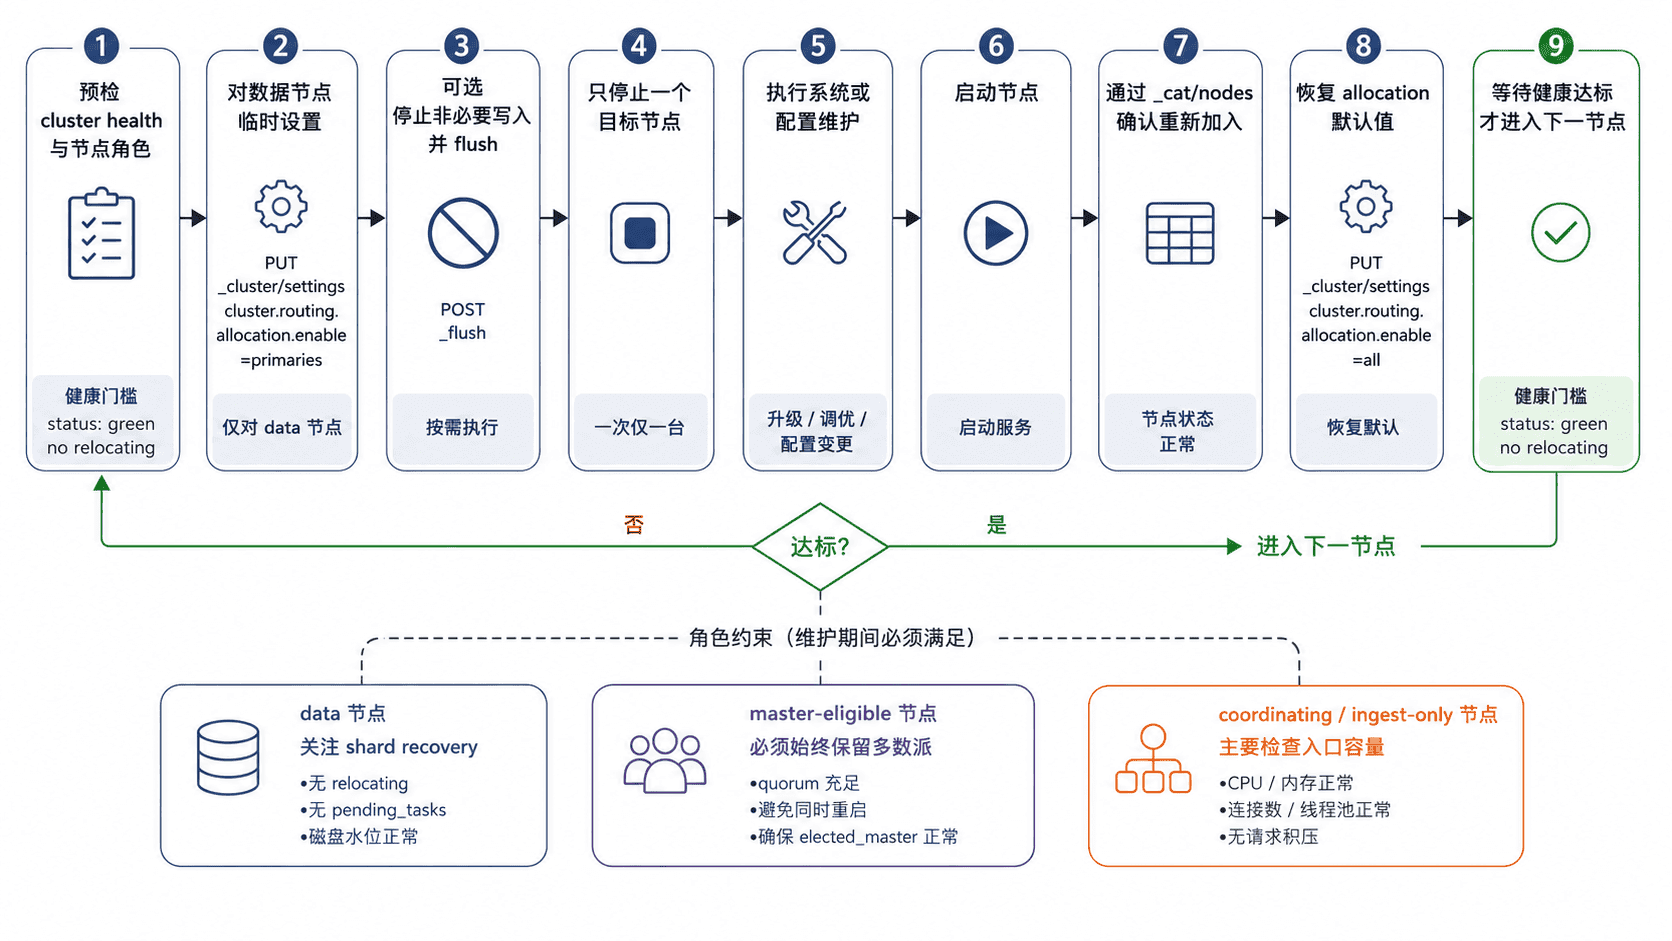
一次只维护一个节点
在目标主机停止 Elasticsearch,完成操作系统补丁、JVM 参数或静态配置修改后再启动。下面以 systemd 部署为例;<NODE_HOST> 替换为目标主机,SSH 用户需要具备对应的服务管理权限。
ssh <USER>@<NODE_HOST> 'sudo systemctl stop elasticsearch.service'
# 在这里完成本次计划维护
ssh <USER>@<NODE_HOST> 'sudo systemctl start elasticsearch.service'

curl -sS -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ELASTICSEARCH_URL/_cat/nodes?h=name,roles,master,version"
预期输出
node-a dim - <VERSION>
node-b dim * <VERSION>
node-c dim - <VERSION>
关键不是看到进程变成 active,而是目标节点重新出现在集群成员列表中。维护 master-eligible 节点时,只逐台处理;如果当前 elected master 被重启,先等待新 master 选举和 cluster state 稳定,再继续任何下一步。
恢复分配并等待稳定
目标数据节点重新加入后,立即把临时分配限制清除,让设置回到默认值,然后以健康状态作为下一台节点的闸门。
curl -sS -X PUT   -H "Authorization: ApiKey $ELASTIC_API_KEY"   -H "Content-Type: application/json"   "$ELASTICSEARCH_URL/_cluster/settings"   -d '{"persistent":{"cluster.routing.allocation.enable":null}}'

curl -sS -H "Authorization: ApiKey $ELASTIC_API_KEY"   "$ELASTICSEARCH_URL/_cluster/health?wait_for_status=green&wait_for_no_relocating_shards=true&timeout=5m&filter_path=status,timed_out,relocating_shards,unassigned_shards"
预期输出
{"persistent":{},"transient":{}}
{"status":"green","timed_out":false,"relocating_shards":0,"unassigned_shards":0}
大型集群可能超过示例中的 5 分钟,此时 timed_out:true 不是“重启失败”的同义词,应继续检查 _cat/recovery、未分配 shard 原因和节点资源。只有当前节点已回归、主副分片恢复到维护基线,并且业务错误率与延迟没有异常时,才进入下一台节点。
滚动重启真正的控制点是每台节点之间的健康闸门。不要把“逐台执行”写成无人值守的固定 sleep 脚本;应由集群状态决定流程是否继续。