
NoSQL 与搜索 / 系统课时
编写故障 Runbook 并开展演练
编写故障 Runbook 并开展演练
Runbook 的价值不是“把经验写下来”,而是让值班人员在压力下仍能按证据做出可重复、可回滚的动作。本课把检测、止损、恢复、验证和复盘组织成一条闭环,并用可执行采集脚本和演练验收标准把它变成真正能用的生产流程。
学习目标
- 把告警条件、证据采集、决策闸门、止损动作和回滚条件写进同一份 Runbook
- 用固定命令保存集群健康、节点资源、任务和热点线程证据,减少临场遗漏
- 设计安全演练并用发现时间、执行正确率和恢复验证结果评估 Runbook 是否可用
把 Runbook 写成执行合同
一份可执行 Runbook 至少要回答五件事:什么现象触发、谁负责决策、先采哪些证据、什么条件下允许止损、怎样确认恢复。每个高风险动作还要写清前置条件、停止条件和回滚路径,避免“看到红灯就重启节点”这类不可审计操作。
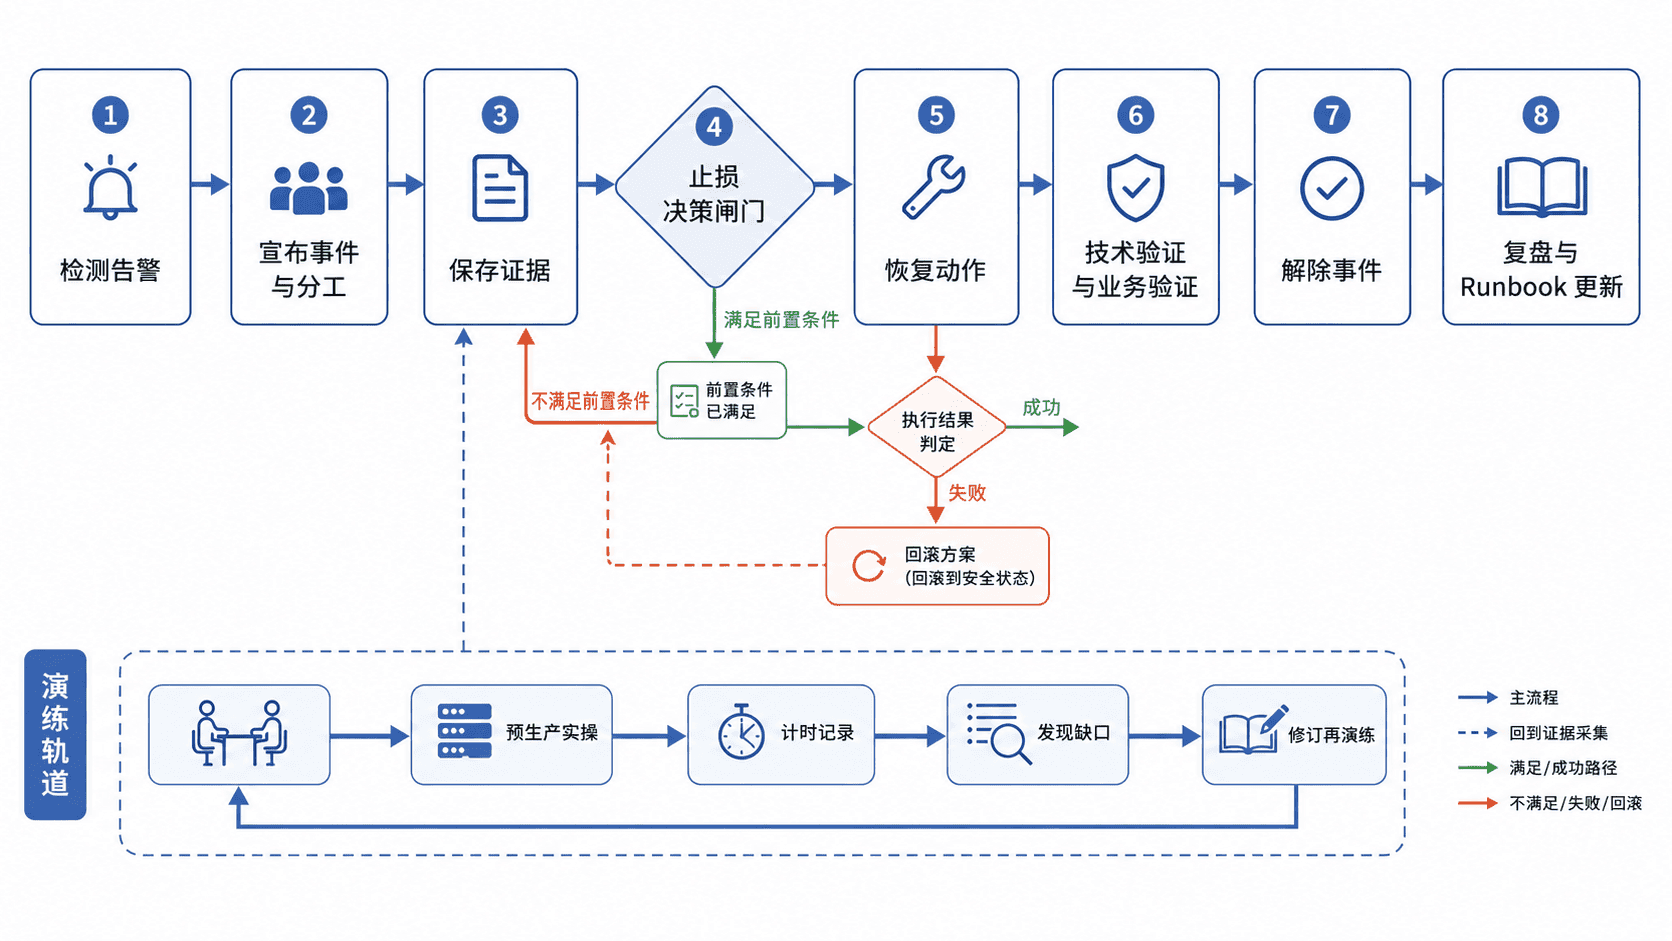
Runbook 不应把“重启、取消任务、调整副本”写成默认步骤,而应把它们放在有证据的决策点之后。推荐用类似下面的最小动作表约束现场执行。
| 动作 | 前置证据 | 停止或回滚条件 |
|---|---|---|
| 取消异常查询任务 | 已定位 task、调用方与影响范围,且任务可取消 | 取消后错误率上升或业务关键请求受影响 |
| 暂停批处理或重型定时任务 | 与故障窗口高度重合且资源争用明确 | 业务积压超过约定阈值 |
| 扩容或迁移负载 | 资源持续饱和且不是单条错误查询导致 | 分片恢复导致延迟进一步恶化 |
| 重启节点 | 已排除更低风险手段,并满足副本与变更条件 | 集群健康或分片可用性恶化 |
用固定采集脚本保存第一现场
现场最怕“先操作,后找证据”。下面脚本只读取状态,把关键响应写入独立目录;它不会修改集群。ES_URL 与 ES_API_KEY 从环境变量读取,避免把凭据写进 Runbook。
#!/usr/bin/env bash
set -euo pipefail

: "${ES_URL:?set ES_URL first}"
: "${ES_API_KEY:?set ES_API_KEY first}"

OUT="${1:-incident-$(date -u +%Y%m%dT%H%M%SZ)}"
mkdir -p "$OUT"
AUTH=(-H "Authorization: ApiKey $ES_API_KEY")

curl -fsS "${AUTH[@]}" "$ES_URL/_cluster/health" > "$OUT/cluster-health.json"
curl -fsS "${AUTH[@]}" "$ES_URL/_cluster/pending_tasks" > "$OUT/pending-tasks.json"
curl -fsS "${AUTH[@]}" "$ES_URL/_nodes/stats/jvm,os,fs,thread_pool,indices" > "$OUT/node-stats.json"
curl -fsS "${AUTH[@]}" "$ES_URL/_tasks?detailed=true&group_by=parents" > "$OUT/tasks.json"
curl -fsS "${AUTH[@]}" "$ES_URL/_nodes/hot_threads?ignore_idle_threads=true" > "$OUT/hot-threads.txt"

printf 'evidence_dir=%s\n' "$OUT"
预期输出
evidence_dir=incident-<TIME>目录中应出现 cluster-health.json、pending-tasks.json、node-stats.json、tasks.json 和 hot-threads.txt。Task API 与 Pending Cluster Tasks 观察的是不同层次:前者覆盖用户和系统运行任务,后者是尚未完成的集群状态更新;把两者同时保存能避免把搜索拥塞和 master 侧状态更新拥塞混为一谈。:contentReference[oaicite:4]{index=4}
把止损动作写成有闸门的命令
Runbook 中所有写操作都应明确“谁批准、作用对象是什么、执行前看哪项证据、执行后看哪项验证”。例如已经确认某个异常搜索任务持续消耗资源,且该任务标记为可取消时,才使用 Task Cancel API 请求取消指定 task;是否已经停止仍要通过后续查询确认。:contentReference[oaicite:5]{index=5}
export TASK_ID="<NODE_ID>:<TASK_ID>"

curl -sS -o /tmp/cancel-task.json -w 'HTTP %{http_code}\n' -X POST -H "Authorization: ApiKey $ES_API_KEY" "$ES_URL/_tasks/$TASK_ID/_cancel"

cat /tmp/cancel-task.json
预期输出
HTTP 200
随后返回取消请求的 JSON 响应;实际 task、node 与状态字段以现场响应为准。
执行后必须重新查询该 task、搜索延迟、错误率与线程池队列。若取消目标错误、业务错误率上升或资源没有回落,应立即停止继续扩大动作范围,回到证据采集和影响面判断,而不是连续取消更多任务。
用演练验证人在压力下能不能执行
演练至少分两级。桌面演练用历史或合成证据让值班人员口述判断,不触碰真实集群;实操演练放在预生产或经过审批的隔离环境,注入单一、可撤销的故障,例如异常长查询、批处理争用或单节点资源饱和,验证 Runbook 是否真的可执行。
演练记录不要只写“成功”。至少记录告警到确认故障的时间、确认负责人所需时间、第一份证据是否完整、是否出现越权或跳步操作、止损后关键 SLI 是否恢复,以及过程中哪些步骤需要临时问人。任何依赖“只有某个人知道”的步骤都说明 Runbook 还不合格。
演练结束后应把缺口变成具体修订:补命令、补权限说明、补回滚条件、删掉无效步骤,并在下一次演练中复测。真正成熟的 Runbook 不是越写越长,而是让同一类事故的判断路径更短、危险动作更少、恢复证据更明确。