
NoSQL 与搜索 / 系统课时
排查网络抖动与节点失联
排查网络抖动与节点失联
节点失联不一定是网卡坏了。短时丢包、连接被中间设备重置、JVM 长暂停、CPU 饱和或集群状态处理滞后,都可能让节点错过探测并被移出集群。本课用成员变化、传输统计和日志时间线定位“网络问题”究竟发生在哪一层。
学习目标
- 识别真实网络抖动、节点长暂停和集群协调异常的不同证据
- 用节点统计、集群成员和日志建立同一时间线
- 在不掩盖根因的前提下恢复节点稳定性
先确认节点是否真的离开了集群
应用侧出现连接超时,只能证明客户端到某个节点的请求失败,不能证明 Elasticsearch 节点已经从集群成员关系中消失。先看当前成员数、节点 uptime 和传输连接状态,再与故障时刻的日志对齐。
ES="https://es01:9200"
AUTH="elastic:<PASSWORD>"
CA="<PATH>/http_ca.crt"

curl -sS --cacert "$CA" -u "$AUTH" \
  "$ES/_cluster/health?filter_path=status,number_of_nodes,number_of_data_nodes,active_shards_percent_as_number"

curl -sS --cacert "$CA" -u "$AUTH" \
  "$ES/_cat/nodes?h=name,ip,node.role,master,uptime"

curl -sS --cacert "$CA" -u "$AUTH" \
  "$ES/_nodes/stats/transport,http,jvm,process?filter_path=nodes.*.name,nodes.*.transport.server_open,nodes.*.transport.rx_count,nodes.*.transport.tx_count,nodes.*.http.current_open,nodes.*.jvm.gc.collectors.*,nodes.*.process.cpu.percent"
预期输出
{
  "status": "<STATUS>",
  "number_of_nodes": <VALUE>,
  "number_of_data_nodes": <VALUE>,
  "active_shards_percent_as_number": <VALUE>
}
es01 <IP> <ROLES> * <UPTIME>
es02 <IP> <ROLES> - <UPTIME>
es03 <IP> <ROLES> - <UPTIME>
{
  "nodes": {
    "<ID>": {
      "name": "es01",
      "transport": {
        "server_open": <VALUE>,
        "rx_count": <VALUE>,
        "tx_count": <VALUE>
      },
      "http": {
        "current_open": <VALUE>
      },
      "jvm": {
        "gc": {
          "collectors": {
            "young": {
              "collection_count": <VALUE>,
              "collection_time_in_millis": <VALUE>
            },
            "old": {
              "collection_count": <VALUE>,
              "collection_time_in_millis": <VALUE>
            }
          }
        }
      },
      "process": {
        "cpu": {
          "percent": <VALUE>
        }
      }
    }
  }
}
节点数量、角色、uptime 和统计值都会变化。如果某节点重新加入后 uptime 很短,要继续确认它是进程重启,还是仅发生了传输连接断开后重新建连。
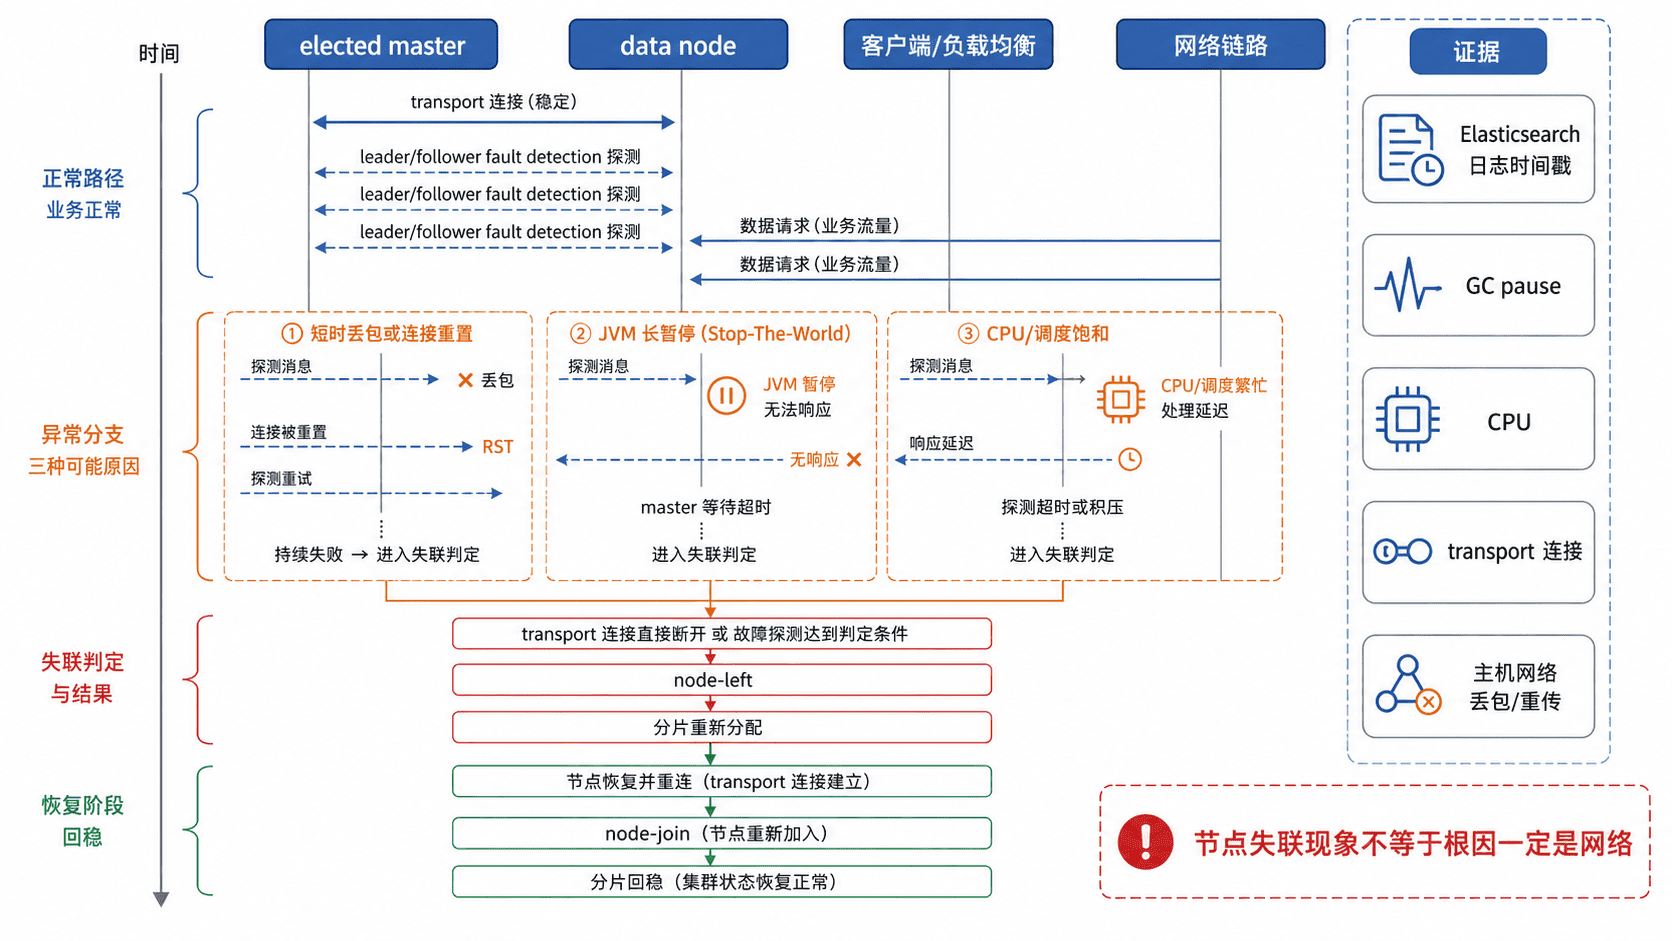
用日志时间线区分三类根因
最有价值的证据是同一秒附近的日志。节点被移除、重新加入、传输连接关闭、leader/follower 检查失败以及 JVM 长暂停如果出现在相近时间,就能判断故障是从网络、进程还是调度停顿开始。
假设 Elasticsearch 日志位于 <PATH>/elasticsearch.log,可以先筛出成员和连接相关事件;实际部署在 systemd、容器或云服务上时,应改用对应日志入口。
grep -E -i \
  'node-left|node-join|disconnected|connection.*closed|fault detection|leader check|follower check|lagging|gc.*overhead|JvmGcMonitorService' \
  <PATH>/elasticsearch.log
预期输出
<TIME> ... <matching membership, transport, fault-detection, or JVM-pause log line>如果没有匹配行,命令可能不输出任何内容;日志文案会随 Elasticsearch 版本和日志级别变化,所以不要把某个固定字符串当成唯一判据。
先看事件顺序。若主机网络监控先出现丢包、重传或链路 flap,随后 Elasticsearch 报连接关闭并发生 node-left,网络是强嫌疑;若节点在失联前出现长 GC、CPU 长时间打满或进程停顿,而其他节点网络正常,更像是节点“来不及回应”;若只有单个客户端到节点失败但节点间成员关系稳定,则应排查 HTTP 路径、负载均衡或客户端连接池,而不是集群内部 transport。
理解为什么长暂停会伪装成网络故障
集群协调依赖节点间 transport 通信与故障探测。发生长时间 Stop-The-World GC、宿主机调度停顿、严重 swap 或 CPU 饱和时,节点即使网线完全正常,也可能无法及时处理探测消息。对其他节点来说,它与“网络不可达”的外观非常相似。
因此诊断时必须把故障窗口内的 JVM GC 时间增量、进程 CPU、宿主机负载和网络丢包放到同一时间轴。节点长时间无法应用新的 cluster state 时,也可能因持续落后而被移出集群。只调整 fault detection 超时会延后部分故障判定,却可能把真正的长暂停隐藏得更久。
修复后验证成员关系是否稳定
真实网络问题应检查 MTU、丢包、重传、交换机或安全设备会话超时、跨可用区链路和主机网卡错误;节点暂停问题则处理 heap 压力、GC、CPU 争用、swap 和宿主机资源。若故障由中间负载均衡引起,要确认它只影响 HTTP 客户端路径,还是错误地介入了节点间 transport 通信。
修复后至少观察一个覆盖业务高峰的窗口:number_of_nodes 不再波动,节点 uptime 持续增长,没有重复的 node-left/node-join,同时 GC、CPU 和主机网络指标恢复到正常区间。只有成员关系和底层资源两侧都稳定,才能把“节点失联”判定为已解决。