
NoSQL 与搜索 / 系统课时
评估 Replica 对写入吞吐的影响
评估 Replica 对写入吞吐的影响
Replica 提高分片容错能力,也能分担读取,但每多一份副本,主分片就多一份复制、索引与持久化工作。本课用可重复的 Bulk 实验量化 0、1、2 个副本时的写入吞吐,并把测试结果转换成可用于生产容量规划的判断。
学习目标
- 解释副本如何造成写放大,以及为什么它会占用 CPU、磁盘与网络。
- 用相同主分片数和数据集对比不同
number_of_replicas的写入吞吐。 - 区分可暂时降低副本的批量装载场景与必须保留冗余的在线写入场景。
从写入路径看副本成本
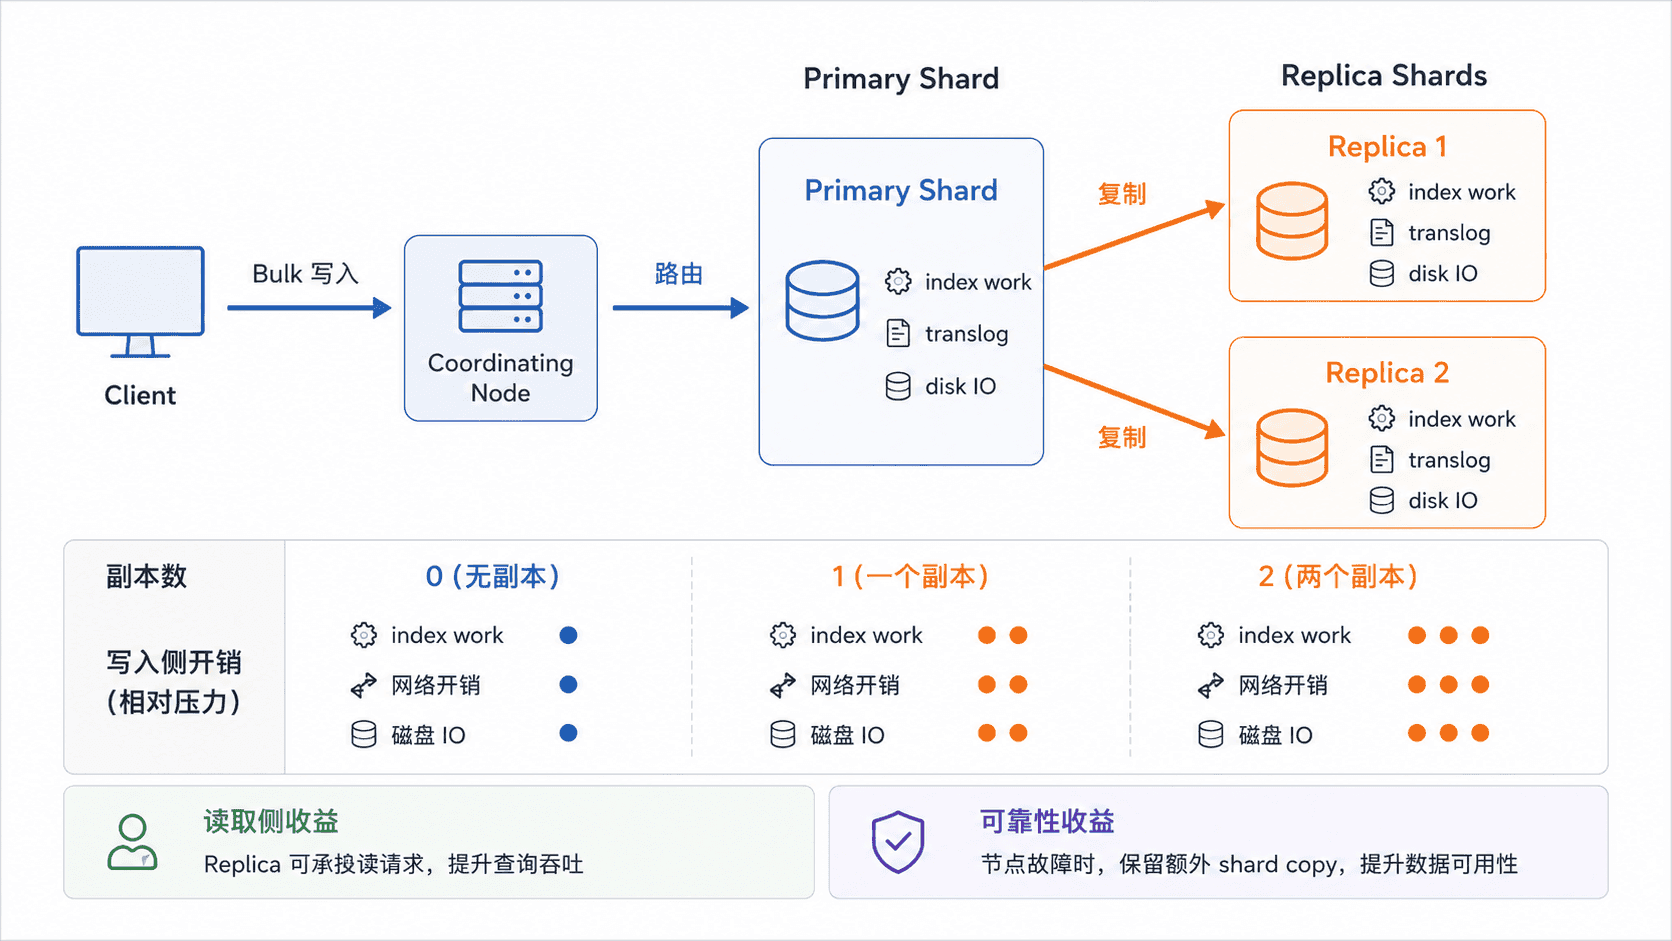
一个文档先路由到主分片,由主分片执行写入,再把操作复制到副本分片。若某个 replication group 配置了 个副本,一次逻辑写入至少对应 1 份主分片工作和 份副本工作;这不是精确的磁盘字节放大公式,却能直接解释资源成本为什么随副本数上升。
副本不是“只在主分片故障时才写”。正常情况下,已分配的副本也持续接收复制操作,因此会消耗网络带宽、索引 CPU、文件系统写入和 Translog 持久化能力。另一方面,副本可提供数据冗余并承担读请求,所以不能只按写入吞吐决定数量。index.number_of_replicas 可以动态调整。
用同一数据集做对照实验
下面的脚本要求至少 3 个可承载该索引的 data 节点,且测试集群没有其他明显负载。它创建 3 个单主分片索引,唯一变化是副本数,然后用同一份 20,000 文档 NDJSON 做一次 Bulk 写入。refresh_interval 设为 -1,避免刷新频率成为额外变量;wait_for_active_shards=all 用于避免副本仍在分配时就开始测试。
set -euo pipefail

: "${ES_URL:?set ES_URL, for example https://localhost:9200}"
: "${API_KEY:?set API_KEY}"
DOCS=20000
BULK_FILE=/tmp/es-replica-bench.ndjson

# 只生成一次数据集,保证各轮写入内容完全一致。
: > "$BULK_FILE"
for i in $(seq 1 "$DOCS"); do
  printf '{"index":{"_id":"%s"}}\n' "$i" >> "$BULK_FILE"
  printf '{"message":"event-%s","value":%s}\n' "$i" "$i" >> "$BULK_FILE"
done

# 每轮只改变副本数,其他索引参数保持一致。
for R in 0 1 2; do
  INDEX="replica-bench-r${R}"

  curl -fSs -X DELETE     -H "Authorization: ApiKey $API_KEY"     "$ES_URL/$INDEX" >/dev/null 2>&1 || true

  curl -fSs -X PUT     -H "Authorization: ApiKey $API_KEY"     -H 'Content-Type: application/json'     "$ES_URL/$INDEX"     -d "{\"settings\":{\"number_of_shards\":1,\"number_of_replicas\":$R,\"refresh_interval\":\"-1\"}}"     >/dev/null

  curl -fSs     -H "Authorization: ApiKey $API_KEY"     "$ES_URL/_cluster/health/$INDEX?wait_for_status=green&timeout=60s"     >/dev/null

  # 等待 green 后再计时,避免把副本初始化时间混入 Bulk 延迟。
  ELAPSED=$(curl -fSs -o /tmp/es-bulk-result.json -w '%{time_total}'     -X POST     -H "Authorization: ApiKey $API_KEY"     -H 'Content-Type: application/x-ndjson'     "$ES_URL/$INDEX/_bulk?wait_for_active_shards=all&filter_path=errors,took"     --data-binary "@$BULK_FILE")

  grep -q '"errors":false' /tmp/es-bulk-result.json
  RATE=$(awk -v n="$DOCS" -v s="$ELAPSED" 'BEGIN { printf "%.0f", n/s }')
  printf 'replicas=%s seconds=%s docs_per_sec=%s\n' "$R" "$ELAPSED" "$RATE"
done
预期输出
replicas=0 seconds=<TIME> docs_per_sec=<VALUE>
replicas=1 seconds=<TIME> docs_per_sec=<VALUE>
replicas=2 seconds=<TIME> docs_per_sec=<VALUE>
<TIME> 与 <VALUE> 会随硬件、数据节点布局、存储、JVM 状态和网络变化。不要预设三行一定按固定比例下降;真正要比较的是同一环境下多轮测试的中位数或分位数。如果 2 个副本无法分配,索引会保持 yellow,说明当前节点数或 allocation 规则不满足测试前提。
把吞吐差异拆成资源差异
只看 docs/s 容易得出错误结论。每轮实验还应同时观察 data 节点 CPU、磁盘写 IOPS/吞吐、网络发送量、merge 压力和写入延迟。如果副本增加后客户端吞吐下降,同时多个节点的磁盘或 CPU 接近上限,才能把瓶颈归因到复制带来的资源放大,而不是网络抖动或后台任务。
还要区分“总集群资源不变”和“副本带来更多节点并行度”。在资源固定时,副本通常增加每次写入要完成的工作;如果为了副本同步扩容了节点,瓶颈可能从磁盘转移到网络或主分片本身,因此生产结论必须来自接近真实拓扑的压测,而不是单机直觉。
什么时候可以降低副本
一次性回灌、可从上游完整重放的历史数据装载,可以在风险被明确接受时临时降低副本数,以减少复制成本;完成后应恢复目标副本数,并等待集群重新变为 green,再把这批数据视为具备预期冗余。降低副本会减少数据冗余,也可能降低搜索吞吐。
在线业务写入则应先从批量大小、并发度、refresh、分片布局和节点资源寻找瓶颈,不应把 number_of_replicas=0 当成常规性能参数。Replica 的正确评估方式不是“副本越少越快”,而是量化每增加一份可靠性和读取能力,需要付出多少可接受的写入资源成本。