
NoSQL 与搜索 / 系统课时
跨故障域部署 Master-eligible 节点
跨故障域部署 Master-eligible 节点
这篇解决生产集群最关键的协调可用性问题:怎样把 Master-eligible 节点分散到故障域,并用多数派规则判断某个机房或可用区失效后,集群还能不能选出 Master、提交新的 Cluster State。
学习目标
- 用 voting configuration 与多数派规则判断协调层容错能力
- 设计三故障域或“两主域 + 独立仲裁域”的 Master-eligible 拓扑
- 完成节点角色配置,并验证投票配置是否符合预期
多数派决定协调层是否可用
Elasticsearch 的选主和 Cluster State 提交都依赖当前 voting configuration。一次决策必须得到超过一半投票节点响应;因此三个投票节点需要两个投票,失去一个后仍能继续工作,而只有两个投票节点时,两者都必须在线。
高可用集群至少需要三个 Master-eligible 节点,并且至少两个不能是 voting-only。不要把“集群里有几个 Master-eligible 节点”机械等同于“当前有几票”:Elasticsearch 会自动维护 voting configuration,扩缩容后应先等它完成调整,再继续移除节点。
把投票节点分散到故障域
最直观的布局是三个独立故障域各放一个 Master-eligible 节点。任意一个故障域整体失效时,另外两个节点仍拥有 2/3 多数派。若只有两个主要故障域,则无法只靠这两个域做到“任意一域失效都继续选主”;可在独立第三故障域增加一个 voting-only Master-eligible 节点作为 tiebreaker。
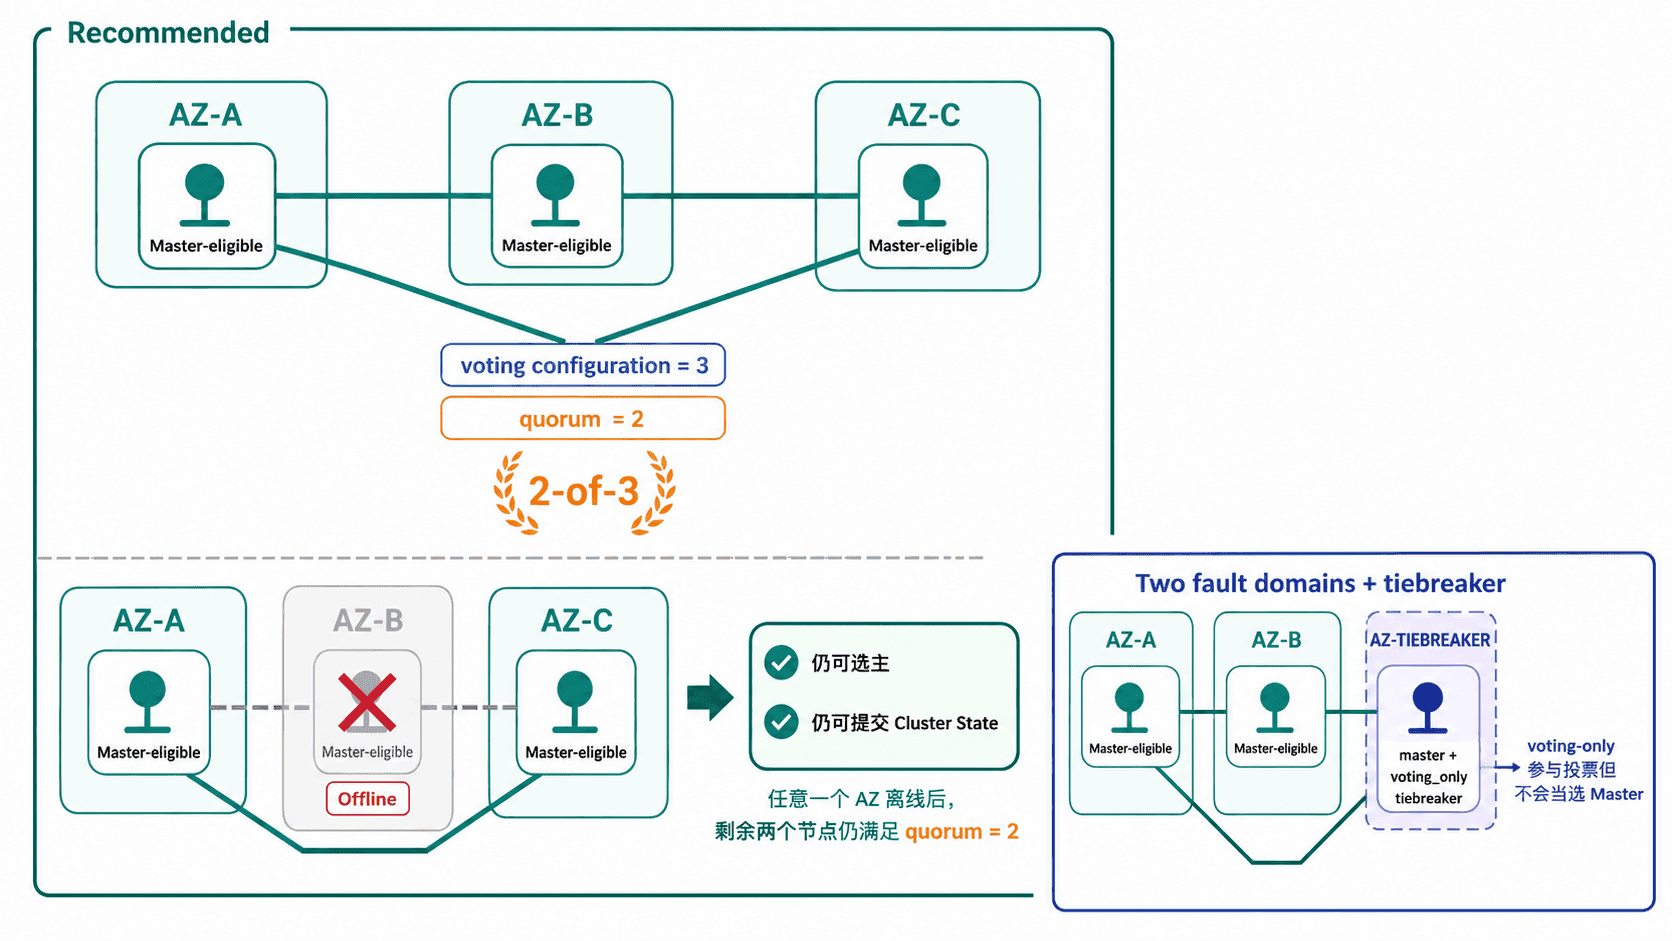
只有两个故障域时,把三个投票节点做成 2+1 分布只能形成非对称容错:丢失只有一个节点的域时还能留下两票;丢失包含两个节点的域时只剩一票。若业务要求任意一个主要故障域故障都不破坏协调能力,就必须引入独立的第三投票故障域。
voting-only 节点仍是 Master-eligible 节点,只是不会被选为 Master。它仍要持久化集群元数据并及时参与投票,因此不能把它放到不可靠磁盘、长时延网络或与某个主要域共享同一故障边界的位置。
配置专用 Master-eligible 节点
较大生产集群通常让 Master-eligible 节点只承担 master 角色,避免搜索、写入和聚合负载挤占协调资源。下面是 master-a 的片段示例;master-b、master-c 使用相同发现列表,但修改各自的 node.name 和地址。
cluster.name: prod-search
node.name: master-a
node.roles: [ master ]
network.host: <IP_A>
discovery.seed_hosts:
  - <IP_A>:9300
  - <IP_B>:9300
  - <IP_C>:9300
cluster.initial_master_nodes:
  - master-a
  - master-b
  - master-c
cluster.initial_master_nodes 只用于全新集群第一次引导。集群成功形成后应从配置中移除,之后节点重启、加入既有集群或整集群重启都不要再次设置它。
完成配置并启动三个节点后,可以一次检查节点角色和已提交的 voting configuration。以下命令假设已设置可访问 Elasticsearch 的账号,实际节点 ID、主机和端口会不同。
ES="https://<HOST>:<PORT>"
ES_USER="<USER>"
ES_PASS="<PASSWORD>"

echo "nodes:"
curl -sS -u "$ES_USER:$ES_PASS"   "$ES/_nodes/master-a,master-b,master-c?filter_path=nodes.*.name,nodes.*.roles"
echo
echo "voting:"
curl -sS -u "$ES_USER:$ES_PASS"   "$ES/_cluster/state?filter_path=metadata.cluster_coordination.last_committed_config"
预期输出
nodes:
{"nodes":{"<ID_A>":{"name":"master-a","roles":["master"]},"<ID_B>":{"name":"master-b","roles":["master"]},"<ID_C>":{"name":"master-c","roles":["master"]}}}
voting:
{"metadata":{"cluster_coordination":{"last_committed_config":["<ID_A>","<ID_B>","<ID_C>"]}}}
这里的 <ID_A>、<ID_B>、<ID_C> 是动态节点 ID;重点是三个节点角色正确,而且 voting configuration 中存在能够形成多数派的三张票。
用故障演练验证设计
拓扑图只能证明理论,生产验收还要逐个故障域演练。一次只隔离一个 Master-eligible 节点或一个故障域,确认剩余节点能重新选主、集群还能提交状态变更,并观察应用是否出现异常。节点恢复后,先确认它重新加入且 voting configuration 已稳定,再进行下一轮故障。
真正可靠的设计不是“节点数看起来够多”,而是把多数派、故障域独立性和实际失效演练同时对齐:三票跨三个独立域最容易验证;两个主要域则用独立第三域的 tiebreaker 补足对任一主要域故障的协调容错。