
高等数学 / 系统课时
高维积分难题
高维积分难题
本课解释积分维度升高后,为什么规则网格会迅速变得不可计算,以及随机采样如何绕开“每一维都要细分”的成本。完成后,你可以根据维度、精度和函数特征判断应使用网格积分还是采样估计。
学习目标
- 理解网格积分中的维数灾难
- 掌握蒙特卡洛积分的基本估计公式
- 能识别随机采样的优势、限制与适用场景
网格数量为何指数增长
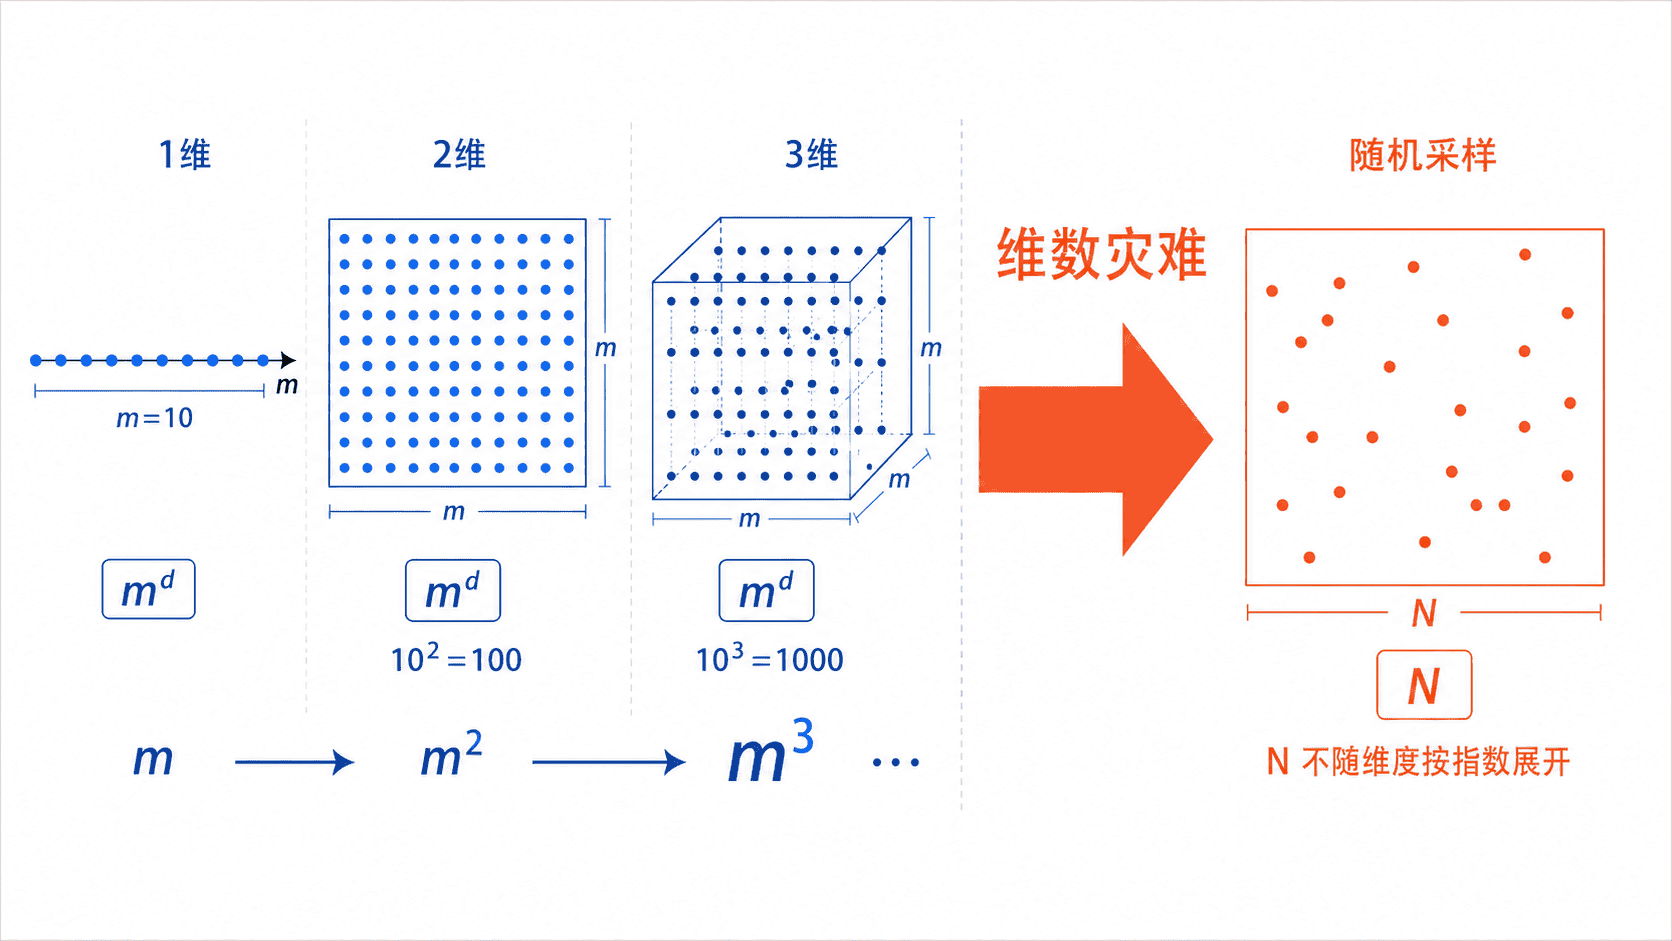
在一维区间上,每个方向取 个网格点只需要 次计算;但在 维空间中,每一维都取 个点,总点数会变成:
即使每维只取 个点,计算规模也会快速膨胀:
| 维度 | 网格点数 |
|---|---|
| 1 | |
| 2 | |
| 5 | |
| 10 |
这就是维数灾难:分辨率只按每维线性提高,总成本却按维度指数增长。存储、函数求值和遍历时间都会成为瓶颈。
随机采样如何估计积分
设要计算区域 上的积分:
若 具有有限的正体积, 可积,并能从该区域独立均匀采样 ,则有
因此可以用样本平均值估计积分:
与网格不同,蒙特卡洛方法只计算实际抽到的 个点,不需要在每个维度上铺满网格。若 的方差有限,估计量的标准误差为 。样本数的指数固定为 ,但方差、区域体积和单次采样或函数求值的成本仍可能随维度改变。
一个可验证的高维例子
考虑单位立方体 上的函数:
由于每个坐标在 上均匀分布时均值为 ,精确积分为:
随机采样时,只需生成 个 维样本,计算每个样本坐标和,再取平均。估计量无偏,其标准误差为:
例如 、 时,标准误差约为 。规则网格若每维取 个点则需要 次函数求值,二者的规模差异已经不是工程优化能够弥补的。
可以用标准库先运行较小的算例,比较样本标准误差和理论值。
from math import fsum, sqrt
from random import Random
from statistics import stdev

dimension, sample_count = 20, 50_000
rng = Random(42)
values = [sum(rng.random() for _ in range(dimension))
          for _ in range(sample_count)]
estimate = fsum(values) / sample_count
empirical = stdev(values) / sqrt(sample_count)
theory = sqrt(dimension / (12 * sample_count))

print(f"estimate={estimate:.6f} exact={dimension / 2:.6f}")
print(f"estimated SE={empirical:.6f} theoretical SE={theory:.6f}")
预期输出如下。
estimate=10.000291 exact=10.000000
estimated SE=0.005769 theoretical SE=0.005774
这个例子用到了各坐标独立,所以坐标和的方差等于各坐标方差之和。理论标准误差衡量重复独立实验的波动,单次误差可以更小,也可以更大。
随机采样也有代价
蒙特卡洛方法避免了网格点数的指数爆炸,但并不意味着高维问题自动变简单。
- 的收敛速度较慢,误差缩小到原来一半通常需要约四倍样本
- 若函数主要在极小区域取大值,均匀采样可能长期抽不到关键区域
- 对独立样本,维度升高可能增大被积函数的方差;对依赖样本,还要另外分析样本之间的相关性
- 复杂区域上的均匀采样本身可能很困难
例如在单位立方体中估计所有坐标都小于 的概率,真实值是 。在 、 时,命中次数的期望只有 ,几乎肯定一个都抽不到。样本全零时,直接算出的样本方差也是零,但这个结果没有捕捉到稀有事件。
重要性采样、分层采样与控制变量可利用问题结构降低方差。马尔可夫链蒙特卡洛主要用于从难以直接抽样的目标分布获取样本,链上样本通常相关。分析此时的误差时,需要检查链的收敛情况和有效样本量。
如何选择积分方法
| 场景 | 更合适的方法 | 原因 |
|---|---|---|
| 低维、函数平滑、精度要求高 | 高斯求积或自适应网格 | 收敛快,可利用函数平滑性 |
| 中高维、区域规则、可独立采样 | 蒙特卡洛积分 | 成本随样本数增长,不铺满网格 |
| 低差异序列可用、函数较平滑 | 准蒙特卡洛 | 常比纯随机采样更稳定 |
| 概率集中在狭小区域 | 重要性采样或分层采样 | 把样本集中到贡献最大的区域 |
一个实用判断是:当 已超出可承受的函数求值次数时,不应继续增加网格密度,而应转向采样方法或利用问题结构做降维。