
高等数学 / 系统课时
牛顿法的局部思想
牛顿法的局部思想
牛顿法不是简单地沿负梯度走固定距离,而是在当前位置建立一个二次近似,再求这个近似模型的驻点。在海森矩阵正定时,它就是该二次模型的唯一最小点。本课将从梯度和海森矩阵出发推导更新方向,并说明它何时高效、何时必须加入阻尼保护。
学习目标
- 写出目标函数在当前点附近的二次近似
- 推导牛顿方向 的来源
- 判断海森矩阵不可逆或非正定时的处理方式
从一阶下降到二阶校正
设当前参数为 ,位移为 ,梯度为 ,海森矩阵为 。二阶泰勒近似为:
把右侧看成关于 的二次函数,对 求梯度并令其为零:
若 可逆,就得到牛顿方向。
实际计算通常不显式求逆,而是求解线性方程 。这样数值更稳定,也能利用矩阵的稀疏或特殊结构。
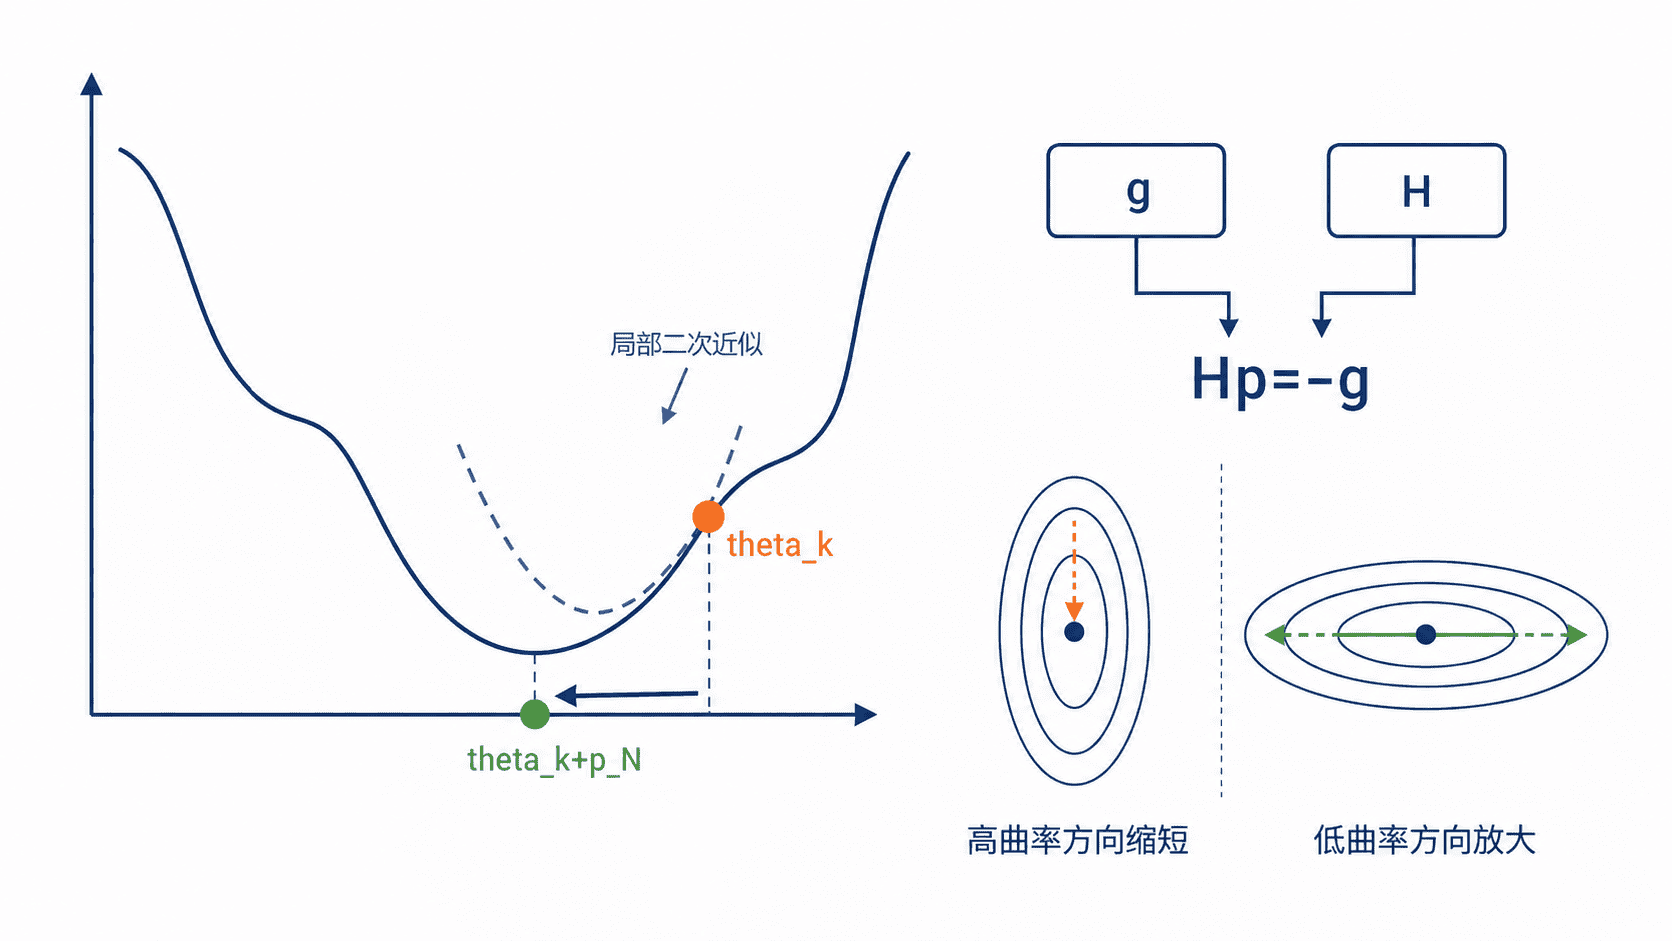
牛顿方向为什么会适应曲率
若 是正定矩阵,可在它的特征方向上理解更新。梯度在高曲率方向会被较大的特征值除小,因此步长自动缩短;在低曲率方向会被较小的特征值除大,因此步长相对增大。牛顿法由此能够缓解病态峡谷中不同方向尺度不一致的问题。
正定条件还保证牛顿方向是下降方向:
正定和非零梯度保证该内积为负。若矩阵不定,有的梯度下求得的方向也能下降,但没有统一保证。例如 从 出发,牛顿全步到达 ,损失从 升到 。矩阵接近奇异时,求得的步长还可能被放大。
主示例:二次函数一步到达极小点
考虑函数 。它的海森矩阵恒为 ,因此局部二次模型与原函数完全一致,牛顿法可从任意起点一步到达极小点。
def loss(x: float, y: float) -> float:
    return (x - 2) ** 2 + 4 * (y + 1) ** 2

def gradient(x: float, y: float) -> tuple[float, float]:
    return 2 * (x - 2), 8 * (y + 1)

def newton_step(x: float, y: float) -> tuple[float, float]:
    grad_x, grad_y = gradient(x, y)

    # 海森矩阵为对角阵,求解 Hp=-g 等价于分别除以对角元素
    step_x = -grad_x / 2
    step_y = -grad_y / 8
    return x + step_x, y + step_y

x0, y0 = 0.0, 0.0
x1, y1 = newton_step(x0, y0)

print(f"start=({x0:.1f}, {y0:.1f}) loss={loss(x0, y0):.1f}")
print(f"next=({x1:.1f}, {y1:.1f}) loss={loss(x1, y1):.1f}")
预期输出
start=(0.0, 0.0) loss=8.0
next=(2.0, -1.0) loss=0.0
一步收敛并不是所有函数都具备的性质。这里成立,是因为目标函数本身就是严格凸二次函数;对一般非线性函数,二次模型只在当前点附近可信,需要反复重建。
局部模型失效时如何保护
当当前位置离极小点较远、海森矩阵非正定或条件数过大时,可以使用阻尼牛顿法:
这里 使每个特征值增加 。对实对称海森矩阵,要确保修正矩阵正定,还需 。选定下降方向后,可用线搜索选择接受的步长。还可以加入线搜索,用 控制实际更新距离。若一次更新后真实损失没有下降,应增大阻尼或减小 ,而不是盲目接受二次模型给出的最低点。
完整海森矩阵需要 存储,稠密线性方程求解通常需要 时间。因此,参数规模很大时常采用拟牛顿法,或用海森向量积配合适用的迭代线性求解器,保留二阶缩放思想而避免显式构造完整矩阵。