
高等数学 / 系统课时
反向模式自动微分
反向模式自动微分
反向模式自动微分先完成一次正向计算并记录依赖关系,再从标量输出向输入反向累计梯度。本课通过一个微型自动求导引擎说明反向传播的顺序、梯度累加规则,以及它在机器学习中的计算优势。
学习目标
- 理解伴随量从输出向输入传播的过程
- 掌握计算图拓扑逆序与梯度累加规则
- 解释反向模式适合标量目标函数的原因
核心机制:先算值,再传梯度
设最终标量目标为 ,对任意中间量 定义伴随量:
反向模式分为两个阶段。正向阶段按程序顺序计算各节点的值,并保存父节点、局部导数或重新计算局部导数所需的信息;反向阶段令输出节点 ,再按计算图的逆拓扑顺序传播。若 ,反向更新为:
这里必须使用累加而不是覆盖,因为同一个变量可能通过多条路径影响最终目标。
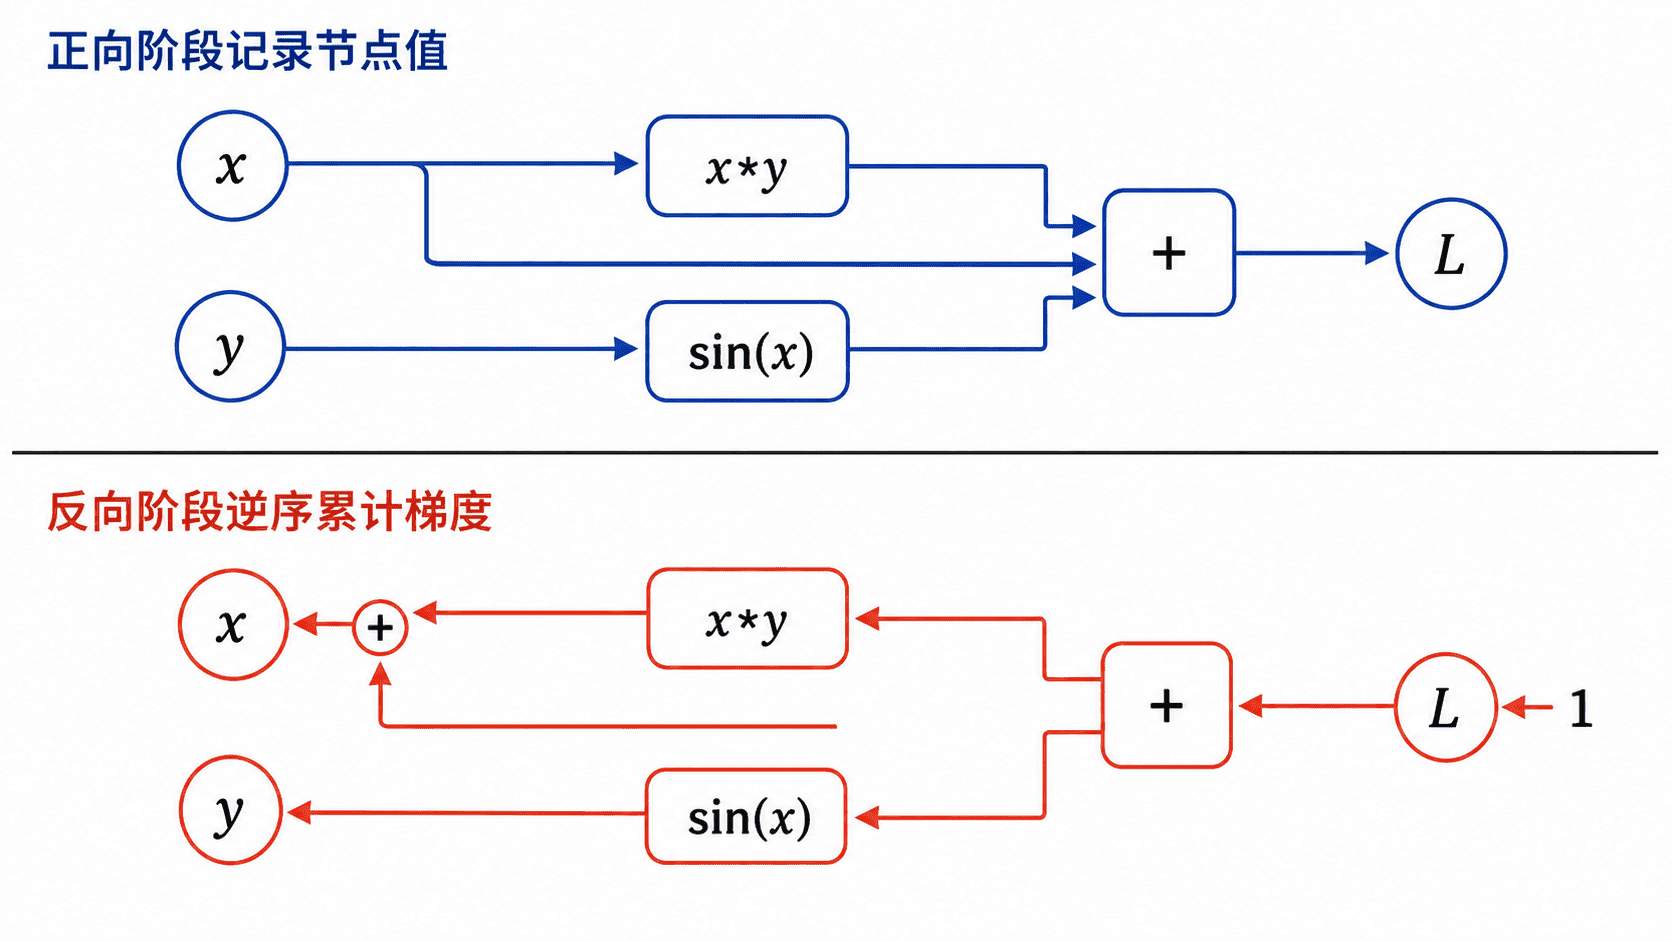
对函数 ,输出只有一个标量。反向阶段从这个输出开始,把它对每个中间量的影响逐层分解,最终同时得到完整梯度 。其计算量通常只是原函数计算的一个常数倍,不需要按每个输入变量重复执行整张计算图。
实现一个微型反向求导引擎
下面的 Node 保存数值、梯度、父节点和局部反向函数。backward() 先构造拓扑序,把这张图上的梯度归零,再逆序调用每个节点的局部规则。每次调用返回当前图的一份梯度。
import math
from typing import Callable

class Node:
    def __init__(self, value: float, parents=()):
        self.value = value
        self.grad = 0.0
        self.parents = tuple(parents)
        self._backward: Callable[[], None] = lambda: None

    def __add__(self, other: "Node") -> "Node":
        out = Node(self.value + other.value, (self, other))

        def backward() -> None:
            # 同一变量可能从多条路径影响输出,因此必须累加
            self.grad += out.grad
            other.grad += out.grad

        out._backward = backward
        return out

    def __mul__(self, other: "Node") -> "Node":
        out = Node(self.value * other.value, (self, other))

        def backward() -> None:
            self.grad += other.value * out.grad
            other.grad += self.value * out.grad

        out._backward = backward
        return out

    def sin(self) -> "Node":
        out = Node(math.sin(self.value), (self,))

        def backward() -> None:
            self.grad += math.cos(self.value) * out.grad

        out._backward = backward
        return out

    def backward(self) -> None:
        order = []
        visited = set()

        def build(node: "Node") -> None:
            if id(node) in visited:
                return
            visited.add(id(node))
            for parent in node.parents:
                build(parent)
            order.append(node)

        build(self)
        for node in order:
            node.grad = 0.0
        self.grad = 1.0

        # 逆拓扑顺序保证子节点的梯度贡献已经就绪
        for node in reversed(order):
            node._backward()

if __name__ == "__main__":
    x = Node(2.0)
    y = Node(3.0)
    loss = x * y + x.sin()

    loss.backward()

    print(f"loss = {loss.value:.6f}")
    print(f"dL/dx = {x.grad:.6f}")
    print(f"dL/dy = {y.grad:.6f}")
预期输出:
loss = 6.909297
dL/dx = 2.583853
dL/dy = 2.000000
在表达式中, 同时影响乘法节点和正弦节点,所以它的梯度由两条路径贡献: 与 。反向传播到 时,两部分通过 += 合并,得到 。
正确性、存储代价与模式选择
反向顺序必须是拓扑逆序。若父节点在所有子节点贡献尚未到达前就执行反向函数,梯度会不完整;共享变量的梯度必须累加,覆盖写入只会保留最后一条路径。
本例每次清零所有可达节点的伴随量,避免旧的中间梯度被再次传播。PyTorch 通常在叶子参数上累加每次新得到的梯度,训练循环通过优化器显式管理这些叶子梯度。重复使用同一 PyTorch 前向图还涉及图的释放。
反向模式需要保存正向阶段的中间结果,或在反向时重新计算。这个教学实现会读节点的前向值,构图后至反向结束前应保持这些值不变。大型模型训练中的激活值会占用大量显存,梯度检查点正是用额外计算换取更低存储开销。
前向模式一次高效计算 ,成本更接近输入方向数量;反向模式一次高效计算 ,成本更接近输出方向数量。对标量损失,,一次反向传播即可得到全部参数梯度,因此特别适合“参数很多、损失很少”的机器学习训练。