
高等数学 / 系统课时
自适应学习率
自适应学习率
固定学习率会让所有参数共享同一更新尺度,难以同时照顾稀疏特征、陡峭方向与平坦方向。本课从历史梯度出发,解释 AdaGrad、RMSProp 和 Adam 如何为每个参数自动调整步长,并通过可运行示例比较三者的更新结果。
学习目标
- 理解逐参数学习率与历史梯度统计量的关系
- 说清 AdaGrad、RMSProp 和 Adam 的核心差异
- 能根据训练现象选择方法并识别常见调参误区
固定学习率的问题
梯度下降使用统一学习率 :
当不同参数的梯度尺度差异很大时,同一个 往往顾此失彼。学习率过大,陡峭方向会震荡;学习率过小,平坦方向又前进缓慢。自适应方法的共同思路,是为每个参数维护自己的历史统计量,再把全局学习率缩放为逐参数步长。
三种方法如何调整步长
AdaGrad 累加所有历史平方梯度:
某个参数过去梯度越大,之后的有效步长越小。它适合稀疏特征,但累计量只增不减,训练较久后学习率可能衰减过度。RMSProp 用指数移动平均替代永久累加:
其参数更新仍按 缩放,因此更关注近期梯度,能避免 AdaGrad 的步长持续缩小。
Adam 在此基础上同时维护一阶动量 和二阶矩 :
从零初始化且 从 计数,使用 、。之后每步以 更新。这里 防止分母过小,实际框架在其放置位置等细节上可能不同。直观上,动量决定“朝哪个方向继续前进”,平方梯度决定“每个参数走多大一步”。
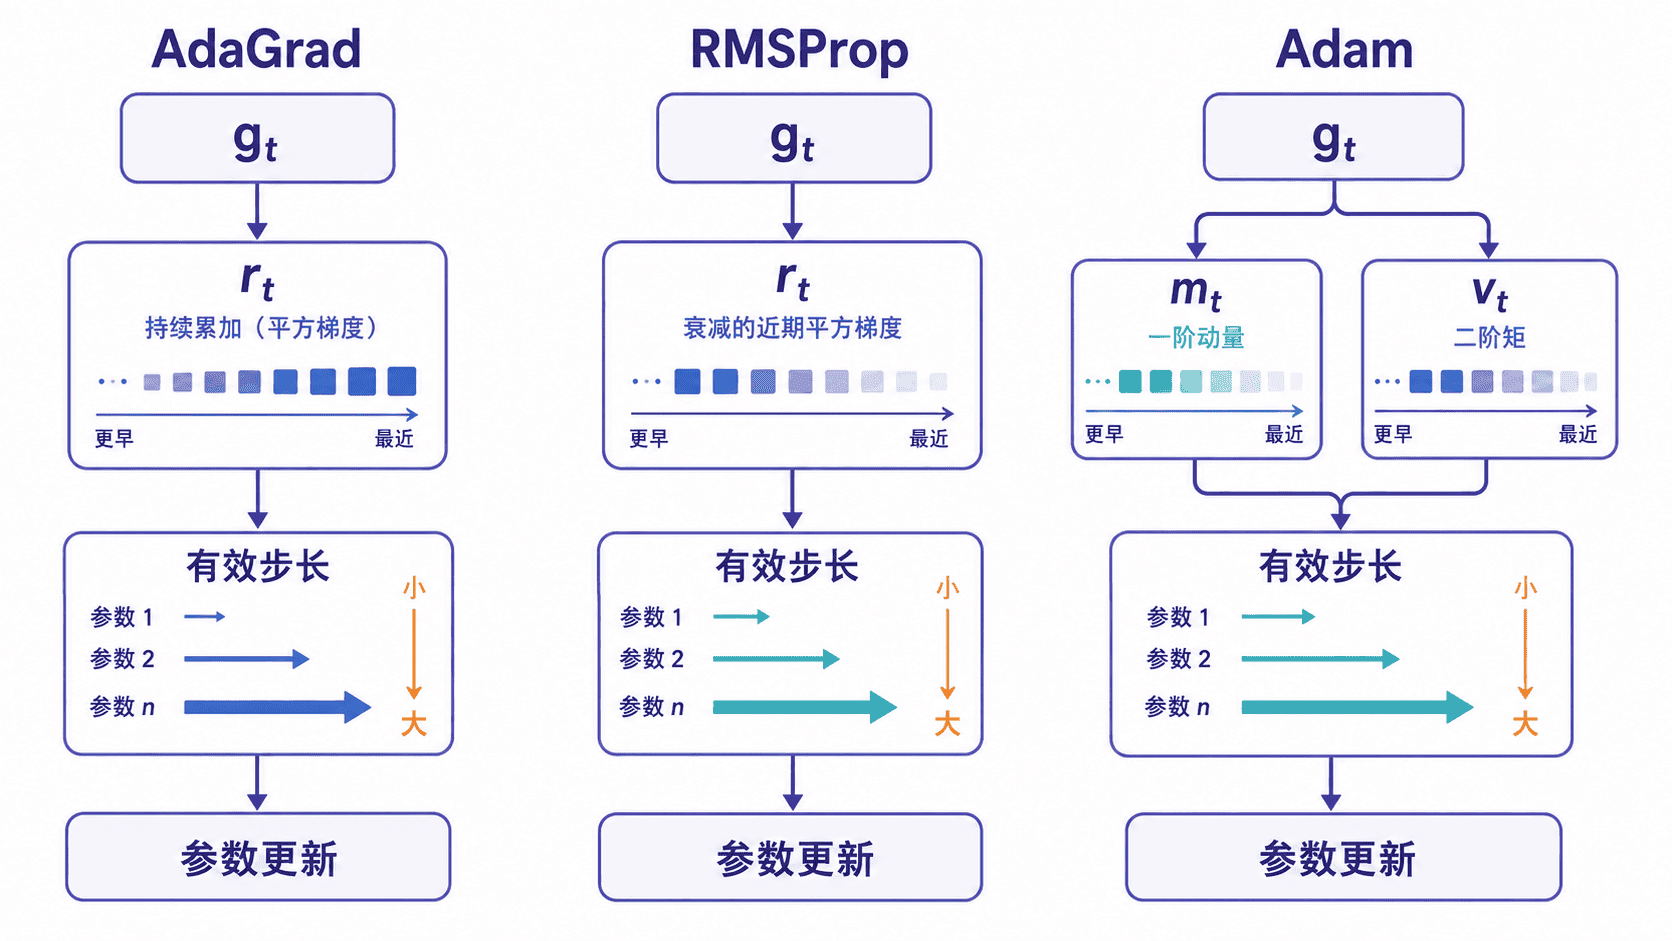
选择时可先用 Adam 作为稳健基线;稀疏线性模型可考虑 AdaGrad;需要更直接控制近期梯度尺度时可用 RMSProp。无论选择哪种方法,基础学习率仍然重要,自适应并不等于无需调参。
可运行示例:比较逐参数更新
下面用同一组二维梯度分别执行三种更新。第二个维度的梯度始终更大,它的梯度始终是第一维的十倍。平方统计量也近似按平方比例缩放,因此这组输入中,两维的实际更新量几乎相同,而有效学习率不同。
import numpy as np

# 使用同一组梯度,只比较三种更新规则本身
grads = [
    np.array([0.2, 2.0]),
    np.array([0.1, 1.0]),
    np.array([0.05, 0.5]),
]

def run_adagrad():
    theta = np.array([1.0, -1.0])
    acc = np.zeros(2)
    for g in grads:
        # AdaGrad 的平方梯度累计量不会衰减
        acc += g * g
        theta -= 0.1 * g / (np.sqrt(acc) + 1e-8)
    return theta

def run_rmsprop():
    theta = np.array([1.0, -1.0])
    avg_sq = np.zeros(2)
    for g in grads:
        # 指数衰减让近期梯度拥有更高权重
        avg_sq = 0.9 * avg_sq + 0.1 * g * g
        theta -= 0.1 * g / (np.sqrt(avg_sq) + 1e-8)
    return theta

def run_adam():
    theta = np.array([1.0, -1.0])
    m = np.zeros(2)
    v = np.zeros(2)
    for t, g in enumerate(grads, start=1):
        m = 0.9 * m + 0.1 * g
        v = 0.999 * v + 0.001 * g * g
        # 偏差修正避免训练初期统计量被低估
        m_hat = m / (1 - 0.9 ** t)
        v_hat = v / (1 - 0.999 ** t)
        theta -= 0.1 * m_hat / (np.sqrt(v_hat) + 1e-8)
    return theta

for name, fn in [
    ("AdaGrad", run_adagrad),
    ("RMSProp", run_rmsprop),
    ("Adam", run_adam),
]:
    print(f"{name:7s}", np.round(fn(), 6))
预期输出
AdaGrad [ 0.833457 -1.166543]
RMSProp [ 0.460867 -1.539133]
Adam    [ 0.722512 -1.277488]
结果不同并不代表某种方法绝对更优,因为这里展示的是更新规则,而不是完整损失函数上的收敛质量。实际训练应同时观察损失曲线、验证集指标、梯度范数和参数更新幅度。