
高等数学 / 系统课时
高阶自动微分
高阶自动微分
高阶自动微分是在一阶梯度之上继续求导,用于获得二阶导数、曲率信息和海森向量积。本课将说明它如何构建“梯度的计算图”,并通过代码验证二阶结果。
学习目标
- 说明二阶导数与海森矩阵表达的曲率信息
- 使用可微的一阶梯度继续计算二阶梯度
- 理解海森向量积的计算方式和主要应用
从一阶梯度到高阶梯度
对标量函数 ,一阶导数描述局部变化率,二阶导数描述变化率本身如何变化。多变量函数的二阶偏导数组成海森矩阵 ,它刻画不同方向上的局部曲率。
高阶自动微分并不是重新手写导数公式,而是让一阶梯度也保留计算历史。随后,自动微分系统把这个梯度表达式当作新的计算图,再执行一次求导。
高阶求导如何构图
普通反向传播通常只需要数值梯度,因此完成后可以释放相关图结构。若要继续求二阶导数,使用本课的反向再反向写法时,第一次求导开启 create_graph 来构建梯度图。单独保留原图不等于记录求导运算。若一阶导数是常量,数学上二阶导数为零,框架可能返回没有计算历史的常量。
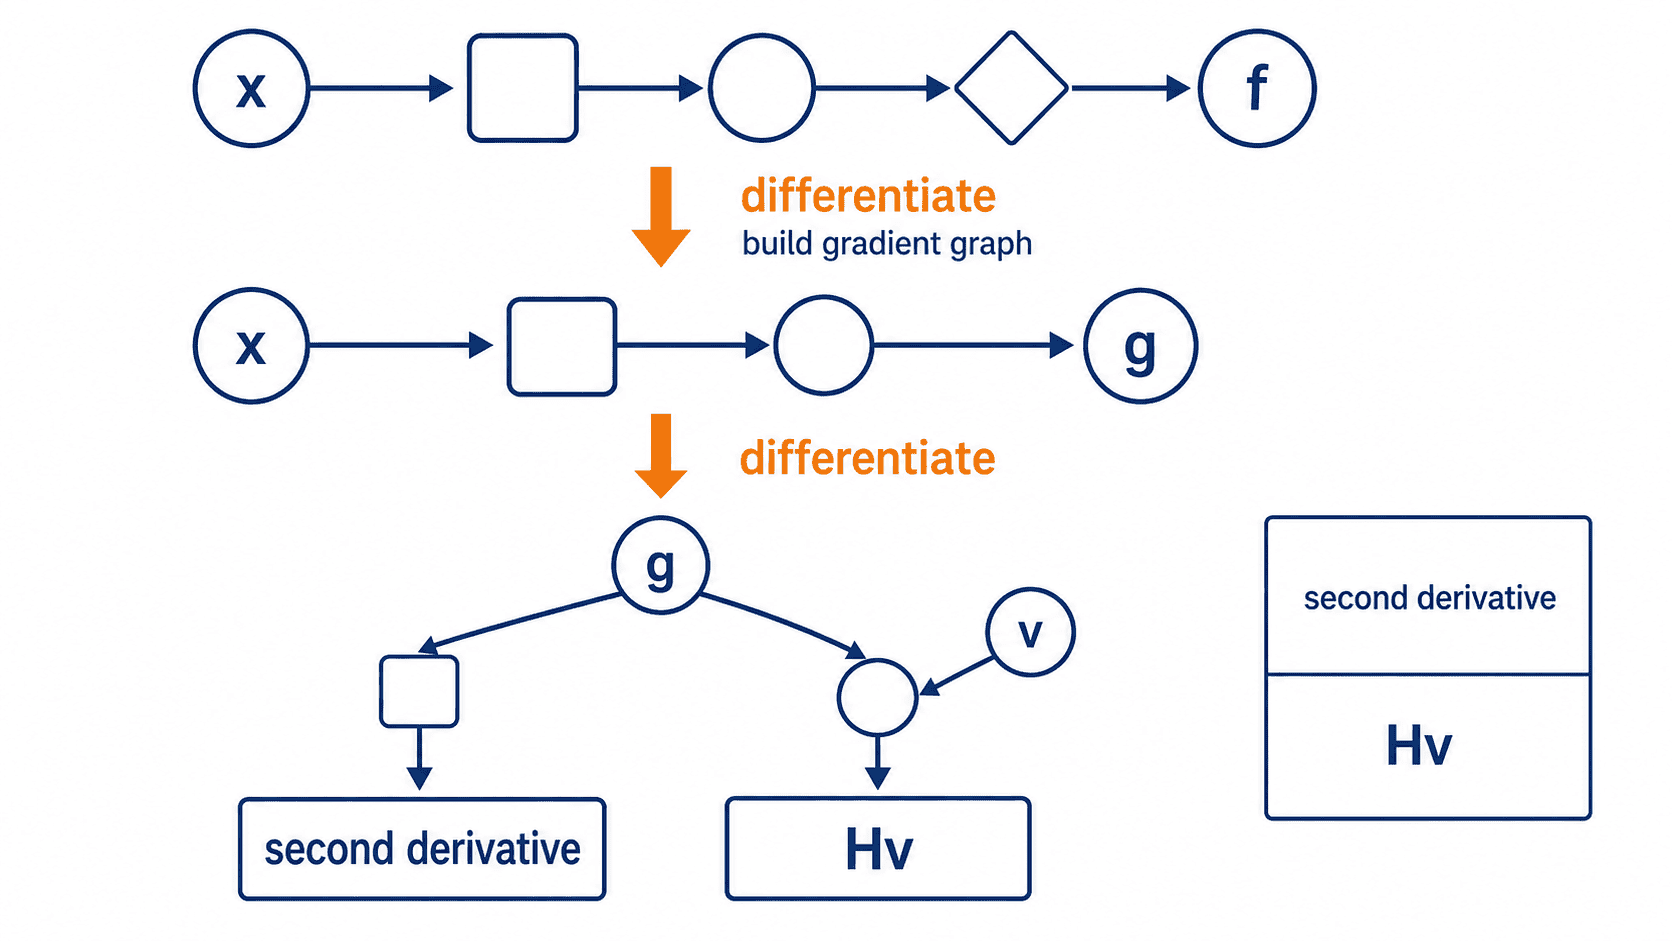
用代码计算二阶导数
下面计算 在 处的一阶和二阶导数。第一次调用 autograd.grad 时设置 create_graph=True,使返回的一阶梯度仍然可导。
python
import torch

x = torch.tensor(3.0, requires_grad=True)
f = x ** 4 + 2 * x ** 2

# 保留一阶梯度的计算图,供第二次求导使用
(first_grad,) = torch.autograd.grad(f, x, create_graph=True)
(second_grad,) = torch.autograd.grad(first_grad, x)

print(f"f={f.item():.1f}")
print(f"first_grad={first_grad.item():.1f}")
print(f"second_grad={second_grad.item():.1f}")
预期输出
text
f=99.0
first_grad=120.0
second_grad=112.0
对于多变量函数,完整海森矩阵可能很大。实际优化更常计算海森向量积:
令 与 无关,并假设 二阶连续可微,使 Hessian 对称。梯度与 的内积再对 求导,就得到 。下面直接把固定的 作为第二次反传的权重。
python
import torch

x = torch.tensor([1.0, 2.0], requires_grad=True)
v = torch.tensor([2.0, -1.0])
f = x[0] ** 2 + x[0] * x[1] + 3 * x[1] ** 2
(g,) = torch.autograd.grad(f, x, create_graph=True)
(hv,) = torch.autograd.grad(g, x, grad_outputs=v)
torch.testing.assert_close(hv, torch.tensor([3.0, -4.0]))
print(hv.tolist())
该例输出 [3.0, -4.0],与手算 Hessian 乘向量相同。它常用于 Newton-CG、曲率分析、元学习和物理信息神经网络。
需要注意,高阶图会增加内存与计算开销;分段线性函数在不可导点还可能产生不稳定或约定化的二阶结果。若只需一阶训练,不应无条件开启 create_graph=True。
按自己的节奏,确认真正理解。