
高等数学 / 系统课时
蒙特卡洛积分
蒙特卡洛积分
当被积函数没有容易求出的原函数,或积分维度很高时,可以用随机样本的平均值近似积分。本课从“积分等于区间长度乘函数平均值”出发,给出可运行的 Python 实现,并说明误差与高维优势。
学习目标
- 将定积分改写为随机变量期望,并写出蒙特卡洛估计式
- 使用固定随机种子完成一次可复现的数值积分
- 理解样本数、误差、维度与计算成本之间的关系
从积分到随机平均
设 , 在区间上可积, 在 上均匀分布。 的期望是带符号的区间平均值,因而有
抽取 个独立样本 后,用样本均值替代真实期望:
在独立均匀采样下,该估计量的期望等于目标积分。样本增加后估计通常更稳定,但一次具体运行的绝对误差可能先变大再变小。
执行过程
一次基础蒙特卡洛积分可以按四步完成:
- 确定积分区域与被积函数。
- 在积分区域内独立均匀采样。
- 计算每个样本点对应的函数值。
- 用区域大小乘函数值平均数,得到积分估计。
一维区间的大小是 ,长方体的体积是各边长度的乘积。若改用非均匀的采样密度 ,则应在 覆盖被积函数非零区域的条件下平均 。
Python 主示例
下面用 Python 标准库估计 。区间长度为 ,样本均值就是积分估计。若 方差有限,估计量的标准差为 。代码用样本标准差代替未知的 ,报告标准误差估计。
import math
import random
from statistics import stdev


def monte_carlo_integral(sample_count: int) -> tuple[float, float]:
    if sample_count < 2:
        raise ValueError("估计标准误差至少需要两个样本")
    rng = random.Random(42)
    values = [math.exp(-rng.random() ** 2) for _ in range(sample_count)]
    estimate = math.fsum(values) / sample_count
    standard_error = stdev(values) / math.sqrt(sample_count)
    return estimate, standard_error


estimate, standard_error = monte_carlo_integral(100_000)
reference = math.sqrt(math.pi) * math.erf(1.0) / 2
print(f"蒙特卡洛估计: {estimate:.6f}")
print(f"参考值: {reference:.6f}")
print(f"绝对误差: {abs(estimate - reference):.6f}")
print(f"标准误差估计: {standard_error:.6f}")
预期输出如下。
蒙特卡洛估计: 0.746625
参考值: 0.746824
绝对误差: 0.000199
标准误差估计: 0.000636
标准误差描述重复进行独立采样时估计值的典型波动尺度。单次运行若没有已知参考值,仍可报告标准误差估计。固定种子用于复现实验;要比较多次独立模拟,需避免每次都重置到同一个种子。
为什么适合高维积分
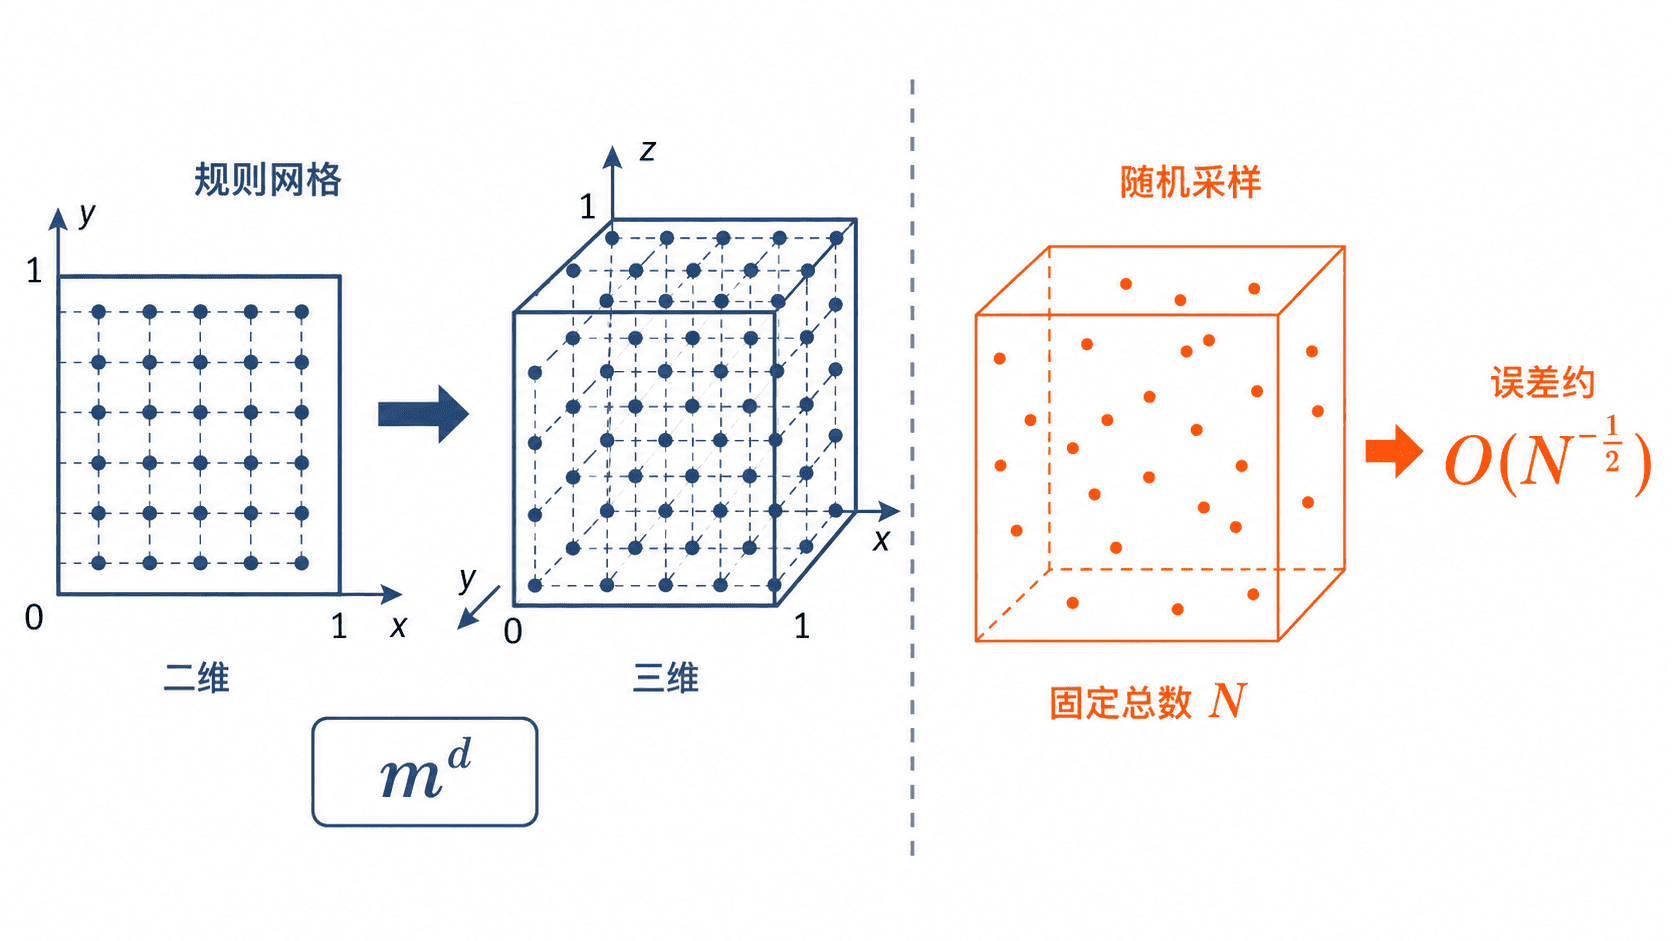
在 维长方体区域 上独立均匀采样,积分仍可用体积乘样本平均值估计。
规则网格若每个维度取 个点,总点数会增长为 ;蒙特卡洛方法则可以直接规定总样本数 。若方差有限,积分估计的标准差为 。 这一指数不随维度改变,但体积、方差和单次计算成本仍可能随维度变化,稀有区域也可能很难采到。
误差与使用边界
独立采样且方差有限时,样本数扩大到四倍会让标准误差减半。若函数值波动很大,可以考虑分层采样、重要性采样或控制变量。均值存在而方差无限时,基础估计量仍可随样本增大而收敛,但上述标准误差公式无法使用。
对不规则区域,可从已知体积的包围盒均匀采样,把落在目标区域外的贡献记为零,并用包围盒体积乘全部样本的平均值。只保留区域内样本再乘包围盒体积,会遗漏落入区域的概率因子。