
高等数学 / 系统课时
向量场与生成模型
向量场与生成模型
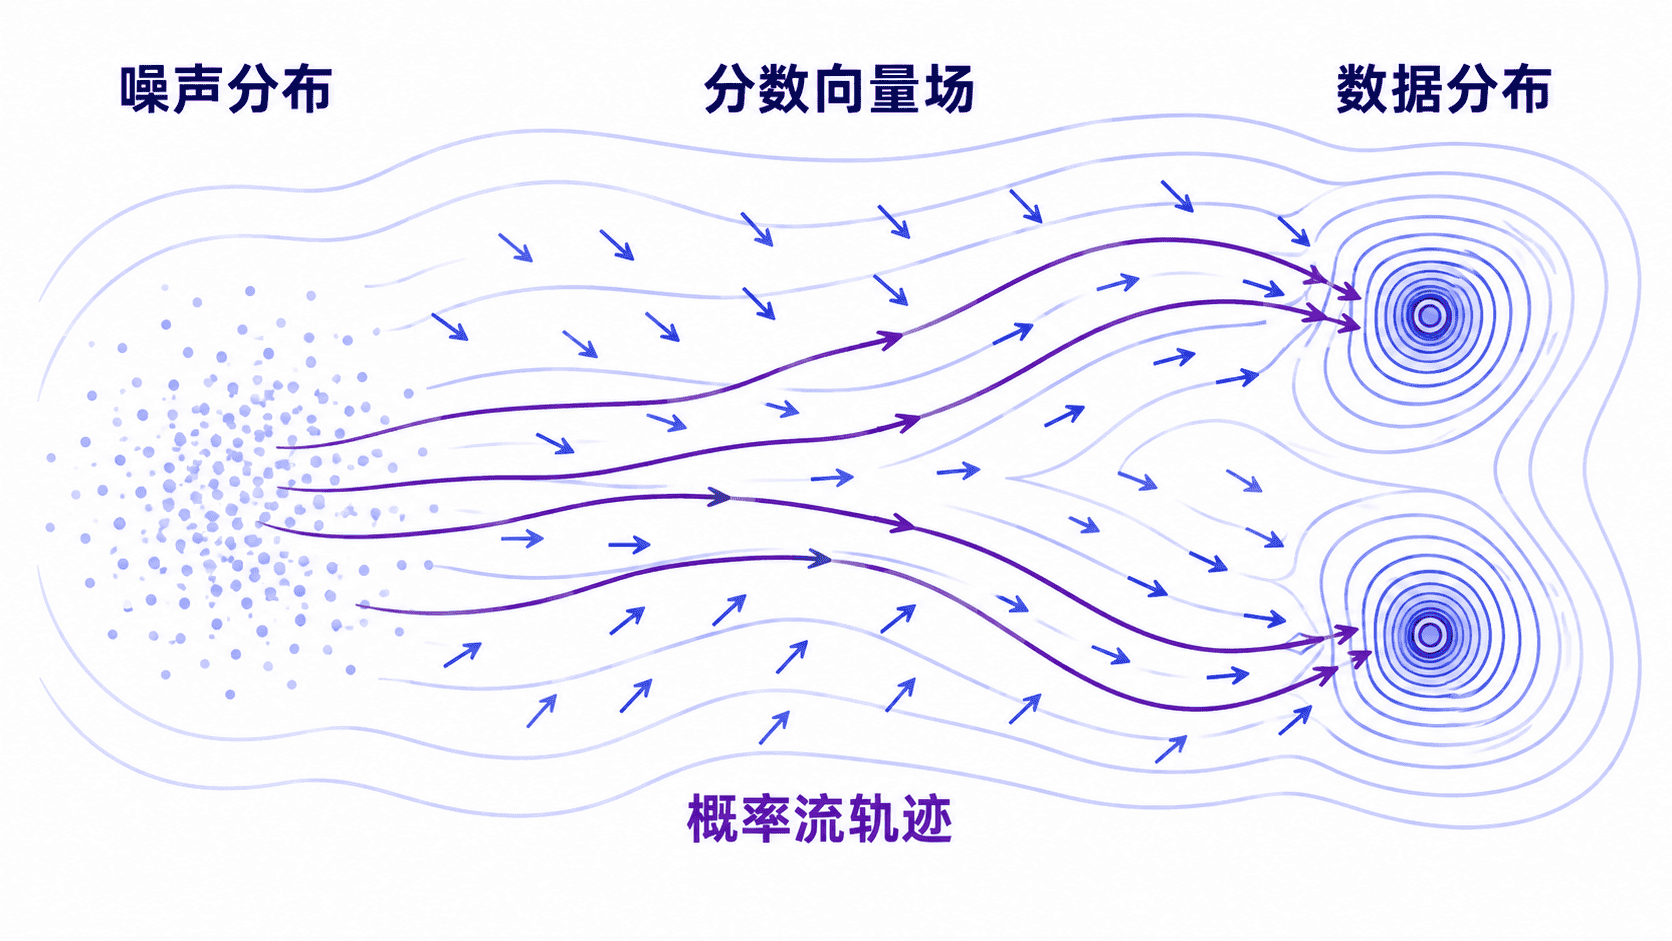
连续时间扩散模型可以用随时间变化的向量场描述样本分布的演化。本课用向量场统一理解分数函数、概率流与连续生成:先明确每个位置上的方向从哪里来,再说明噪声如何沿连续轨迹逐步变成数据样本。
学习目标
- 理解向量场在连续生成过程中的作用
- 说明分数函数为何指向概率密度增大的方向
- 区分分数、速度场与概率流 ODE
从点到方向:生成过程的几何语言
向量场为状态空间中的每个位置分配一个向量。若样本状态为 ,时间为 ,可写成 。它既给出移动方向,也通过向量长度表达移动速度,因此能描述样本随时间连续变化的轨迹。
在生成模型中,初始点通常来自容易采样的噪声分布。模型学习的并不是一张固定图片,而是一个随位置和时间变化的方向规则。求解对应微分方程后,噪声点便沿轨迹移动到数据分布附近。
分数函数:指向高概率区域
设时刻 的密度 可微,且在所考察位置为正。分数定义为
它是对数概率密度关于样本位置的梯度。当分数非零时,它指向对数密度局部增长最快的欧氏单位方向。由于 ,该方向也与密度梯度一致,但分数只提供局部信息。
分数不是概率值,也不是样本本身的运动速度。它只描述局部密度地形的上升方向;真正的速度场通常还会组合漂移项、噪声强度和时间系数。
概率流:把随机演化改写为确定性轨迹
扩散过程常用随机微分方程表示:
其中 是漂移项, 控制噪声强度, 表示随机扰动。在适当条件下,可构造具有相同边缘概率分布的概率流 ODE:
概率流 ODE 与对应 SDE 在同一初始分布、真实分数及相应正则性条件下具有相同的时刻边缘分布。给定起始点且速度场满足解的唯一性条件,ODE 轨迹是确定的。两者的单条轨迹及跨时刻联合分布一般不同。
连续生成时实际发生了什么
生成时从终端分布 或设计好的简单近似分布采样,再将时间从 积分到 。采样目标是整体分布匹配,单条轨迹不必一直朝高密度处移动。使用近似分数、近似终端分布和有限步积分都会带来误差。
例如一维布朗运动从 出发,正向有 。其分数为 ,概率流速度为 。在正向时间里,非零点远离原点。反向积分则将终点 映射为 。
import math

end_time = 4.0
end_point = 2 * math.sqrt(1 + end_time)
time, point = end_time, end_point
steps = 1000
dt = -end_time / steps

for _ in range(steps):
    point += dt * point / (2 * (1 + time))
    time += dt

exact = end_point / math.sqrt(1 + end_time)
assert math.isclose(exact, 2.0)
assert abs(point - exact) < 0.003
print(f"Euler={point:.6f}, exact={exact:.6f}")
需要特别区分三种量:分数场描述“哪里概率更高”,速度场描述“样本此刻怎样移动”,概率流 ODE 则用速度场规定每个样本的连续轨迹,并由所有样本共同实现分布的演化。