高等数学 / 系统课时

期望的积分形式

期望的积分形式

连续随机变量不能把每个取值逐项相加,因此它的“平均值”要用积分表达。本课从加权平均出发,说明密度函数如何为不同取值分配权重,并把期望公式连接到 AI 中常见的平均损失与风险计算。

学习目标

  • 理解连续随机变量期望是“取值乘权重”的连续加权平均
  • 会计算 E[X]E[X] 与更一般的 E[g(X)]E[g(X)]
  • 能判断期望是否存在,并避免把密度值当成概率

从离散加权平均到连续积分

离散随机变量的期望写成 E[X]=∑ixipiE[X]=\sum_i x_i p_i:每个可能取值 xix_i 乘以它的概率 pip_i,再把所有贡献相加。连续随机变量有无穷多个可能取值,对于具有密度的变量,每个单点的概率均为零,不能继续逐项求和。

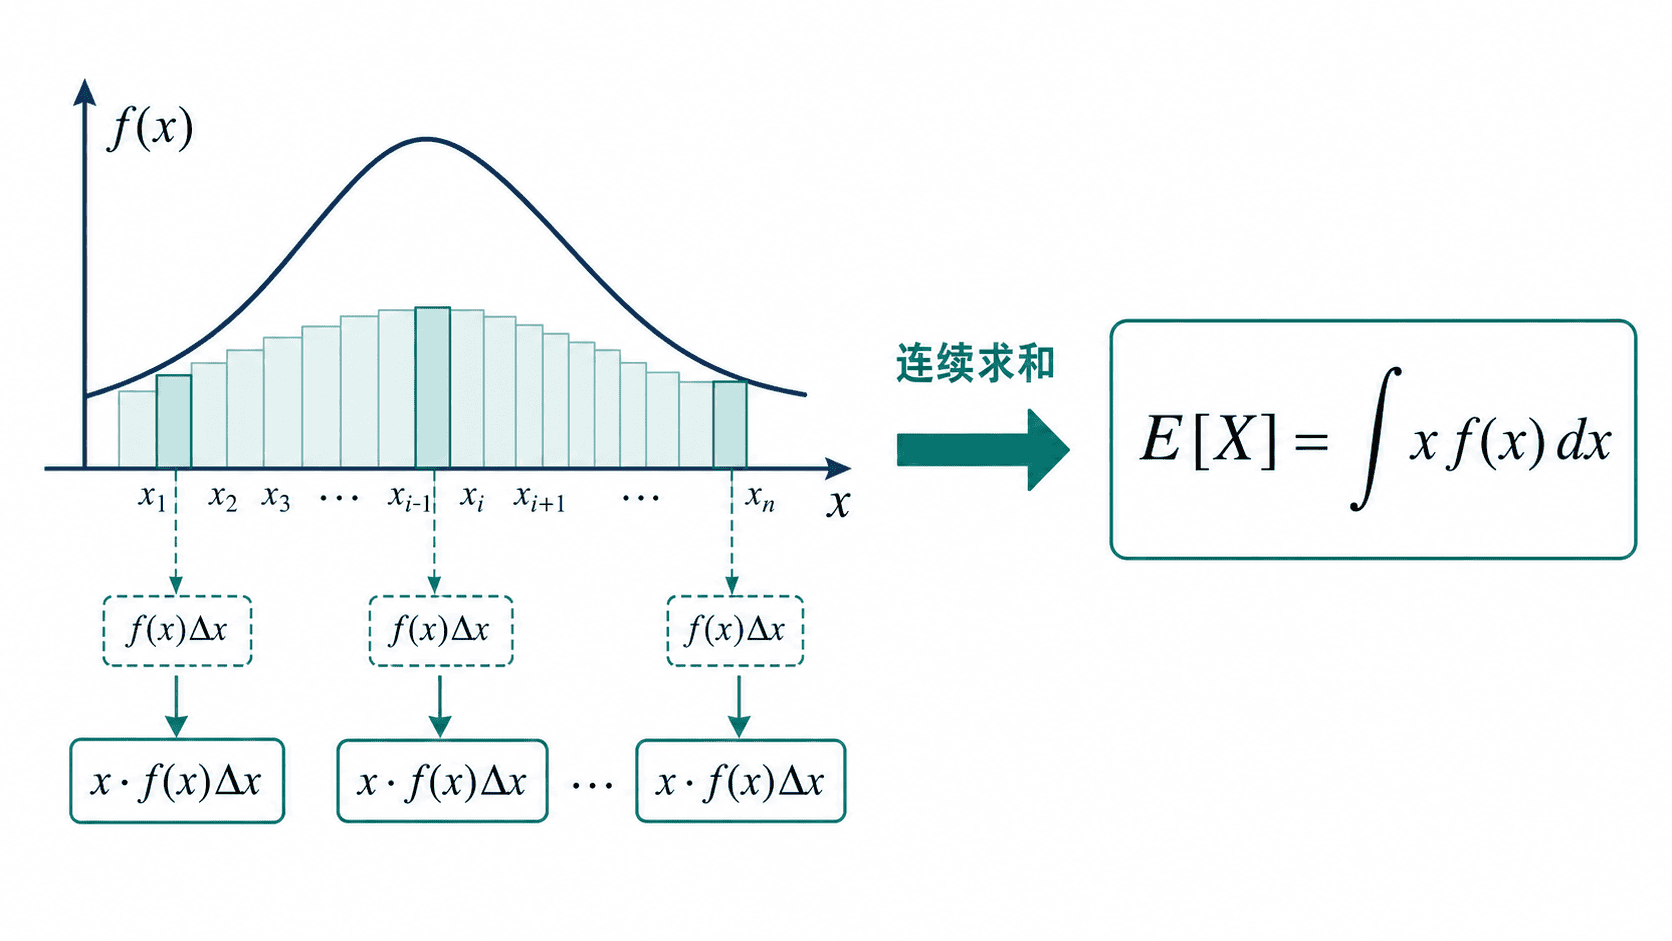
把取值轴切成很多小区间后,在密度连续处,较窄的区间 [x,x+Δx][x,x+\Delta x] 的概率可近似为 fX(x)Δxf_X(x)\Delta x。该区间对平均值的贡献约为 xfX(x)Δxx f_X(x)\Delta x。当区间宽度趋近于零,求和就变成积分:

E[X]=∫−∞∞xfX(x) dxE[X]=\int_{-\infty}^{\infty}x f_X(x)\,dx

连续随机变量期望的加权面积示意

这里的 fX(x)f_X(x) 不是“点 xx 的概率”,而是单位长度上的概率密度。真正参与加权的是小区间概率 fX(x)dxf_X(x)dx。

期望不只用于变量本身

很多任务关心的不是 XX,而是它经过函数变换后的结果。例如模型误差、收益或能耗都可以写成 g(X)g(X)。其期望为:

E[g(X)]=∫−∞∞g(x)fX(x) dxE[g(X)]=\int_{-\infty}^{\infty}g(x)f_X(x)\,dx

这条公式不要求先求出新随机变量 Y=g(X)Y=g(X) 的密度,直接在原变量上积分即可。在机器学习中,若样本 (X,Y)(X,Y) 来自分布 p(x,y)p(x,y),总体风险可写成:

R(θ)=E[ℓ(θ;X,Y)]R(\theta)=E[\ell(\theta;X,Y)]

对固定的参数,若样本独立地来自目标分布且损失有有限期望,样本平均损失可用来估计总体风险。若参数由同一训练集选出,训练平均损失可能偏低,可在独立验证集上估计泛化表现。

主示例:指数分布的平均等待时间

设等待时间 XX 的密度为:

fX(x)={2e−2x,x≥00,x<0f_X(x)= \begin{cases} 2e^{-2x}, & x\ge 0 \\ 0, & x<0 \end{cases}

期望只需在密度非零的区间积分:

E[X]=∫0∞2xe−2x dx=12E[X]=\int_0^{\infty}2x e^{-2x}\,dx=\frac{1}{2}

分部积分取 u=xu=x、dv=2e−2xdxdv=2e^{-2x}dx,得到边界项 [−xe−2x]0∞=0[-xe^{-2x}]_0^\infty=0,剩下 ∫0∞e−2xdx=1/2\int_0^\infty e^{-2x}dx=1/2。因此平均等待时间为 0.50.5 个时间单位。计算结果不是“最可能出现的等待时间”,而是大量独立观察值的长期平均。

期望存在的条件与常见误区

有限期望存在的条件是绝对可积。

∫−∞∞∣x∣fX(x) dx<∞\int_{-\infty}^{\infty}|x|f_X(x)\,dx<\infty

绝对积分发散时,先分别考察正部和负部。若只有一侧发散,可得到相应符号的无穷期望。若两侧都发散,则期望未定义。例如标准柯西分布的密度为 1/[π(1+x2)]1/[\pi(1+x^2)],在 [0,R][0,R] 上的加权积分是 ln⁡(1+R2)/(2π)\ln(1+R^2)/(2\pi),会无界增长。负半轴同样发散。对称截断 [−R,R][-R,R] 得到零仅是主值。

密度达到最大值的位置可作为众数。对具有密度的变量,中位数是累计概率等于 1/21/2 的位置,可能有多个。期望由按概率加权的取值决定。三者可以相等,也可以各不相同。

按自己的节奏,确认真正理解。

目录与阅读设置

阅读设置

17

记录一个想法

期望的积分形式

0 / 10000 · 笔记保存到账号。未提交的修改会在关闭、离开或刷新后丢失。

登录哪都通