
高等数学 / 系统课时
梯度累积与清零
梯度累积与清零
本课解释自动微分框架为什么会把多次反向传播的结果相加,并给出训练循环中清零梯度的正确位置。掌握这一点,可以避免参数更新使用上一轮残留梯度。
学习目标
- 说明梯度默认累积的原因
- 正确安排清零、反向传播和参数更新的顺序
- 区分误操作累积与有意的微批次累积
累积机制与实际现象
在 PyTorch 中,叶子张量的梯度保存在 .grad 属性里。每次调用 backward() 时,新梯度会加到已有值上,而不是自动覆盖。这样既能合并多个损失项,也能把大批次拆成多个微批次后统一更新。
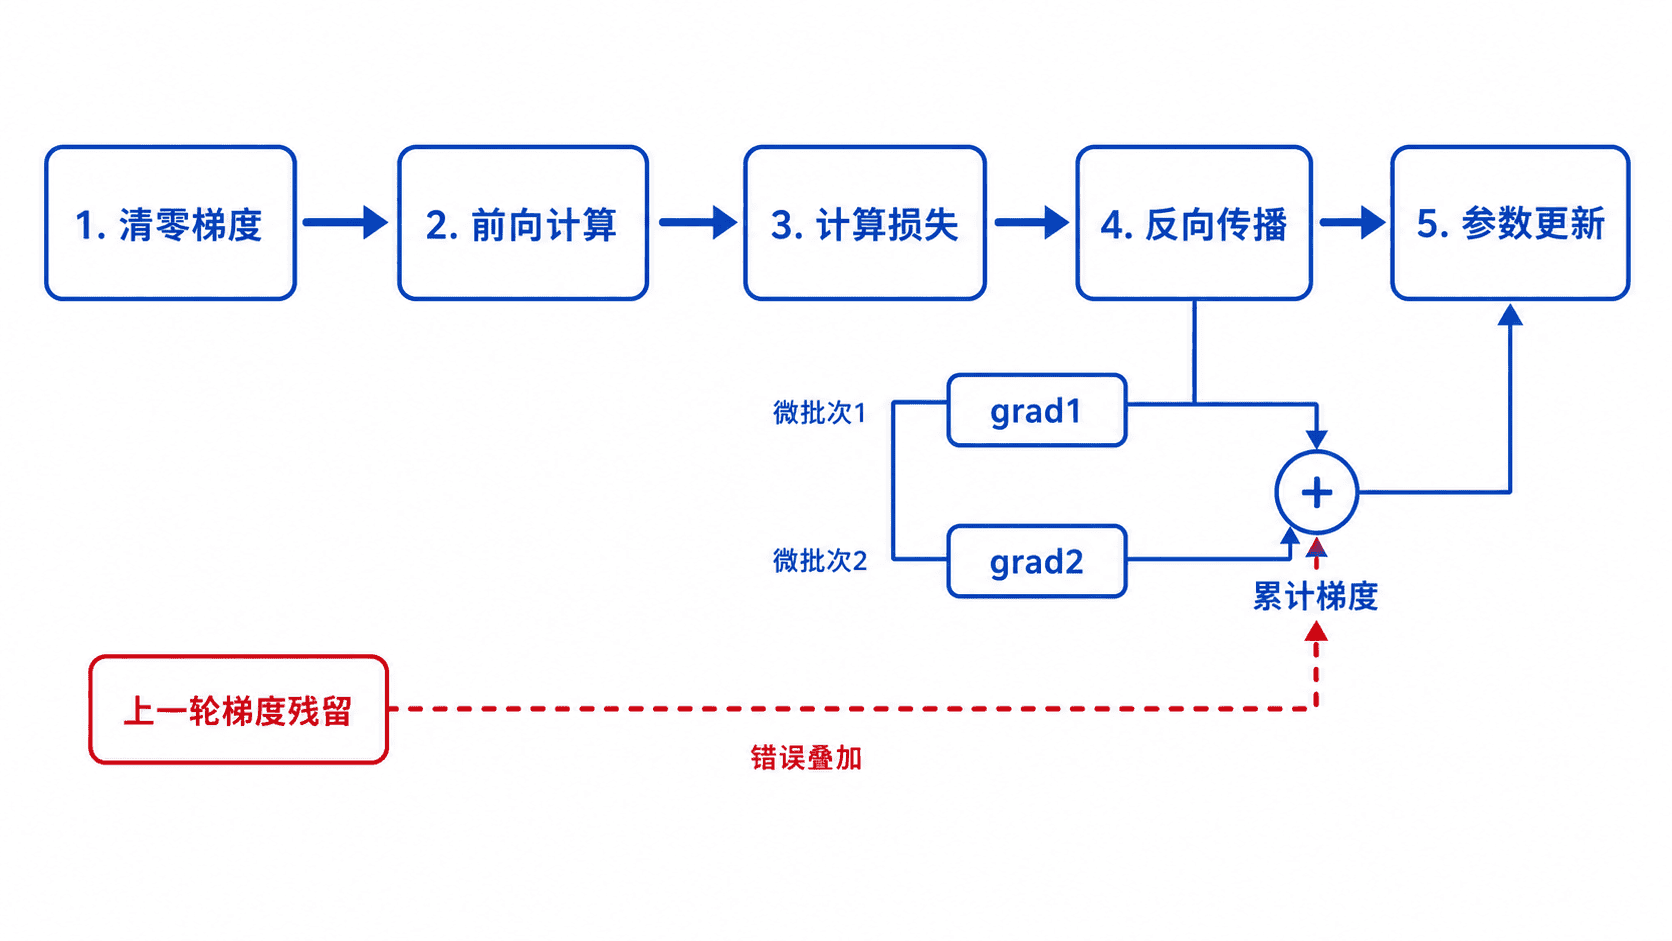
下面的完整示例连续执行两次反向传播。第二次的 .grad 是两次梯度之和;清零后再次计算,才只保留当前样本的梯度。
import torch

w = torch.tensor(2.0, requires_grad=True)
samples = [(1.0, 3.0), (2.0, 5.0)]

for index, (x, y) in enumerate(samples, start=1):
    prediction = w * x
    loss = (prediction - y) ** 2
    loss.backward()
    print(f"after sample {index}: grad={w.grad.item():.1f}")

# 原地清空旧梯度,再单独计算第二个样本
w.grad.zero_()
x, y = samples[1]
loss = (w * x - y) ** 2
loss.backward()
print(f"after zero and sample 2: grad={w.grad.item():.1f}")
预期输出:
after sample 1: grad=-2.0
after sample 2: grad=-6.0
after zero and sample 2: grad=-4.0
第二个样本自身产生的梯度是 ,但第一次的 仍留在 .grad 中,所以连续两次反向传播后得到 。
正确训练循环
常规训练中,每个批次更新一次参数,顺序应是清零梯度、前向传播、计算损失、反向传播、参数更新。
optimizer.zero_grad(set_to_none=True)
prediction = model(inputs)
loss = loss_fn(prediction, targets)
loss.backward()
optimizer.step()
这是片段示例,依赖已创建的 model、optimizer、loss_fn、inputs 和 targets。执行后,optimizer.step() 只使用本批次新生成的梯度;可在 backward() 前后打印任一参数的 .grad 进行验证。
把清零放在上一次 step() 之后也能形成闭环,但放在当前批次开头更直观,也能减少训练中途异常后误用残留梯度的风险。绝不能在 backward() 与 step() 之间清零,否则优化器看不到刚计算出的梯度。
有意累积与清零边界
显存不足时,可以把一个逻辑批次拆成 个微批次。此时只在累计开始前清零,连续执行 次反向传播,最后调用一次 step()。
若各微批次的平均损失分母相同,每个微批次可乘 。若第 个微批次有 个有效样本,逻辑批次共有 个,则先用 加权该微批次的平均损失。
在所有微批次的反向传播之间保持参数不变,并在下一逻辑批次开始前清零。若实际损失按有效 token 或权重归一化, 和 应换成相应分母。含 BatchNorm 等依赖批次统计的模型,拆批后前向本身也可能发生变化。
下面比较长度为 1 和 2 的两个微批次,验证按样本数加权与一次求大批次平均的结果一致。
import torch

w = torch.tensor(2.0, requires_grad=True)
inputs = torch.tensor([1.0, 2.0, 3.0])
targets = torch.tensor([3.0, 5.0, 7.0])

((w * inputs - targets) ** 2).mean().backward()
expected = w.grad.detach().clone()
w.grad = None

for start, end in ((0, 1), (1, 3)):
    mean_loss = ((w * inputs[start:end] - targets[start:end]) ** 2).mean()
    (mean_loss * ((end - start) / len(inputs))).backward()

torch.testing.assert_close(w.grad, expected)
print(f"full={expected.item():.1f}, accumulated={w.grad.item():.1f}")
输出为 full=-4.0, accumulated=-4.0。optimizer.zero_grad(set_to_none=False) 会把已有梯度清为零张量;set_to_none=True 则设为 None,能更明确地区分“尚未产生梯度”和“梯度恰好为零”。优化器通常跳过梯度为 None 的参数,零梯度仍可能因动量或权重衰减而触发更新。
只清零部分参数会让其他参数继续累积,除非你正在实现冻结参数、分组更新或其他特殊优化策略,否则不应这样做。