
高等数学 / 系统课时
优化轨迹可视化
优化轨迹可视化
仅看最终损失无法解释优化器为什么快、为什么振荡或为什么绕路。本课在二维 Rosenbrock 函数上记录每一步参数位置,并用等高线叠加梯度下降、动量法和 Adam 的轨迹,形成可复现的比较方法。
学习目标
- 记录优化算法每一步的参数坐标并绘制下降轨迹
- 从路径长度、振荡幅度和到达区域比较不同算法
- 正确解读学习率、动量和自适应缩放对轨迹的影响
选择适合观察的目标函数
Rosenbrock 函数为
它的最优点是 ,最小值为 。函数包含弯曲而狭长的谷底:横穿谷底时梯度变化很快,沿谷底前进时变化较慢,因此很适合观察普通梯度下降的摆动、动量的惯性以及 Adam 的自适应步长。
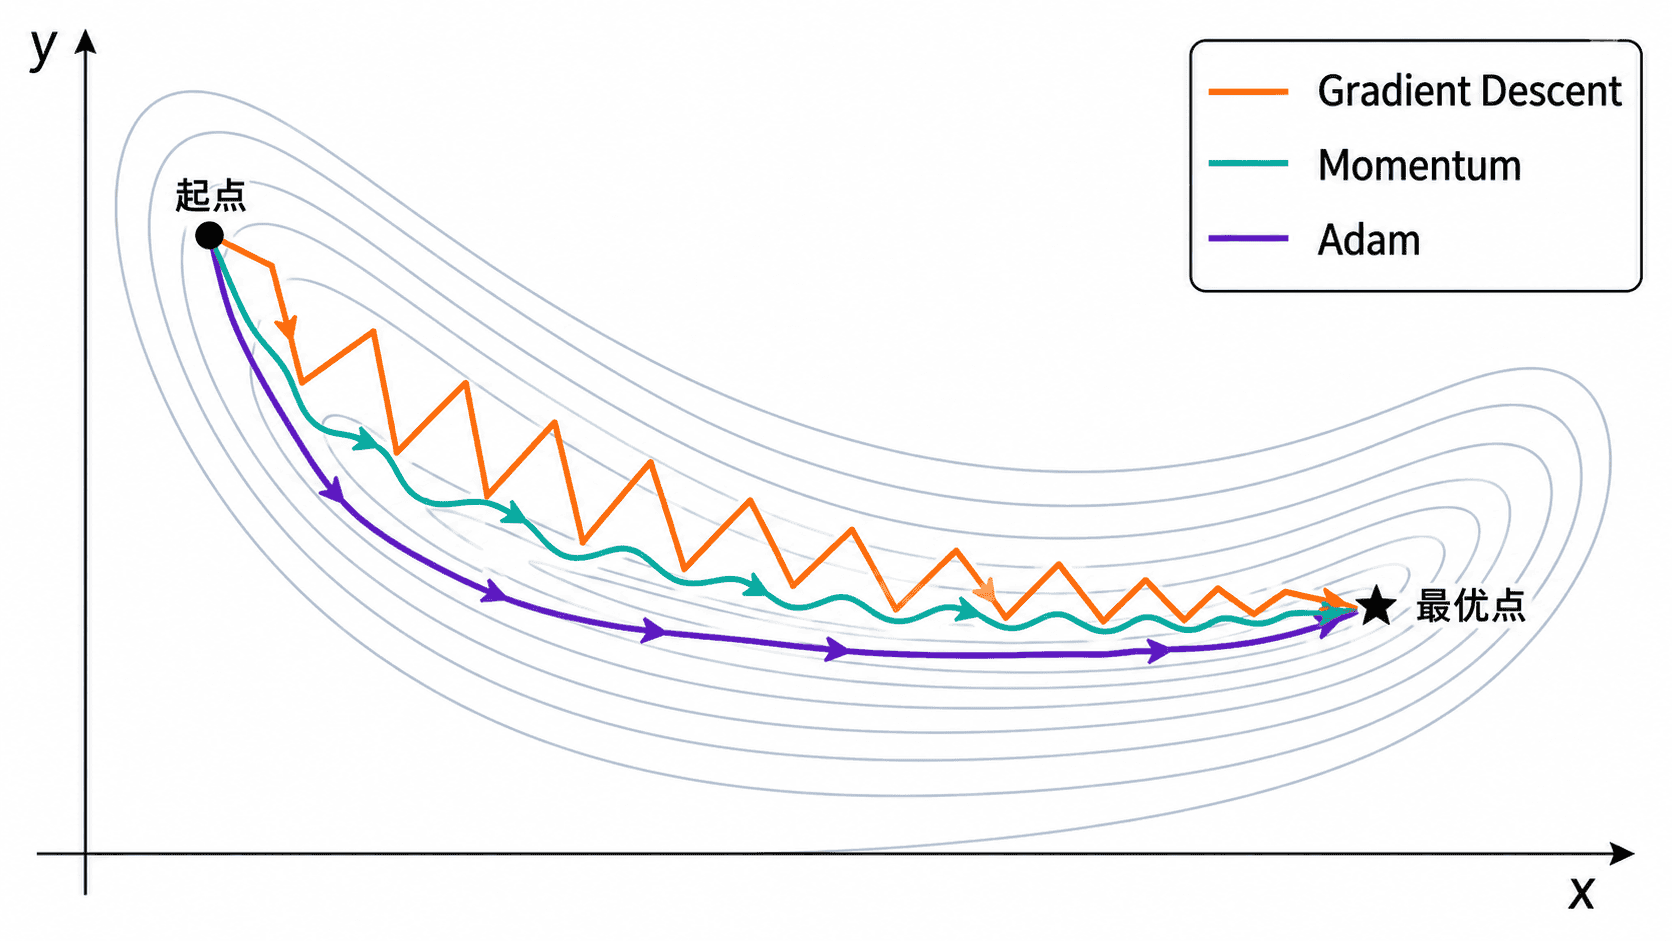
完整可运行示例
下面使用相同起点和相同步数运行三种算法,最后保存轨迹图。此处的动量变量是带 的梯度指数平均,与前课未归一化速度的学习率需要换算。不同算法采用各自适合的学习率,因此比较重点是轨迹形态和最终损失,而不是宣称某组参数在所有问题上都更优。
python
import numpy as np
import matplotlib.pyplot as plt

def loss(point):
    x, y = point
    return (1 - x) ** 2 + 100 * (y - x ** 2) ** 2

def gradient(point):
    x, y = point
    return np.array([
        -2 * (1 - x) - 400 * x * (y - x ** 2),
        200 * (y - x ** 2)
    ], dtype=float)

def run_gradient_descent(start, learning_rate, steps):
    point = np.array(start, dtype=float)
    path = [point.copy()]
    for _ in range(steps):
        point -= learning_rate * gradient(point)
        path.append(point.copy())
    return np.array(path)

def run_momentum(start, learning_rate, steps, beta=0.9):
    point = np.array(start, dtype=float)
    velocity = np.zeros(2)
    path = [point.copy()]
    for _ in range(steps):
        # 平滑连续梯度,减少横穿狭长谷底时的来回摆动
        velocity = beta * velocity + (1 - beta) * gradient(point)
        point -= learning_rate * velocity
        path.append(point.copy())
    return np.array(path)

def run_adam(start, learning_rate, steps, beta1=0.9, beta2=0.999, epsilon=1e-8):
    point = np.array(start, dtype=float)
    first_moment = np.zeros(2)
    second_moment = np.zeros(2)
    path = [point.copy()]

    for step in range(1, steps + 1):
        grad = gradient(point)
        first_moment = beta1 * first_moment + (1 - beta1) * grad
        second_moment = beta2 * second_moment + (1 - beta2) * (grad ** 2)

        # 偏差修正后按各坐标历史梯度尺度调整步长
        corrected_first = first_moment / (1 - beta1 ** step)
        corrected_second = second_moment / (1 - beta2 ** step)
        point -= learning_rate * corrected_first / (np.sqrt(corrected_second) + epsilon)
        path.append(point.copy())

    return np.array(path)

start = (-1.5, 1.5)
steps = 3000
paths = {
    'Gradient Descent': run_gradient_descent(start, 0.001, steps),
    'Momentum': run_momentum(start, 0.005, steps),
    'Adam': run_adam(start, 0.03, steps)
}

x = np.linspace(-2.0, 2.0, 500)
y = np.linspace(-1.0, 3.0, 500)
X, Y = np.meshgrid(x, y)
Z = (1 - X) ** 2 + 100 * (Y - X ** 2) ** 2

# 对数间隔等高线能同时展示高损失区和谷底附近
plt.contour(X, Y, Z, levels=np.logspace(-1, 3, 25))
for name, path in paths.items():
    plt.plot(path[::20, 0], path[::20, 1], marker='.', markersize=2, label=name)
    print(f'{name}: final_loss={loss(path[-1]):.6f}')

plt.scatter([start[0], 1.0], [start[1], 1.0], marker='x', s=70)
plt.xlabel('x')
plt.ylabel('y')
plt.title('Optimizer trajectories on Rosenbrock function')
plt.legend()
plt.savefig('rosenbrock_trajectories.png', dpi=150, bbox_inches='tight')
plt.close()
预期输出
text
Gradient Descent: final_loss=0.034565
Momentum: final_loss=0.000001
Adam: final_loss=0.000005
程序同时保存 rosenbrock_trajectories.png。每隔 20 步画一个点,因此个别来回摆动可能被稀疏采样隐藏,必要时可查看完整路径。图中等高线采用对数间隔,判断斜率时要同时看等高线标值。三个终值只对应这里的起点、步数和超参数。
如何比较轨迹
首先看是否进入正确盆地,再看路径是否稳定。轨迹频繁横穿谷底通常说明学习率相对当前曲率过大;轨迹前进很慢但方向稳定,可能说明学习率偏小;突然发散到图外,则应优先检查梯度公式、数值范围和步长。
其次不要只比较迭代次数。每一步算法的计算成本不同,实际项目还要同时记录耗时、最终损失和验证集指标。二维轨迹适合解释机制,但不能代替高维模型上的真实实验。
常见误读
轨迹更短不一定代表算法更好,因为较大的单步移动可能越过稳定区域。最终训练损失更低也不保证泛化更强。可视化的价值在于暴露振荡、绕行和步长失衡,再结合多次随机初始化与验证集结果做结论。
按自己的节奏,确认真正理解。