
高等数学 / 系统课时
比较多种优化器
比较多种优化器
本课在同一个狭长二次目标函数上实现梯度下降、动量法和 Adam。三种方法在同一目标上使用相同起点和停止条件,并记录各自的学习率、梯度调用次数及轨迹。
学习目标
- 理解三种优化器的参数更新差异
- 在统一实验条件下记录损失与参数轨迹
- 根据轨迹判断震荡、加速和自适应步长效果
实验设计
目标函数设为:
它在 方向比 方向陡峭得多,等高线呈狭长椭圆。所有优化器从 出发,并在 时停止。这样可以同时观察陡峭方向的震荡和缓平方向的收敛速度。
三种更新规则的核心区别是:梯度下降只使用当前梯度;动量法累积历史方向形成“惯性”;Adam 同时维护梯度的一阶矩与二阶矩,并对不同参数自适应缩放步长。本例分别使用 GD 学习率 、动量法 和 Adam 。这些是可复现实验配置,所得排名会随超参数改变。
完整实验代码
程序会输出每种方法的迭代次数、最终损失和参数,并把等高线与优化轨迹保存为 optimizer_paths.png。
import numpy as np
import matplotlib.pyplot as plt

def objective(theta: np.ndarray) -> float:
    x, y = theta
    return 0.5 * (x ** 2 + 100 * y ** 2)

def gradient(theta: np.ndarray) -> np.ndarray:
    return np.array([theta[0], 100 * theta[1]], dtype=float)

def optimize(name: str, start: np.ndarray) -> tuple[np.ndarray, int, float]:
    theta = np.array(start, dtype=float, copy=True)
    path = [theta.copy()]
    velocity = np.zeros_like(theta)
    first_moment = np.zeros_like(theta)
    second_moment = np.zeros_like(theta)

    for step in range(1, 2001):
        grad = gradient(theta)

        # 三种方法只替换参数更新规则,目标函数和起点保持一致
        if name == "GD":
            theta -= 0.01 * grad
        elif name == "Momentum":
            velocity = 0.9 * velocity + grad
            theta -= 0.005 * velocity
        elif name == "Adam":
            first_moment = 0.9 * first_moment + 0.1 * grad
            second_moment = 0.999 * second_moment + 0.001 * (grad ** 2)
            m_hat = first_moment / (1 - 0.9 ** step)
            v_hat = second_moment / (1 - 0.999 ** step)
            theta -= 0.3 * m_hat / (np.sqrt(v_hat) + 1e-8)
        else:
            raise ValueError(f"unknown optimizer: {name}")

        path.append(theta.copy())
        if objective(theta) < 1e-6:
            break

    return np.array(path), step, objective(theta)

def main() -> None:
    start = np.array([8.0, 8.0])
    results = {}

    for name in ("GD", "Momentum", "Adam"):
        path, steps, loss = optimize(name, start)
        results[name] = path
        print(
            f"{name:<8} grad_evals={steps:3d} reached={loss < 1e-6} "
            f"loss={loss:.6e} "
            f"theta=[{path[-1, 0]:.6f}, {path[-1, 1]:.6f}]"
        )

    # 等高线与轨迹共用同一坐标系,便于比较震荡和收敛速度
    axis = np.linspace(-9, 9, 300)
    grid_x, grid_y = np.meshgrid(axis, axis)
    grid_z = 0.5 * (grid_x ** 2 + 100 * grid_y ** 2)
    plt.contour(grid_x, grid_y, grid_z, levels=np.logspace(-2, 4, 18))

    for name, path in results.items():
        interval = max(1, len(path) // 15)
        plt.plot(path[:, 0], path[:, 1], marker="o", markevery=interval, label=name)

    plt.xlabel("x")
    plt.ylabel("y")
    plt.title("Optimizer trajectories")
    plt.legend()
    plt.tight_layout()
    plt.savefig("optimizer_paths.png", dpi=160)
    plt.close()
    print("saved=optimizer_paths.png")

if __name__ == "__main__":
    main()
预期输出:
GD       grad_evals=860 reached=True loss=9.946830e-07 theta=[0.001410, 0.000000]
Momentum grad_evals=167 reached=True loss=4.221376e-07 theta=[0.000504, -0.000077]
Adam     grad_evals=104 reached=True loss=1.547608e-08 theta=[0.000018, 0.000018]
saved=optimizer_paths.png
图像文件会生成在运行脚本的当前目录。在无图形界面的环境中,可设置环境变量 MPLBACKEND=Agg 后运行。reached 为假表示达到迭代上限时仍未满足损失阈值。
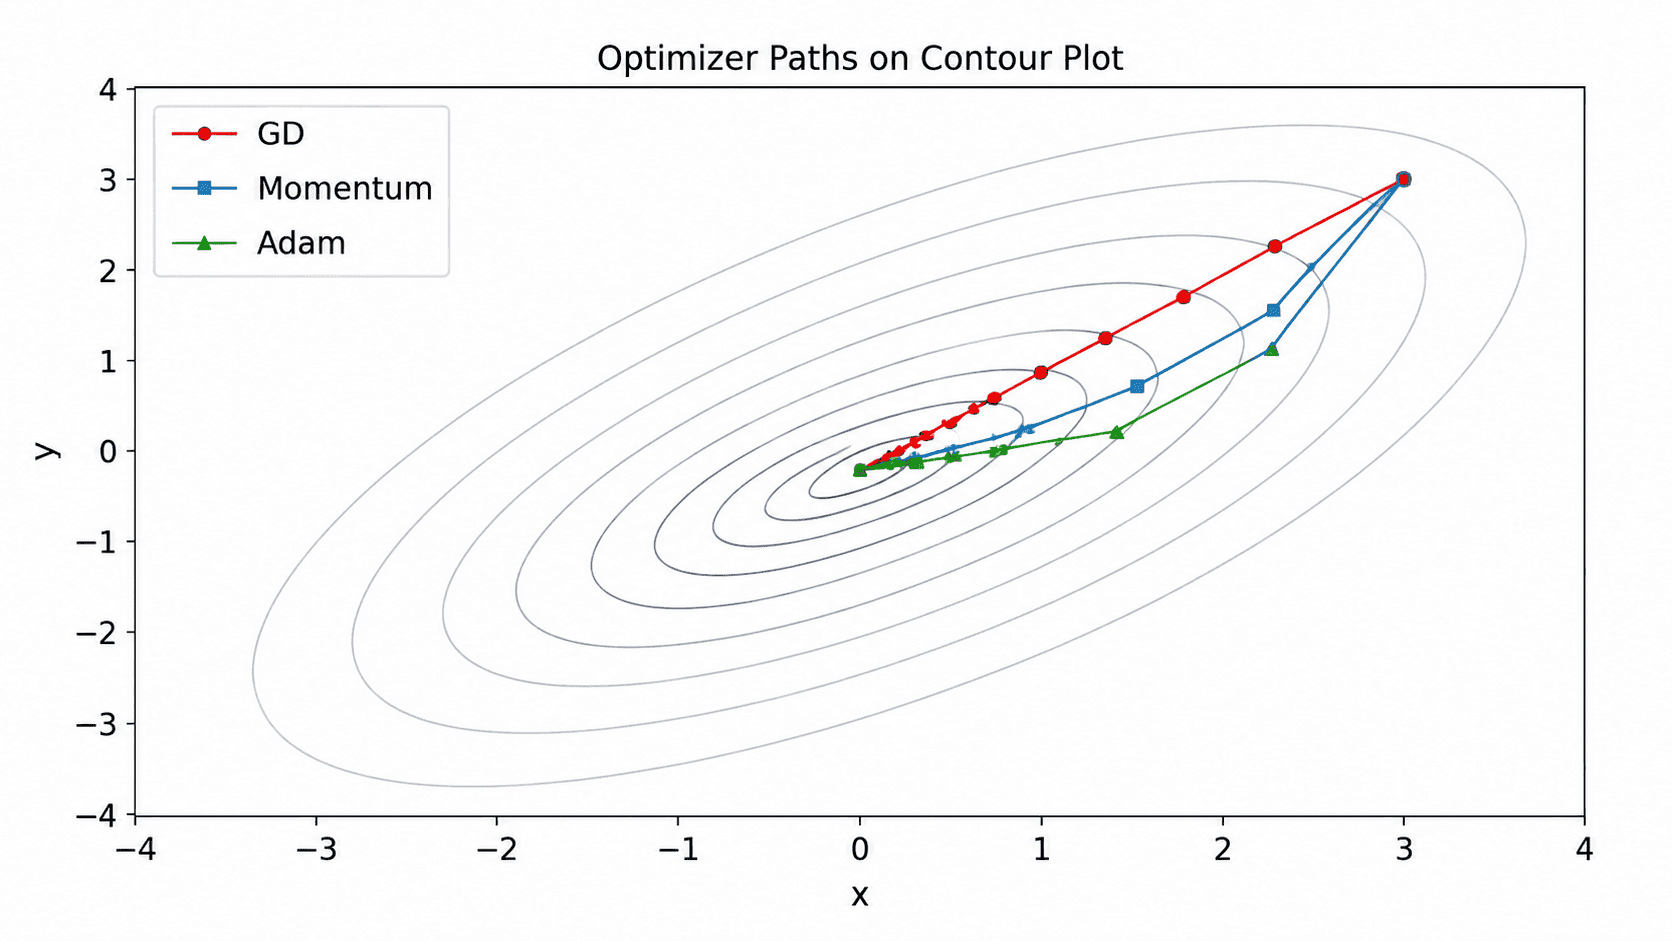
结果与轨迹解读
| 优化器 | 迭代次数 | 轨迹特征 | 本实验结论 |
|---|---|---|---|
| 梯度下降 | 860 | 陡峭方向快速压缩,缓平方向推进很慢 | 对病态曲率较敏感 |
| 动量法 | 167 | 早期存在摆动,但沿稳定方向积累速度 | 明显减少迭代次数 |
| Adam | 104 | 两个梯度分量分别归一化,轨迹近似沿对角线 | 本组参数下最先达到阈值 |
动量法并不是简单地放大学习率。历史梯度方向一致时,速度会持续累积;方向反复变化时,正负贡献会部分抵消。因此它常能减少狭长谷底中的横向震荡,同时加快主要方向的移动。
Adam 会分别修正一阶与二阶矩因零初始化产生的偏差。两个矩同时改变,更新比值的偏差方向不能只从一个矩推断。例如首步忽略 ,未修正的 约为修正值的 倍。本例首步两个梯度分别为 和 ,归一化后的位移绝对值都接近 。分母中的 防止除零,在二阶矩很小时也可能影响更新。
比较边界与调参原则
这次结果只说明“在当前函数、起点和超参数下”Adam 最快,不能推出 Adam 在所有任务上都优于其他方法。若要比较优化器本身,可固定数据、初始化、损失和评估预算,并为每种方法安排可比的调参预算。本例每步调用一次梯度,调用次数仍未包含 Adam 更新矩估计等额外成本。
若只比较最终损失,还可能忽略单步计算成本和泛化表现。工程实践中应同时记录训练时间、验证集指标、内存占用和多次随机运行的波动,再决定优化器,而不是仅凭一张轨迹图下结论。