
高等数学 / 系统课时
学习率
学习率
学习率决定每次参数更新跨出多远。它过小时训练缓慢,过大时会在低点两侧振荡甚至发散。本课用同一个二次函数对比不同学习率,并说明固定值与动态调度的使用边界。
学习目标
- 解释学习率与收敛速度、稳定性的关系
- 识别过小、合适和过大学习率的典型轨迹
- 掌握固定学习率与动态学习率的基本选择方法
学习率控制更新幅度
梯度下降更新为:
其中 是学习率,实际更新长度是 。以 为例,令误差 ,可得:
因此, 决定误差每轮缩小、变号还是放大。从非最优点出发, 时误差收缩。其中 保持误差符号, 一步到达最小点, 则逐步变号。 时等幅振荡, 时振幅逐步放大。这个数值范围不能直接照搬到其他函数,因为不同曲率对应不同稳定上限。
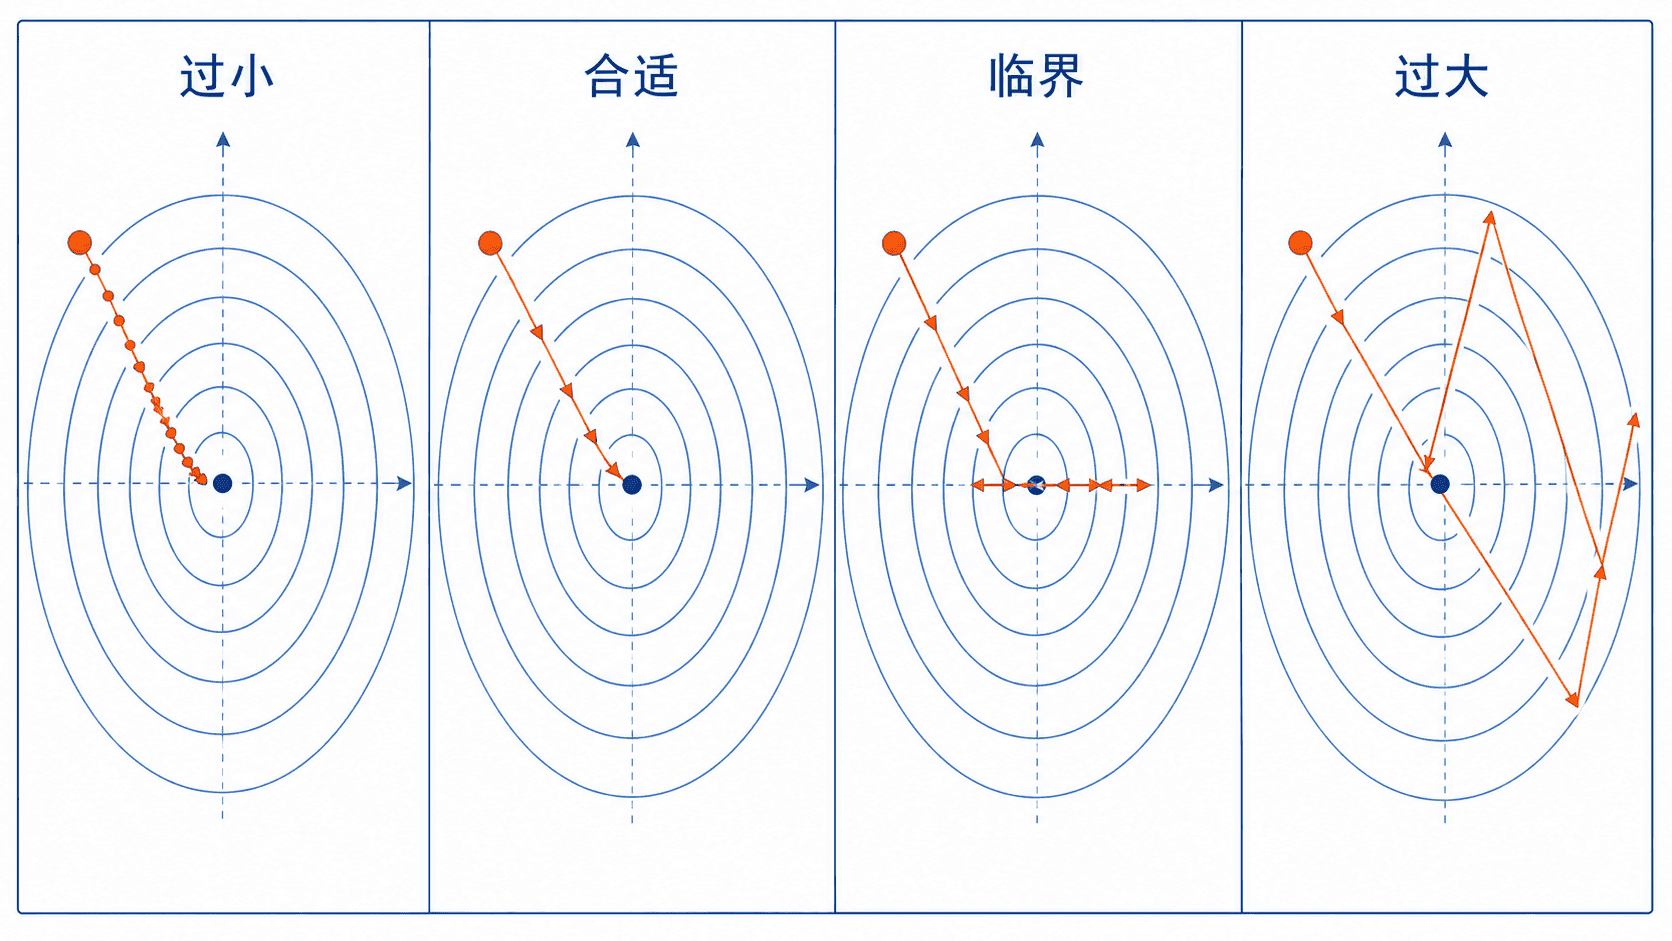
图中的关键不是“步子越大越快”,而是在不破坏稳定性的前提下尽量使用较大的有效步长。
三种典型训练表现
学习率过小时,损失通常稳定下降,但下降曲线很平,参数长时间停留在离最优点较远的位置。此时增加训练轮数可以改善结果,却会显著提高计算成本。
学习率合适时,损失在较少迭代内快速下降,并逐渐进入平稳区。学习率过大时,损失可能剧烈波动、突然变大,甚至出现数值溢出或非数值结果。
可运行对比
下面从相同初始值出发,对四个学习率各执行八轮更新,只比较最终参数和损失。
def optimize(learning_rate: float, steps: int = 8) -> tuple[float, float]:
    x = 9.0
    for _ in range(steps):
        grad = 2.0 * (x - 3.0)
        x -= learning_rate * grad
    return x, (x - 3.0) ** 2

for rate in (0.05, 0.4, 1.0, 1.1):
    x, value = optimize(rate)
    print(f"lr={rate:.2f}, x={x:.6f}, loss={value:.6f}")
预期输出
lr=0.05, x=5.582803, loss=6.670873
lr=0.40, x=3.000015, loss=0.000000
lr=1.00, x=9.000000, loss=36.000000
lr=1.10, x=28.798902, loss=665.583332
0.05 保持稳定但前进缓慢,0.40 很快接近极小点,1.00 在两个位置之间往返,1.10 则逐步远离目标。第二行的损失显示为零,同样是保留六位小数后的结果。
动态学习率为何有效
某些训练先用较大学习率加快推进,再降低学习率以减少最优区域附近的波动。调度也可以依据验证指标调整或先预热。对本课的确定性二次问题,合适的固定步长就能收敛。
常见策略包括分段衰减、指数衰减、余弦退火和根据验证指标降低学习率。预热则在训练最初几轮从小学习率逐步升高,常用于减轻大模型初始阶段的不稳定。自适应优化器会调整不同参数的有效步长,但仍需要合理设置基础学习率。
实用调参顺序
先用短训练观察损失曲线:若很快发散或大幅振荡,优先降低学习率;若曲线稳定却几乎不下降,可逐级增大学习率。找到能稳定快速下降的范围后,再决定是否加入衰减策略。
比较实验时应保持初始参数、数据批次、迭代次数和其他超参数一致,否则无法把差异归因于学习率。训练后期若在最优区域附近反复波动,可降低学习率,而不是单纯增加训练轮数。