
高等数学 / 系统课时
训练异常的数学诊断
训练异常的数学诊断
训练异常不能只靠观察损失是否下降。把损失曲线、梯度范数和参数更新幅度放在一起,才能区分学习率不合适、梯度消失、梯度爆炸、参数未更新和 NaN 等问题,并据此选择最小修复动作。
学习目标
- 计算并解释损失、梯度范数和参数更新比三个诊断量
- 根据指标组合判断不收敛、震荡、停滞和数值异常
- 按风险从低到高选择修复动作,并验证训练是否恢复稳定
同时观察三组指标
损失曲线描述目标是否改善,但它不能单独解释原因。梯度范数 反映反向信号强弱,参数更新比 反映一步更新相对参数规模的大小。
| 现象 | 损失曲线 | 梯度范数 | 更新比 | 优先怀疑 |
|---|---|---|---|---|
| 持续下降 | 一段时间内下降 | 有限 | 未出现突变 | 继续核对验证指标与训练目标 |
| 来回震荡 | 上下反复 | 中等或偏大 | 持续偏大 | 学习率过高 |
| 长期停滞 | 几乎不变 | 极小或缺失 | 极小 | 梯度衰减、未参与反向或被冻结 |
| 突然 NaN | 先正常后失真 | 突增或非有限 | 突增或非有限 | 溢出、非法运算或异常样本 |
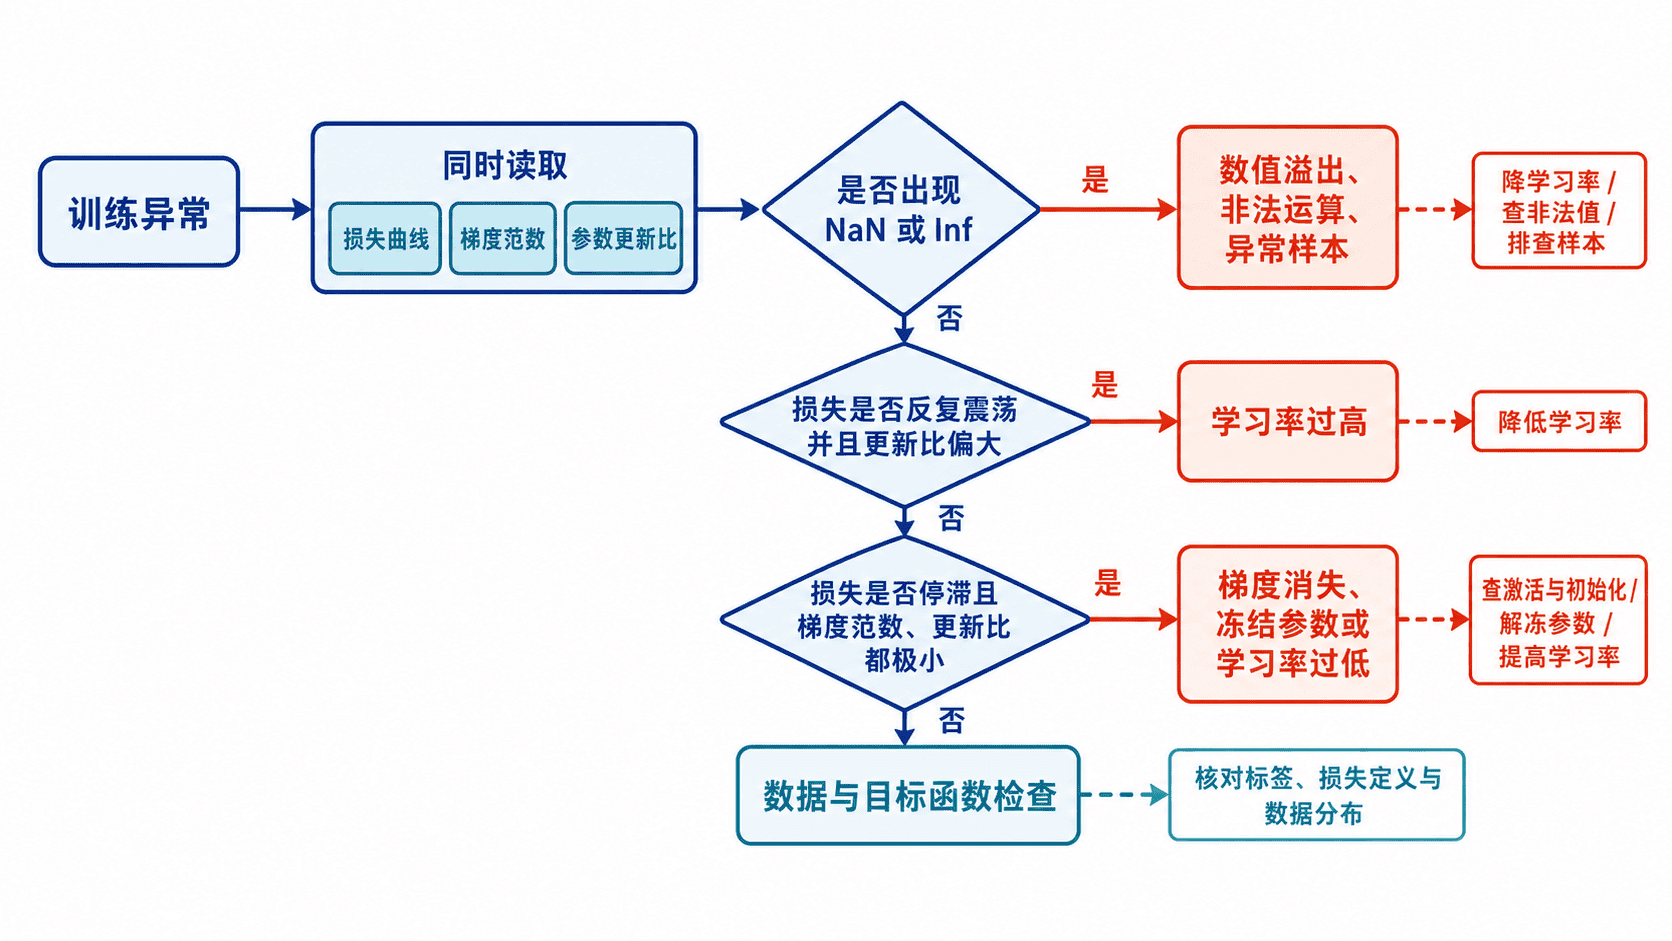
实际排查应优先记录每层指标,而不是只记录全模型平均值。全局范数正常时,某一层仍可能已经梯度消失或爆炸;分层统计能更早暴露问题位置。
计算并自动分类
下面的程序用一组可解释的阈值对训练日志做初步分类。阈值不是通用常数,而是用于建立排查起点;真实项目应结合模型规模、优化器和混合精度设置调整。
import math
from statistics import mean
from typing import List

def diagnose(
    losses: List[float],
    grad_norms: List[float],
    update_ratios: List[float],
) -> str:
    if not losses or len(losses) != len(grad_norms) or len(losses) != len(update_ratios):
        raise ValueError("metrics must be nonempty and aligned")
    values = losses + grad_norms + update_ratios

    # 非有限值优先级最高,继续训练通常只会扩大污染
    if not all(math.isfinite(value) for value in values):
        return "数值异常:出现 NaN 或 Inf"

    if any(value < 0 for value in grad_norms + update_ratios):
        raise ValueError("norms and ratios must be nonnegative")

    if max(grad_norms) > 100 or max(update_ratios) > 0.5:
        return "梯度爆炸或学习率过大"

    if len(losses) < 3:
        return "记录不足:需要更多训练步"

    # 只按最近的窗口检测振荡,避免将历史变化归给当前状态
    recent = losses[-4:]
    diffs = [after - before for before, after in zip(recent, recent[1:])]
    sign_changes = sum((a < 0 < b) or (b < 0 < a)
                       for a, b in zip(diffs, diffs[1:]))
    scale = max(abs(loss) for loss in recent)
    if sign_changes >= 2 and max(recent) - min(recent) > 0.2 * scale:
        return "震荡:核对学习率与批次差异"

    if mean(grad_norms[-3:]) < 1e-8 or mean(update_ratios[-3:]) < 1e-8:
        return "停滞:检查梯度消失、冻结参数或学习率过小"

    if losses[0] - losses[-1] > 0.3 * abs(losses[0]):
        return "损失下降:继续核对验证指标"

    return "下降过慢或未收敛"

def main() -> None:
    cases = {
        "stable": (
            [2.0, 1.5, 1.1, 0.8, 0.6],
            [1.2, 0.9, 0.6, 0.4, 0.3],
            [0.05, 0.04, 0.03, 0.02, 0.015],
        ),
        "oscillating": (
            [2.0, 1.0, 1.6, 0.9, 1.5],
            [2.0, 2.4, 2.1, 2.5, 2.2],
            [0.12, 0.15, 0.13, 0.16, 0.14],
        ),
        "stalled": (
            [1.0, 0.9999, 0.9998, 0.9998, 0.9998],
            [1e-10, 1e-10, 1e-10, 1e-10, 1e-10],
            [1e-12, 1e-12, 1e-12, 1e-12, 1e-12],
        ),
        "nan_case": (
            [2.0, 1.2, float("nan")],
            [1.0, 20.0, float("inf")],
            [0.03, 0.2, float("nan")],
        ),
    }

    for name, metrics in cases.items():
        print(f"{name}: {diagnose(*metrics)}")

if __name__ == "__main__":
    main()
预期输出
stable: 损失下降:继续核对验证指标
oscillating: 震荡:核对学习率与批次差异
stalled: 停滞:检查梯度消失、冻结参数或学习率过小
nan_case: 数值异常:出现 NaN 或 Inf
这段分类器适合处理已采集的训练日志,不应直接替代人工判断。比较时要确认各日志值采自同一批训练步。记录梯度范数时注明在解缩放之后、裁剪之前还是之后;参数更新比则使用优化器实际更新前后的差。示例的判定依赖损失定义和尺度,只能提示排查方向。
从指标组合定位根因
损失震荡且更新比长期偏大时,优先降低学习率,并检查批量是否过小。梯度范数突然增大后出现 NaN,通常应检查除零、对数负值、指数溢出、异常样本和混合精度缩放,而不是只增加训练轮数。
损失停滞、梯度极小且更新比极小时,应检查激活饱和、过深链路、参数被冻结、优化器未持有目标参数以及学习率过低。若梯度正常但更新比接近零,检查学习率、优化器是否持有该参数、更新是否执行,以及 AMP 是否因非有限梯度跳过了该步。参数初始范数接近零时,更新比会对分母很敏感,应同时记录绝对更新范数。
按最小改动修复并验收
修复顺序应从可逆、低风险动作开始:固定同一批数据复现;检查输入与损失是否有限;降低学习率;确认参数参与优化;必要时启用梯度裁剪或更稳定的损失实现。梯度裁剪只能限制结果,不能替代对爆炸根因的定位。
验收时使用相同随机种子和相同数据运行一段短训练,确认损失重新呈下降趋势、各层梯度范数保持有限、参数更新比没有突增或归零。动态时间、步数和设备差异会导致具体日志不同,因此应比较趋势与数量级,而不是逐字符比较输出。