
高等数学 / 系统课时
线性回归损失函数
线性回归损失函数
线性回归不仅要给出预测直线,还要用一个可优化的标量衡量预测好坏。本课从均方误差出发,推导权重与偏置的梯度,并通过一次梯度下降观察参数如何沿损失曲面快速接近最优点。
学习目标
- 建立线性回归的均方误差目标函数
- 推导权重和偏置对应的梯度公式
- 解释损失曲面的形状及其对优化的影响
从预测误差到目标函数
对单特征样本,模型写成 。预测值与真实值之差记为残差 。为了让正负残差不会相互抵消,并让较大误差受到更强惩罚,可以对残差平方后取平均:
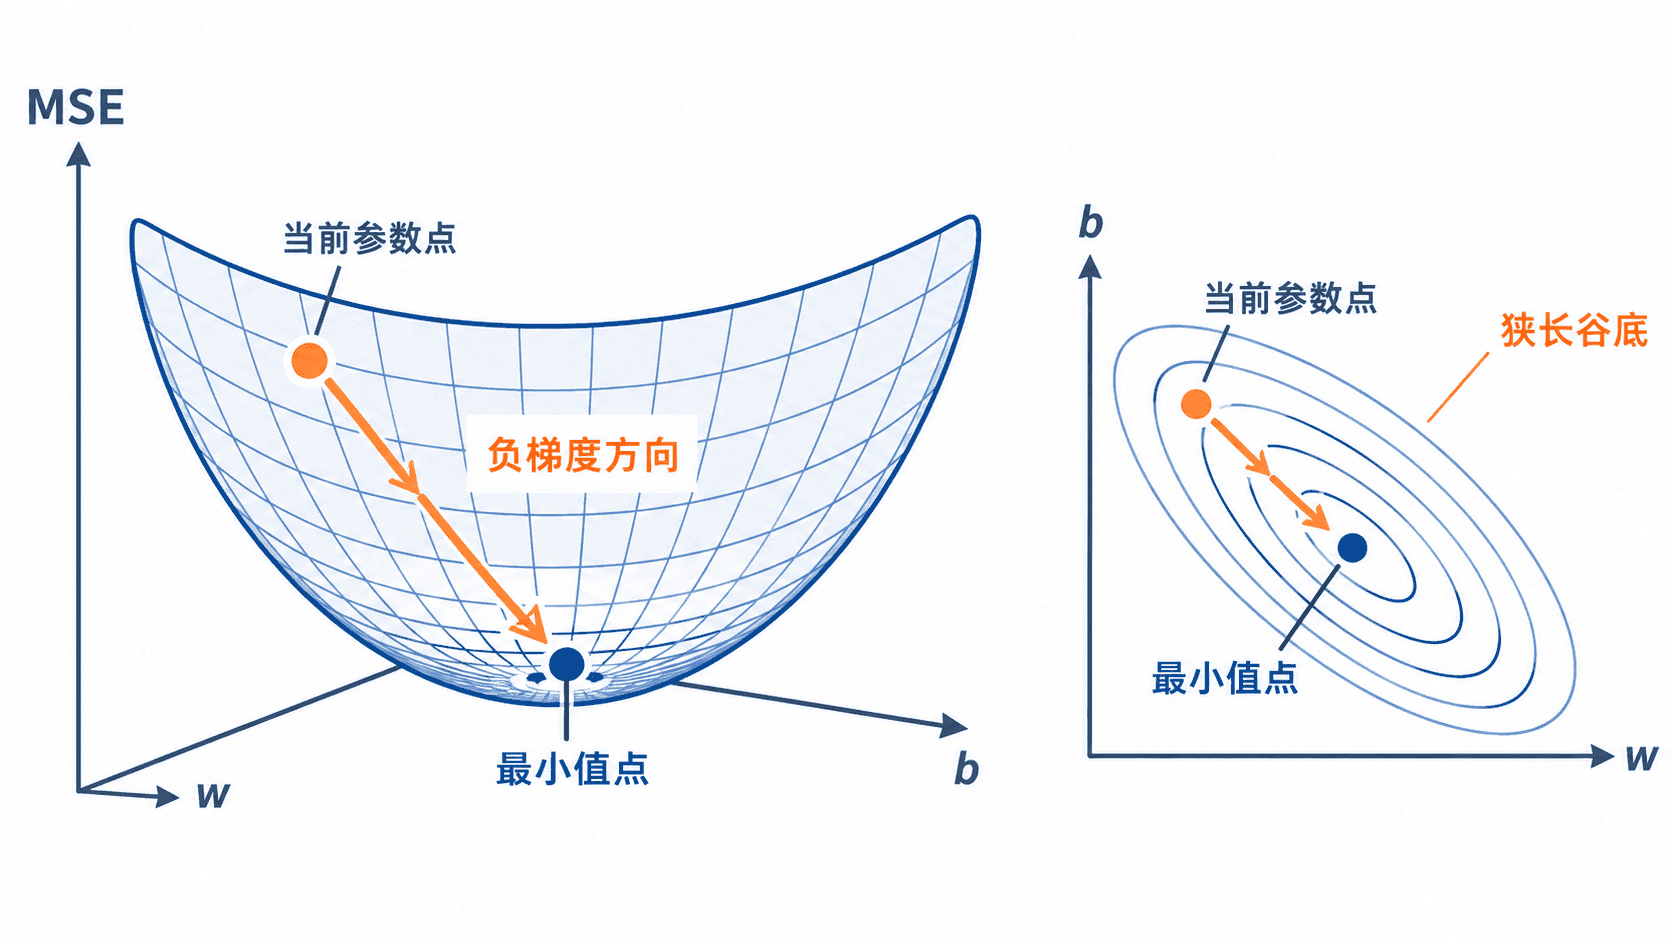
这个函数就是均方误差,简称 MSE。训练线性回归,本质上是在所有可能的 和 中,寻找使 最小的一组参数。
梯度如何得到
令 ,对目标函数分别求偏导:
当梯度非零时,负梯度给出欧氏距离下的一阶最速下降方向。权重与偏置都用更新前的同一组参数计算梯度。学习率记为 ,一次更新为 、。梯度的欧氏范数是该点最大的单位方向变化率。
用一次梯度下降验证
下面使用三个样本,从 、 出发计算梯度,并完成一次参数更新。
python
import numpy as np

x = np.array([1.0, 2.0, 3.0])
y = np.array([2.0, 4.0, 6.0])

def mse(weight: float, bias: float) -> float:
    prediction = weight * x + bias
    return float(np.mean((prediction - y) ** 2))

w, b = 1.0, 0.0
prediction = w * x + b
error = prediction - y

# MSE 对权重和偏置的解析梯度
grad_w = 2.0 * np.mean(error * x)
grad_b = 2.0 * np.mean(error)

print(f'initial loss: {mse(w, b):.4f}')
print(f'grad_w: {grad_w:.4f}')
print(f'grad_b: {grad_b:.4f}')

learning_rate = 0.1
w -= learning_rate * grad_w
b -= learning_rate * grad_b

# 更新后重新计算损失,验证下降方向是否正确
print(f'updated w: {w:.4f}')
print(f'updated b: {b:.4f}')
print(f'updated loss: {mse(w, b):.4f}')
预期输出:
text
initial loss: 4.6667
grad_w: -9.3333
grad_b: -4.0000
updated w: 1.9333
updated b: 0.4000
updated loss: 0.0741
在这组数据、起点和步长下,损失从 降到 。单次下降可用于核对示例,完整收敛还要看目标和步长。这里的数据满足 ,继续迭代时参数会逐渐靠近 、。
损失曲面的形状
把特征列和偏置对应的全 1 列组成设计矩阵 。MSE 的 Hessian 为 ,总是半正定,因此目标凸。 满列秩时 Hessian 正定,最优参数唯一。秩不足时,可沿 的零空间改变参数,训练预测和损失都保持不变。例如所有样本的 都等于同一个常数时,训练数据只能约束 的组合。
特征尺度差异还会让等高线被拉长。此时同一个学习率可能在陡峭方向反复震荡,却在平缓方向前进缓慢。对单特征且有截距的模型,中心化会消除两列的交叉项,缩放可以调整两方向曲率。多特征标准化可以缓解量纲差异,但强相关仍可能造成狭长谷底。
常见误区与边界
- 在 MSE 前乘 只会消去求导后的系数 2,不会改变最优参数。
- MSE 对离群点敏感,因为误差会被平方;异常值较多时可考虑绝对误差或 Huber 损失。
- 梯度为零不代表所有问题都已解决,还应检查特征共线性、数据覆盖范围和泛化误差。
按自己的节奏,确认真正理解。