
高等数学 / 系统课时
实现微型自动微分引擎
实现微型自动微分引擎
本课从零实现一个只处理标量的自动微分引擎:先用对象记录计算图,再按拓扑顺序执行反向传播,最终得到每个输入变量的梯度。完成后,你将拥有一个可运行、可验证的最小反向传播核心。
学习目标
- 用计算节点保存数值、梯度和父节点关系
- 理解拓扑排序为何是反向传播的前提
- 实现加法、乘法和幂运算的局部梯度规则
先确定最小功能
微型引擎只需要一个 Value 类。每个实例既保存当前标量值,也保存由哪次运算、哪些父节点生成。运算发生时创建新节点,并把对应的局部反向函数绑定到该节点。
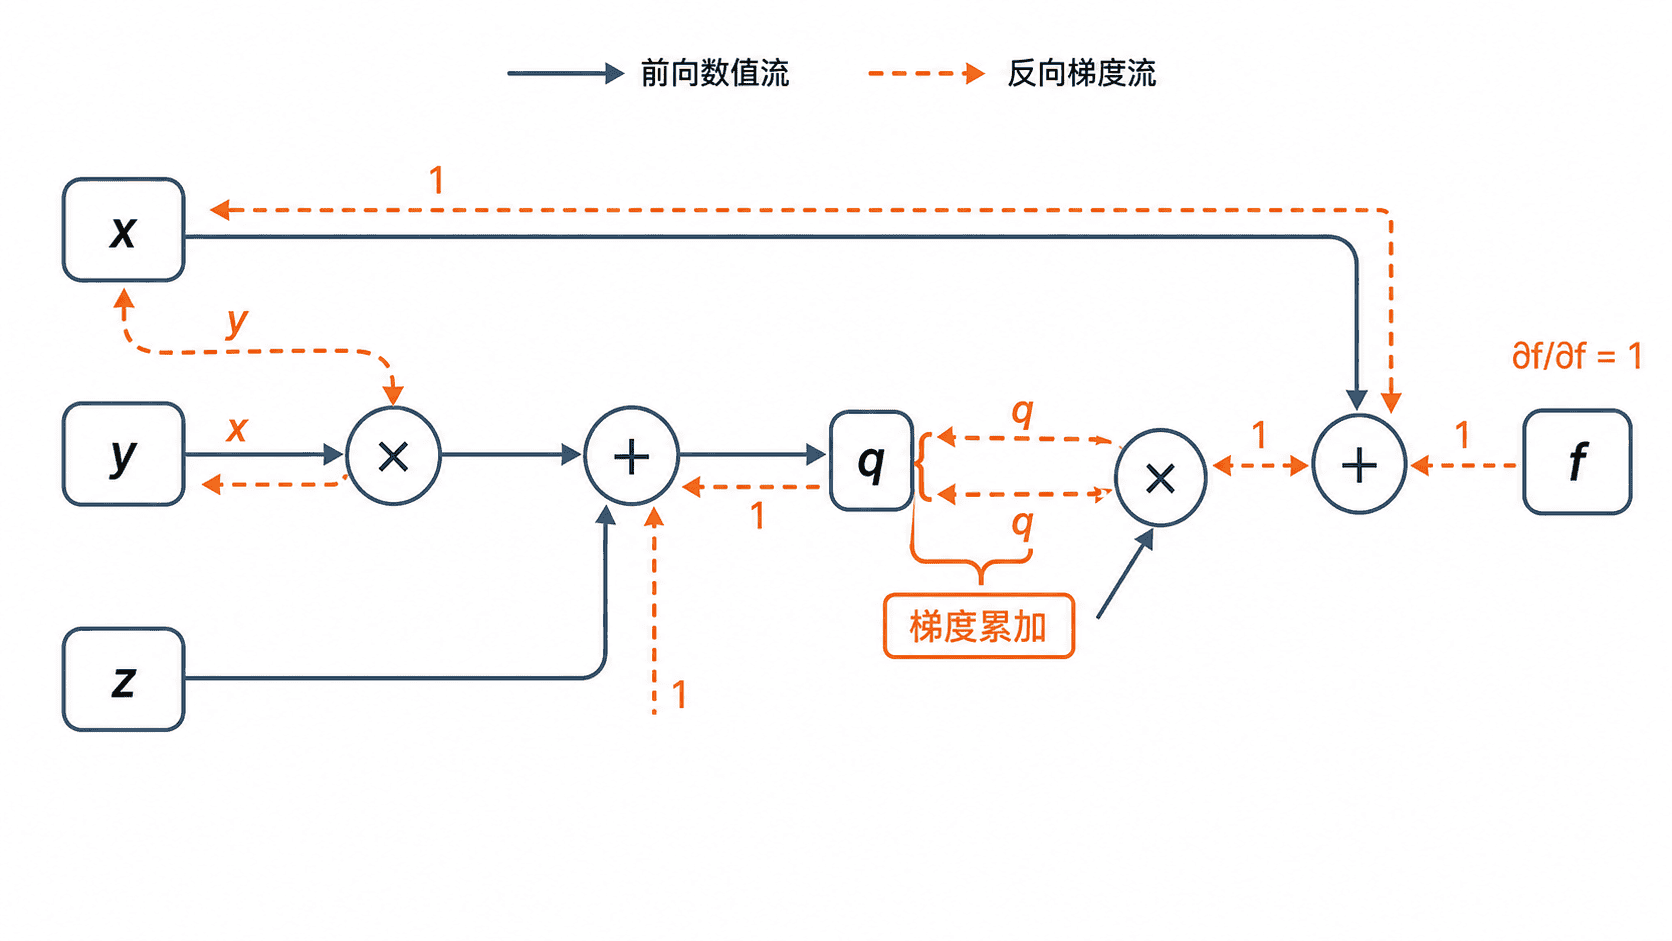
例如 、 会形成一张有向无环图。前向阶段从输入计算到输出;反向阶段则从 f.grad = 1 开始,沿相反方向累计梯度。
编写可运行的引擎
下面的完整程序实现加法、乘法、幂运算和反向传播。每个运算只负责定义自己的局部导数,backward 方法负责按拓扑逆序统一执行。
python
from __future__ import annotations

from typing import Callable

class Value:
    def __init__(
        self,
        data: float,
        children: tuple[Value, ...] = (),
        op: str = '',
    ) -> None:
        self.data = float(data)
        self.grad = 0.0
        self.prev = children
        self.op = op
        self._backward: Callable[[], None] = lambda: None

    def __add__(self, other: Value | float) -> Value:
        other = other if isinstance(other, Value) else Value(other)
        out = Value(self.data + other.data, (self, other), '+')

        def _backward() -> None:
            # 加法对两个输入的局部导数都为 1
            self.grad += out.grad
            other.grad += out.grad

        out._backward = _backward
        return out

    def __radd__(self, other: float) -> Value:
        return self + other

    def __mul__(self, other: Value | float) -> Value:
        other = other if isinstance(other, Value) else Value(other)
        out = Value(self.data * other.data, (self, other), '*')

        def _backward() -> None:
            # 使用 +=,确保共享节点收到的多路梯度能够累加
            self.grad += other.data * out.grad
            other.grad += self.data * out.grad

        out._backward = _backward
        return out

    def __rmul__(self, other: float) -> Value:
        return self * other

    def __pow__(self, exponent: float) -> Value:
        exponent = float(exponent)
        if self.data <= 0 and not exponent.is_integer():
            raise ValueError("此实现要求非整数指数的底数为正")
        if self.data == 0 and exponent < 0:
            raise ValueError("零底数不能取负指数")
        out = Value(self.data**exponent, (self,), f'**{exponent}')

        def _backward() -> None:
            # 零次幂按常函数 1 处理,避免在零底数处计算 0**(-1)
            local_grad = 0.0 if exponent == 0 else exponent * self.data ** (exponent - 1)
            self.grad += local_grad * out.grad

        out._backward = _backward
        return out

    def backward(self) -> None:
        topo: list[Value] = []
        visited: set[Value] = set()

        def build(node: Value) -> None:
            if node in visited:
                return
            visited.add(node)
            for parent in node.prev:
                build(parent)
            topo.append(node)

        build(self)
        for node in topo:
            node.grad = 0.0
        self.grad = 1.0

        # 逆拓扑顺序保证节点先收到全部上游梯度,再向父节点传播
        for node in reversed(topo):
            node._backward()

def main() -> None:
    x = Value(2.0)
    y = Value(-3.0)
    z = Value(10.0)

    q = x * y + z
    f = q * q + x
    f.backward()

    print(f'f = {f.data}')
    print(f'x.grad = {x.grad}')
    print(f'y.grad = {y.grad}')
    print(f'z.grad = {z.grad}')

if __name__ == '__main__':
    main()
预期输出:
text
f = 18.0
x.grad = -23.0
y.grad = 16.0
z.grad = 8.0
反向传播为何需要拓扑逆序
计算图中,一个节点可能被多个后续运算共同使用。只有当这些分支都把梯度传回后,该节点才拥有完整的总梯度。因此,程序先用深度优先搜索生成“父节点在前、输出节点在后”的拓扑序列,再反向遍历。
以 q * q 为例,q 同时作为乘法的左右输入。乘法节点会向同一个 q.grad 写入两次贡献,所以实现必须使用 +=,不能直接赋值。这个细节正是链式法则在计算图中的梯度汇合。
检查结果是否正确
由 、 可得,。继续沿图传播,,,,与程序输出完全一致。
工程中还可以使用有限差分做数值校验:将某个输入增加很小的量,再比较输出变化率与反向传播梯度。两者接近时,通常说明局部梯度规则和拓扑执行顺序正确。
当前实现的边界
这个引擎用于理解原理,而不是替代成熟框架。它只支持标量,没有张量形状、广播、设备管理和高性能算子;每次反传会先清零当前图的伴随量。该实现接受有限实数值,对非整数指数只开放正底数。构图后请保持节点值不变,深图也要留意递归栈上限。继续扩展时,可以依次加入减法、除法、激活函数、参数集合和梯度下降器。
按自己的节奏,确认真正理解。