
高等数学 / 系统课时
指数函数与对数函数
指数函数与对数函数
指数函数擅长描述成倍增长,对数函数擅长把乘法关系压缩成加法关系。掌握二者的互逆性质后,可以更自然地理解概率、Softmax、交叉熵,以及大数指数运算中的数值稳定处理。
学习目标
- 掌握指数函数、对数函数的定义域、单调性和互逆关系
- 理解 Softmax 与交叉熵中指数、对数各自承担的作用
- 能使用减去最大值和 LogSumExp 技巧避免数值溢出
指数与对数在解决什么问题
指数函数的一般形式是 ,其中 且 。当 时,函数随 增大而快速增长;当 时,函数随 增大而衰减。它适合表示复利、概率权重、衰减系数和连续增长过程。
对数函数 是指数函数的反函数,只对 有定义。它求的是满足 的实数指数 。对数能把乘法变成加法,因此长概率乘积通常会改写成对数和,既便于推导,也更适合计算机处理。
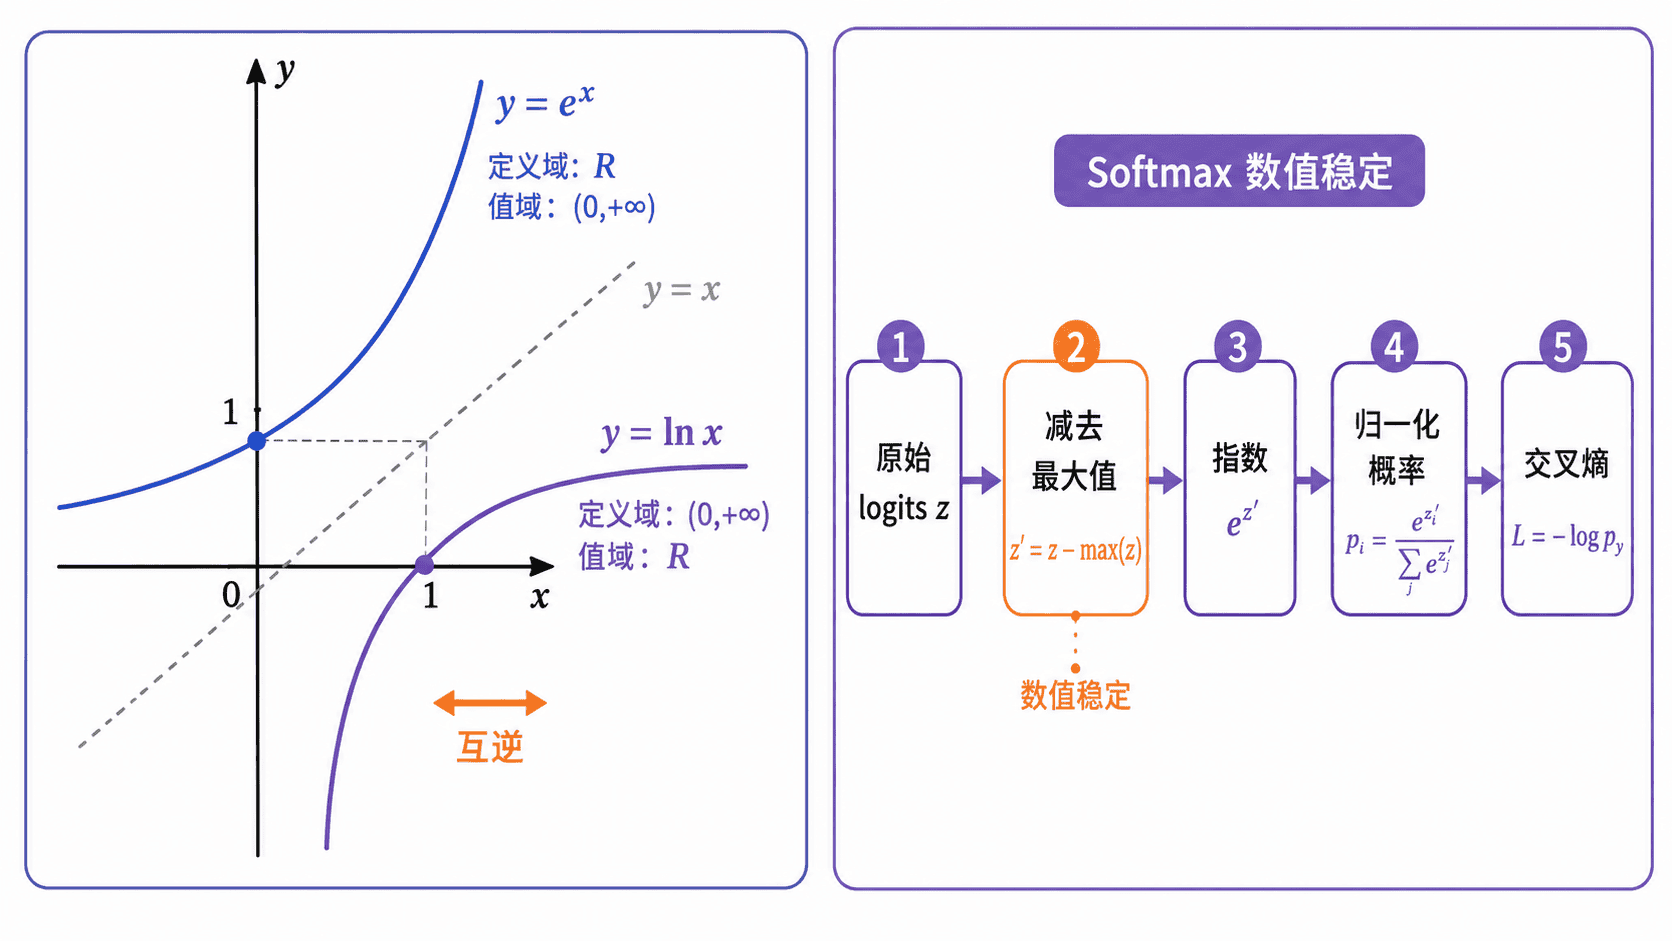
互逆关系与常用运算规则
当 且 时, 对 成立,而 对所有实数 成立。在实际计算中,最常用的是自然指数 和自然对数 。它们的导数仍保持简洁:,,因此在优化和概率模型中非常常见。
对数的三条核心规则是:
这些规则要求参与对数运算的真数为正。尤其不能把 拆成 ,这是常见误用。
Softmax 与交叉熵中的分工
设模型输出 logits 为 ,Softmax 将任意实数转换为概率:
指数严格递增,因此较大的 logit 分配到较大的概率。对有限实数 logits,精确算术中的概率均为正且总和为 1。若真实类别为 ,单样本交叉熵为 。对数会强烈惩罚模型对真实类别给出的极小概率,而高概率对应较小损失。
数值稳定:先平移再计算
直接计算 会溢出,但 Softmax 对所有 logits 同时减去同一个常数后结果不变。通常取 ,将指数改写为 。此时最大的指数为 1,其余值不超过 1。
减去最大值能防止指数上溢,但很小的概率仍可能下溢为零。把 代入 后,可直接计算 。这样即使浮点 Softmax 把目标概率存为零,损失也无需对零取对数。平移后再做减法还避免先加回很大的 、再减去 时丢失小的差值。
下例使用 Python 标准库,输入是非空的有限实数列表和有效的类别下标。
import math


def softmax_and_loss(logits, target_index):
    maximum = max(logits)
    shifted = [value - maximum for value in logits]
    weights = [math.exp(value) for value in shifted]
    normalizer = math.fsum(weights)
    probabilities = [weight / normalizer for weight in weights]
    loss = math.log(normalizer) - shifted[target_index]
    return probabilities, loss


for logits, target in (
    ([1000.0, 1001.0, 999.0], 1),
    ([1000.0, 0.0], 1),
    ([1e16, 1e16], 0),
):
    probabilities, loss = softmax_and_loss(logits, target)
    print([round(value, 6) for value in probabilities], round(loss, 6))
预期输出如下。
[0.244728, 0.665241, 0.090031] 0.407606
[1.0, 0.0] 1000.0
[0.5, 0.5] 0.693147
第二组输入中目标类概率下溢为 ,损失仍为约 。第三组展示两个相等的 logits 共享一个很大的偏移量,交叉熵仍为 。框架自带的交叉熵通常直接接收 logits,训练时可用框架实现。
若只需要计算 ,可使用 LogSumExp:
它与稳定 Softmax 使用同一思想,是概率模型和深度学习框架中的基础数值技巧。